Clasifică riscul de credit cu Rimay Quantum Feature Extraction de la Kipu Quantum
Qiskit Functions sunt o funcționalitate experimentală disponibilă doar utilizatorilor planurilor IBM Quantum® Premium Plan, Flex Plan și On-Prem (prin IBM Quantum Platform API) Plan. Se află în stadiul de versiune preview și pot fi modificate.
Estimare de utilizare: 2 minute pe un procesor Nighthawk r2. (NOTĂ: Aceasta este doar o estimare. Timpul tău de rulare poate varia.)
Obiective de învățare
-
Pregătește date tabulare cu coloane categorice și numerice pentru Qiskit Function Rimay.
-
Potrivește o mapare cuantică a caracteristicilor pe datele de antrenare și mapează datele de test în aceeași rulare.
-
Antrenează modele clasice pe caracteristici transformate cuantic, singure și combinate cu caracteristicile originale.
-
Compară rezultatele cu o referință pur clasică.
Cerințe preliminare
Înainte de a începe acest tutorial, ar trebui să fii familiarizat cu următoarele subiecte:
-
Clasificare supervizată cu scikit-learn
Context
Multe probleme de învățare automată din industrie implică seturi de date tabulare mici sau medii, în care adăugarea de mai multe date nu este o opțiune, iar acuratețea modelului stagnează. Scorarea riscului de credit este un exemplu tipic. Un creditor folosește câteva zeci de atribute pentru a decide dacă solicitantul va rambursa probabil creditul.
Rimay, o Qiskit Function de la Kipu Quantum, adaugă un pas de preprocesare cuantică într-un astfel de flux de lucru. Implementează algoritmul de extragere cuantică a trăsăturilor cu contradiabaticitate digitizată [1]. Fiecare trăsătură de intrare este mapată pe un qubit. Valorile trăsăturilor și informația mutuală dintre trăsături stabilesc câmpurile locale și cuplajele unui hamiltonian de tip spin-glass. Dinamica contradiabatică face apoi sistemul cuantic să evolueze spre stările sale de energie joasă, iar valorile medii cu unul și cu doi corpuri măsurate la final devin noile trăsături transformate cuantic. Aceste trăsături surprind corelații neliniare între intrări și le poți introduce în orice model clasic.
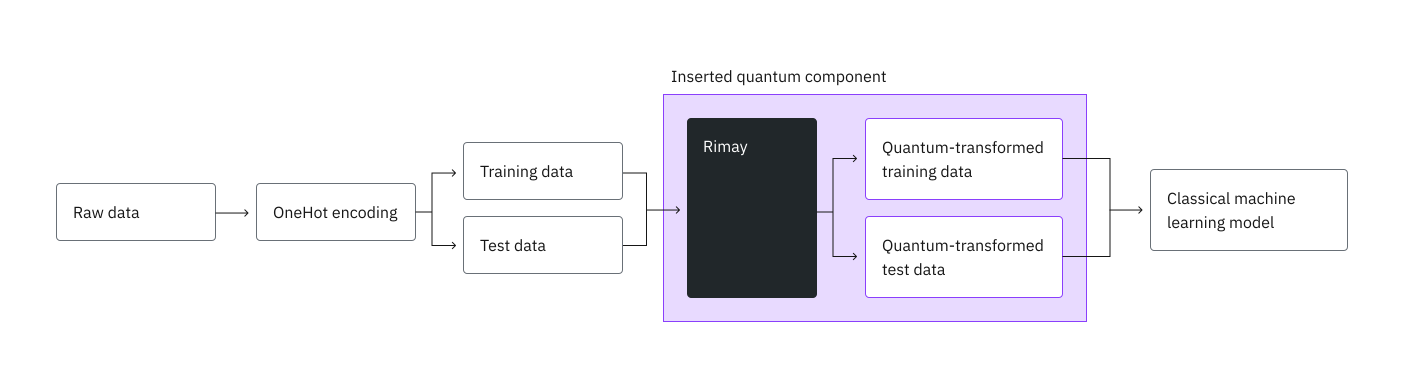
Acest tutorial folosește setul de date German credit din OpenML [2], cu 1000 de solicitanți și 20 de atribute, pentru a antrena un clasificator random forest. Mai întâi stabilești o referință clasică, apoi trimiți datele către Rimay și, în final, antrenezi același tip de model pe trăsăturile transformate cuantic, singure și combinate cu trăsăturile originale.
Cerințe
Înainte de a începe acest tutorial, asigură-te că ai instalate următoarele pachete:
-
Clientul IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Ai nevoie, de asemenea, de acces la funcția Rimay din Qiskit Functions Catalog.
Configurare
Importă pachetele și definește două funcții ajutătoare: una care antrenează un random forest și una care calculează metricile folosite în tot tutorialul.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Configurează acreditările IBM Quantum
Autentifică-te cu cheia API IBM Quantum Platform, încarcă funcția Rimay și selectează procesorul cuantic cel mai puțin ocupat disponibil în instanța ta.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Pasul 1: Mapează intrările clasice la o problemă cuantică
Rimay mapează fiecare trăsătură numerică de intrare pe un qubit, așa că primul pas este să transformi tabelul brut în trăsături numerice.
Încarcă setul de date
Încarcă setul de date German credit direct din OpenML. Coloana class conține eticheta: good pentru solicitanții care și-au rambursat creditul și bad pentru cei care nu l-au rambursat.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Codifică trăsăturile
Convertește eticheta într-o valoare binară și codifică one-hot cele 13 coloane categoriale. Codul elimină prima categorie din fiecare coloană pentru a evita trăsăturile redundante, ceea ce are ca rezultat 48 de trăsături numerice.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Împarte în seturi de antrenare și de test
Păstrează 20% dintre solicitanți ca set de test. O împărțire stratificată menține egală în ambele seturi proporția de credite bune și rele.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Stabilește o referință clasică
Antrenează un random forest pe trăsăturile clasice. La Pasul 4, compari trăsăturile transformate cuantic cu metricile acestuia.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Încarcă datele în Rimay
Rimay citește intrările din fișiere CSV pe care le încarci în funcție. Trăsăturile și etichetele merg în fișiere separate. Încarci și setul de test, astfel încât Rimay să îl mapeze cu aceeași mapare pe care o ajustează pe setul de antrenare.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Pasul 2: Optimizează problema pentru execuția pe hardware cuantic
Rimay construiește și transpilează circuitele pentru procesorul selectat, deci nu există niciun circuit de optimizat manual. Specifică numărul de shot-uri per circuit, respectând următoarele constrângeri:
-
Fiecare trăsătură necesită un qubit, așa că procesorul trebuie să aibă cel puțin tot atâția qubiți câte trăsături are setul de date.
-
Rimay rulează un circuit pe rând, rândurile de antrenare și de test împreună. Un singur job poate cere cel mult 10 milioane de execuții, deci numărul de rânduri înmulțit cu
shotstrebuie să rămână în limita acestui buget.
Verifică ambele limite înainte de a trimite jobul.
Un job trebuie, de asemenea, să se termine în 24 de ore, inclusiv timpul în care circuitele sale așteaptă în coadă, altfel este oprit fără niciun rezultat.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Calculează dimensiunea funcției
Fiecare job rulează la o dimensiune a funcției, S, M sau L, care selectează resursele de calcul pe care rulează. Pentru Rimay, dimensiunea depinde de numărul de rânduri pe care le mapează un job, rândurile de antrenare și de test împreună. Dacă soliciți o dimensiune prea mică, jobul eșuează cu eroarea 4600. Pentru dimensiuni și limitele lor, vezi Dimensiunile funcției în ghidul Rimay.
Celula următoare definește calculatorul de dimensiune. Rulează pe mașina ta, citește doar datele pe care i le transmiți și nu trimite nimic.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Transmite seturile de date în aceeași ordine ca fișierele din input_file, împreună cu modul rulării:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Pasul 3: Execută folosind primitivele Qiskit
Rulează Rimay în modul fit-transform. Acesta ajustează o mapare cuantică a trăsăturilor pe x_train.csv și y_train.csv și mapează cu ea atât setul de antrenare, cât și pe cel de test. Ordinea fișierelor din input_file contează. Enumeră trăsăturile de antrenare, etichetele de antrenare și apoi trăsăturile de test opționale. Transmite dimensiunea pe care ai calculat-o ca function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Monitorizează jobul
Verifică starea jobului cât timp rulează. job.result() blochează execuția până când jobul s-a terminat.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Rezultatul conține un mapping_id, care identifică maparea ajustată de această rulare. Nu ai nevoie de el în acest tutorial, deoarece setul de test a fost mapat în aceeași rulare. Notează acest ID dacă vrei să mapezi rânduri noi mai târziu cu mode="transform". Este singura cale de acces la maparea ajustată, iar fără el trebuie să ajustezi și să plătești o mapare nouă. Maparea este construită pentru aranjamentul qubiților acestui procesor, deci o rulare transform ulterioară trebuie să transmită același backend_name.
mapping_id = result["mapping_id"]
Pasul 4: Postprocesează și returnează rezultatul în formatul clasic dorit
Descarcă trăsăturile transformate cuantic
Descarcă fișierele scrise de job, folosind numele din output_files. Fiecare nume începe cu ID-ul jobului, astfel încât fișierele acestei rulări rămân disponibile și după rulările ulterioare. Transmite target_name pentru ca fiecare fișier să fie salvat sub propriul nume.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Antrenează pe trăsăturile transformate cuantic
Antrenează un random forest doar pe trăsăturile transformate cuantic.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Antrenează pe trăsăturile clasice și cuantice combinate
Alătură trăsăturile originale și pe cele transformate cuantic și antrenează același model pe combinație.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Compară rezultatele
Compară cele trei modele pe setul de test.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

AUC măsoară cât de bine ordonează un model creditele bune înaintea celor rele, independent de un prag de decizie, ceea ce îl face cea mai informativă metrică pentru acest set de date dezechilibrat (70% credite bune). În testele de referință ale Kipu Quantum, trăsăturile transformate cuantic, singure, au atins un AUC similar cu referința clasică, iar modelul hibrid, care le combină pe ambele, a atins cel mai mare AUC și scor F1. Prin urmare, trăsăturile transformate cuantic adaugă informații pe care trăsăturile clasice nu le oferă singure.
Curățare (opțional)
O mapare ajustată rămâne disponibilă până când o ștergi. Dacă nu vrei să mapezi alte date cu ea, șterge-o. O ștergere nu efectuează nicio lucrare cuantică, nu consumă timp QPU și nu poate fi anulată.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Concluzie
Ce ai realizat
În acest tutorial ai realizat următoarele:
-
Ai pregătit un set de date reale de risc de credit, cu atribute categoriale și numerice, pentru extragerea cuantică a trăsăturilor.
-
Ai stabilit o referință clasică cu random forest.
-
Ai folosit Rimay pentru a ajusta o mapare cuantică a trăsăturilor pe hardware cuantic și pentru a mapa seturile de antrenare și de test într-o singură rulare.
-
Ai antrenat același model pe trăsături transformate cuantic și pe trăsături combinate și le-ai comparat cu referința.
Concluzii principale
-
Rimay se integrează într-un flux de învățare automată existent ca un pas suplimentar de preprocesare. Îți păstrezi pregătirea datelor și modelul clasic.
-
Numărul de qubiți limitează numărul de trăsături de intrare, iar numărul de rânduri înmulțit cu
shotslimitează dimensiunea unui singur job. -
Folosește implicit trăsăturile transformate cuantic combinate cu trăsăturile originale, deoarece modelul le poate folosi pe ambele.
Pașii următori
- Citește ghidul Rimay pentru a afla despre toate intrările, a mapa date noi cu
mode="transform"și a vedea alte teste de referință. - Citește cum a fost aplicată extragerea cuantică a trăsăturilor la clasificarea imaginilor satelitare [3].
Referințe
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.