Rimay Quantum Feature Extraction - un Qiskit Function de la Kipu Quantum
Vezi referința API.
Qiskit Functions sunt o funcționalitate experimentală, disponibilă doar utilizatorilor planurilor IBM Quantum® Premium Plan, Flex Plan și On-Prem (prin API-ul IBM Quantum Platform). Se află în stadiul de versiune preview și pot suferi modificări.
Prezentare generală
Rimay îmbogățește fluxurile de învățare automată clasică cu caracteristici generate pe hardware cuantic. Funcția primește date tabelare clasice și returnează un set de caracteristici transformate cuantic. Când un sistem cuantic procesează datele, generează caracteristici bogate care surprind relațiile neliniare dintre intrări. Poți folosi caracteristicile generate singure sau combinate cu caracteristicile tale originale pentru a antrena orice model clasic. Pe seturi de date mici și medii, caracteristicile transformate cuantic pot îmbunătăți calitatea predicțiilor comparativ cu referințele pur clasice.
Această funcție este construită pentru următorii utilizatori:
-
Echipe de știința datelor cu un flux de învățare automată existent pe seturi de date tabelare mici și medii, unde calitatea predicțiilor a stagnat. Adaugi Rimay ca un pas suplimentar de preprocesare, fără a construi tu însuți circuite cuantice.
-
Cercetători care explorează metode cuantice pentru sarcini de învățare automată.
Descriere
Algoritmul de extragere cuantică a caracteristicilor [1] combină două principii ale învățării automate cuantice. Primul este hărțile cuantice de caracteristici, care încorporează datele într-un spațiu Hilbert de dimensiune mare și produc astfel reprezentări mai expresive. Al doilea este calculul cuantic de tip reservoir, care folosește dinamica unui sistem cuantic cu mai multe corpuri drept transformare neliniară a intrării.
Rimay codifică valorile caracteristicilor și informația mutuală dintre caracteristici în câmpurile locale și în coeficienții de cuplaj ai unui hamiltonian de tip spin-glass. Dinamica cuantică contradiabatică face sistemul să evolueze spre stările sale de energie joasă, care conțin amestecuri neliniare ale corelațiilor din datele de intrare. Rimay extrage aceste corelații măsurând valorile medii pentru un corp și pentru două corpuri. Valorile medii sunt caracteristicile transformate cuantic, pe care le introduci în modelul tău de învățare automată.
Flux de lucru
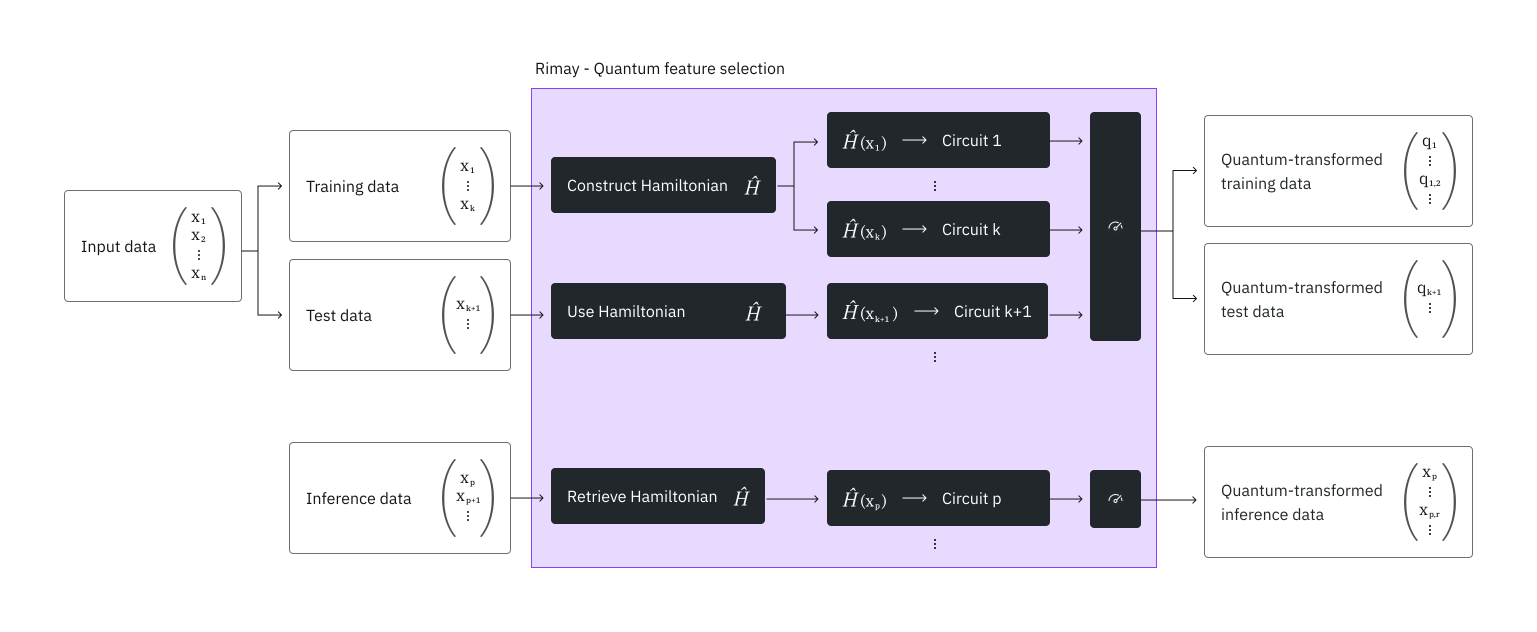
-
Preprocesează datele tabulare așa cum ai face pentru învățarea automată clasică. Rimay are nevoie de caracteristici numerice, așa că transformă caracteristicile categoriale în caracteristici numerice, de exemplu cu
OneHotEncoderdin scikit-learn. -
Împarte datele într-un set de antrenare și un set de test și încarcă-le pe amândouă în funcție, așa cum se arată în secțiunea Exemplu.
-
Rimay folosește datele de antrenare pentru a construi hamiltonianul care reprezintă datele. Fiecare caracteristică corespunde unui qubit, iar setul complet de antrenare decide care caracteristici, și deci care qubiți, interacționează. Rimay stochează această structură pentru a mapa datele de test și datele de inferență ulterioare cu același hamiltonian.
-
Pentru fiecare eșantion, valorile caracteristicilor stabilesc câmpurile locale ale hamiltonianului, iar informația mutuală dintre caracteristici stabilește coeficienții de cuplaj ai structurii de la pasul 3. Rimay digitizează evoluția contradiabatică a acestui hamiltonian într-un circuit și rulează circuitele pe QPU.
-
Rimay măsoară șirurile de biți rezultate, apoi calculează valorile medii pentru un corp și valorile medii pentru două corpuri ale qubiților cuplați fizic.
-
Descarci valorile medii într-o formă pe care o poți introduce direct în modelul tău sau o poți combina cu caracteristicile tale originale.
Din cauza acestei structuri, numărul de qubiți de care are nevoie o rulare este egal cu numărul de caracteristici, iar numărul de circuite pe care le trimite este egal cu numărul de eșantioane.
După ce potrivești o mapare, poți mapa date noi prin ea, de exemplu pentru inferență. Rimay preia apoi hamiltonianul pe care l-a creat în timpul potrivirii și construiește din el circuitele pentru eșantioanele noi.
Integrează Rimay în fluxul tău de învățare automată
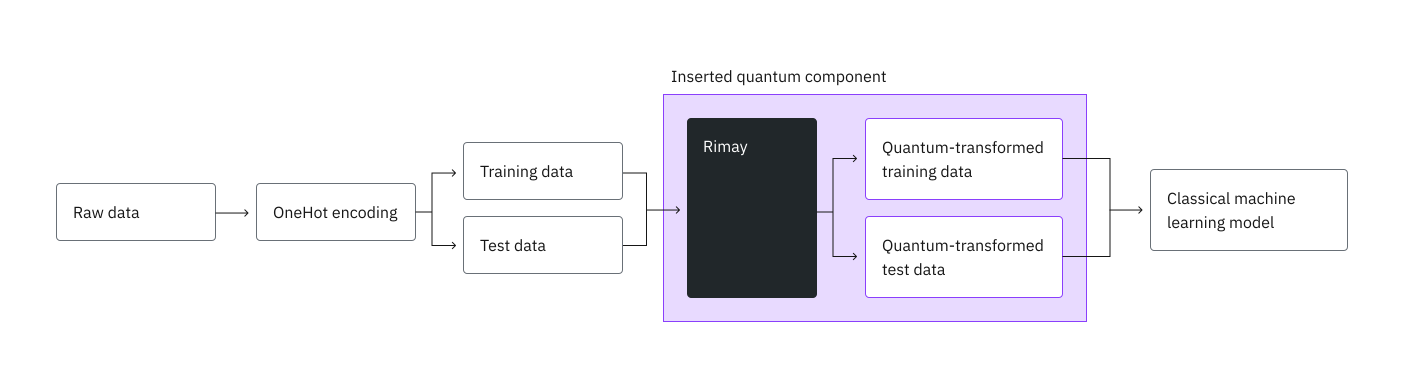
Ca într-un flux clasic, începi prin preprocesarea datelor brute, de exemplu prin codificarea one-hot a caracteristicilor categoriale, și le împarți într-un set de antrenare și un set de test. În loc să introduci ambele seturi direct în modelul tău, le introduci mai întâi în Rimay și antrenezi modelul pe caracteristicile transformate cuantic.
Teste de performanță
Kipu Quantum a evaluat Rimay pe setul de date German credit din OpenML [2], care clasifică 1000 de solicitanți de credit ca riscuri de credit bune sau rele. Acesta are 13 atribute categoriale și șapte atribute numerice. Codificarea one-hot a atributelor categoriale rezultă în 48 de caracteristici numerice. Testul rezervă 20% din eșantioane ca set de test.
Ca referință, mai multe modele clasice au fost antrenate pe caracteristicile clasice. Cu Rimay, o pădure aleatoare a fost antrenată în două moduri: doar pe caracteristicile transformate cuantic (Random forest Q) și pe caracteristicile transformate cuantic combinate cu cele clasice (Random forest H, de la hibrid). Tabelul raportează doar pădurea aleatoare, deoarece aceasta a avut cele mai bune rezultate pe caracteristicile transformate cuantic.
| Model | Caracteristici | Acuratețe | AUC | Scor F1 | Precizie | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Clasice | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Clasice | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Clasice | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Clasice | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Cuantice | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hibride | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Caracteristicile hibride îmbunătățesc toate metricile pădurii aleatoare, cu excepția preciziei, iar pădurea aleatoare hibridă atinge un AUC, un scor F1 și un recall mai mari decât CatBoost pe caracteristicile clasice. Cel mai mare efect este asupra recall-ului, care crește de la 0.921 la 0.957. Caracteristicile transformate cuantic singure nu ating precizia modelelor clasice.
Setul de test conține doar 200 de eșantioane, așa că prezicerea corectă a încă unui eșantion modifică acuratețea cu 0.005. Interpretează diferențele ca pe o tendință care necesită verificare suplimentară, nu ca pe un efect semnificativ. Acuratețea predicției poate depinde și de zgomotul indus de hardware în caracteristicile extrase. De aceea, folosește suficiente shot-uri, astfel încât zgomotul de shot să nu limiteze rezultatul.
Testul a folosit următoarele resurse:
| Exemplu | Număr de qubiți | Număr de eșantioane | Număr de shot-uri | Timp total (min) | Utilizare QPU (min) | Procesor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Numărul de eșantioane, care este numărul de circuite, determină timpul QPU. Folosește tipul de procesor Nighthawk r2, deoarece reduce considerabil timpul QPU necesar.
Intrări
mode determină ce parametri are nevoie o rulare. Pentru o descriere a fiecărui parametru de intrare, vezi referința API.
Fișiere de intrare
-
Încarcă fiecare fișier cu
catalog.file_upload()înainte de a rula funcția. -
O încărcare înlocuiește orice fișier anterior cu același nume, chiar și pentru un job pe care l-ai trimis, dar care nu a început încă. Pentru a rula mai multe joburi în același timp, dă fișierelor fiecărui job nume proprii, de exemplu
run1_x_train.csvșirun2_x_train.csv. -
Fiecare fișier este un fișier CSV cu un rând de antet. Fiecare coloană a unui fișier de caracteristici este o caracteristică, iar fiecare valoare trebuie să fie numerică.
-
y_trainconține exact o coloană numerică, cu o etichetă pentru fiecare rând dinx_train. Mapează etichetele categoriale la numere, de exemplu bun și rău la 1 și 0. -
x_testșix_inferencetrebuie să aibă aceleași coloane cax_train, în aceeași ordine.
mapping_id este singura cale de a ajunge la maparea produsă de potrivirea ta și nu poate fi căutat sau recuperat. Acesta autorizează utilizarea acelei mapări, așa că tratează-l ca pe o credențială și nu îl partaja. Dacă îl pierzi, trebuie să potrivești o mapare nouă, ceea ce costă încă o rulare pe hardware cuantic. Notează și backend_name al potrivirii, deoarece maparea rulează doar pe acel procesor.
Limite
-
Fiecare caracteristică este mapată la un qubit, așa că procesorul trebuie să aibă cel puțin tot atâția qubiți câte caracteristici au datele tale. Dacă ai mai multe caracteristici, redu-le mai întâi cu o tehnică de selecție a caracteristicilor.
-
Fiecare eșantion devine un circuit, iar o rulare numără împreună eșantioanele de antrenare și de test. O rulare poate conține cel mult 15.000 de eșantioane.
-
Un singur job poate solicita cel mult 10 milioane de execuții, deci numărul de eșantioane înmulțit cu
shotsnu trebuie să depășească 10 milioane. -
Un job trebuie să se termine în 24 de ore, inclusiv timpul cât circuitele sale așteaptă în coada procesorului. Un job care rulează mai mult este oprit fără rezultat. Pe un procesor aglomerat, păstrează seturile mari de date mult sub aceste limite.
Ieșiri
job.result() returnează un dicționar. Caracteristicile transformate cuantic sunt scrise în fișiere CSV pe care le descarci cu catalog.file_download(). Pentru o descriere a fiecărei chei a dicționarului, vezi referința API. Pentru timpul pe care l-a luat fiecare fază de execuție, vezi Metadatele rulării.
Fiecare fișier de ieșire conține câte un rând pentru fiecare rând de intrare, în ordinea fișierului de intrare, și câte o coloană pentru fiecare caracteristică transformată cuantic. Coloanele ale căror nume încep cu corr_ sunt valorile medii pentru două corpuri. Fișierele nu conțin nicio coloană de etichete. Etichetele datelor tale de antrenare rămân în fișierul tău y_train.
Metadatele rulării
resource_usage conține câte o intrare pentru fiecare fază de execuție prin care a trecut rularea: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" și, pe un QPU, de obicei "RUNNING: WAITING_FOR_QPU". Fiecare intrare conține CPU_TIME, timpul real al fazei în secunde, și QPU_TIME, timpul QPU în secunde. Pe un QPU, timpul QPU facturat de IBM este înregistrat la "RUNNING: MAPPING", faza în care au rulat circuitele.
"RUNNING: WAITING_FOR_QPU" este timpul cât au așteptat joburile tale în coada IBM. Rularea preia acest timp din marcajele de timp ale joburilor IBM și nu îl include în "RUNNING: MAPPING". Dacă IBM nu raportează acele marcaje de timp pentru fiecare job, intrarea lipsește, iar așteptarea face parte din "RUNNING: MAPPING".
IBM® își termină calculul utilizării la ceva timp după ce se termină un job. Rularea așteaptă până la aproximativ un minut pentru acesta. Utilizarea care este încă în curs de calcul după acest timp nu este inclusă în QPU_TIME, iar utilizarea finală este afișată în IBM Quantum Platform. Dacă rularea nu poate citi utilizarea de la IBM, QPU_TIME este None.
De exemplu:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Primii pași
Autentifică-te folosind cheia API IBM Quantum Platform și selectează Qiskit Function astfel:
Codul următor presupune că ți-ai salvat credențialele. Dacă nu, urmează instrucțiunile din Instalează clientul Qiskit Functions Catalog pentru a-ți salva contul cu cheia ta API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Dimensiunile funcției
Fiecare job rulează la o singură dimensiune — S, M sau L. Dacă dimensiunea specificată este prea mică, jobul este respins. Dacă dimensiunea este mai mare decât este necesar, jobul rulează pe un profil de calcul mai mare decât cere lucrarea.
Dimensiunea unui job Rimay depinde de numărul de eșantioane pe care le mapează: rândurile din x_train și x_test pentru fit-transform și rândurile din x_inference pentru transform. Etichetele din y_train nu se numără, iar o rulare delete nu mapează niciun eșantion.
| Dimensiune | Eșantioane per job | Profil de calcul | vCPU | RAM |
|---|---|---|---|---|
S | Până la 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 până la 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 până la 15,000 | 16x128 | 16 | 128 GB |
Numărul de eșantioane este singurul criteriu. O dimensiune nu schimbă nimic în afară de profilul de calcul: limitele pentru caracteristici, eșantioane și shot-uri sunt aceleași pentru fiecare dimensiune. S și M rulează pe același profil de calcul și diferă prin numărul de eșantioane pe care le acoperă fiecare.
Valoarea implicită este M, folosită când un job nu solicită o dimensiune. Un job de peste 9,999 de eșantioane trebuie, prin urmare, să solicite L.
Poți citi maparea și direct din funcție cu rimay.sizes_map, iar dimensiunea la care rulează un job când nu solicită una cu rimay.default_size.
Calculează dimensiunea înainte de trimitere
Rulează acest lucru pe propriile tale intrări. Calculatorul le citește și nu face nimic altceva: nu se trimite niciun job și nu se rezervă nimic, așa că îl poți apela de câte ori vrei.
Transmite seturile de date în sine, nu numele fișierelor lor, în aceeași ordine ca input_file, împreună cu mode al rulării. Pasul 2 al exemplului arată apelul.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Dacă dimensiunea este prea mică, jobul eșuează cu eroarea 4600, iar mesajul indică dimensiunea de folosit în schimb. Dacă este mai mare decât este necesar, jobul rulează normal și înregistrează un eveniment de avertizare 4601.
Exemplu
Acest exemplu arată cum să încarci date, să rulezi funcția și să obții caracteristicile transformate cuantic. Pentru un exemplu cap-coadă care include preprocesarea și antrenarea modelului clasic, vezi tutorialul.
1. Încarcă datele
Acest exemplu folosește un set mic de date sintetice cu patru caracteristici numerice și o etichetă binară, astfel încât o rulare să aibă nevoie de doar patru qubiți și să se termine rapid. Celula următoare îl scrie în patru fișiere CSV: caracteristicile de antrenare, etichetele de antrenare, caracteristicile de test și caracteristicile pentru pasul 4 al acestui exemplu. Pentru a folosi propriile date, scrie în schimb seturile tale preprocesate de antrenare și de test în fișiere cu aceeași structură.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Încarcă fișierele de antrenare și de test. Încarci x_inference.csv la pasul 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Rulează funcția
Calculează dimensiunea rulării din datele pe care le-ai încărcat, cu calculatorul din Dimensiunile funcției.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Selectează un procesor cu cel puțin tot atâția qubiți câte caracteristici au datele tale și rulează funcția în modul fit-transform cu acea dimensiune. Datele de exemplu au patru caracteristici, deci orice procesor IBM Quantum le poate rula.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Verifică starea sarcinii sau returnează rezultatele astfel:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Obține rezultatele
Descarcă caracteristicile transformate cuantic. Transmite target_name pentru ca fiecare fișier să fie salvat sub propriul nume.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Mapează date noi
După ce îți antrenezi modelul, mapează date noi cu maparea potrivită, de exemplu pentru a rula inferența. Acest exemplu mapează x_inference.csv, pe care l-a scris prima celulă a acestui exemplu. Transmite mapping_id returnat de potrivire, astfel încât rândurile noi să fie mapate cu aceeași mapare, nu cu una nouă.
O mapare este construită pentru aranjamentul qubiților unui singur procesor, așa că transmite același backend_name ca la potrivire, pe care potrivirea l-a returnat în result["backend_name"]. Nu folosi least_busy() pentru a alege procesorul, deoarece ar putea returna altul. Rimay respinge orice alt procesor înainte de a trimite ceva. Numărul de shot-uri provine, de asemenea, din potrivire.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Șterge o mapare
Când nu mai ai nevoie de o mapare potrivită, șterge-o. O rulare delete nu face nicio operație cuantică, deci nu are nevoie de procesor, de shot-uri sau de dimensiune a funcției. Nu poți anula o ștergere. După ștergere, mapping_id nu mai face referire la nimic, iar o rulare transform cu el eșuează.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Obține mesajele de eroare
Dacă starea sarcinii tale este ERROR, folosește job.error_message() pentru a obține mesajul de eroare, astfel:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Fiecare eroare raportată de Rimay conține un cod din codurile de eroare IBM Quantum, un mesaj și o soluție care indică valoarea pe care ai transmis-o și valoarea permisă. Tabelul următor listează cele mai frecvente erori:
| Cod | Cauză |
|---|---|
1221 | Lipsește un parametru sau are tipul greșit, mode nu este valid, un fișier numit în input_file nu a fost încărcat, fișierele nu se potrivesc între ele, o caracteristică nu este numerică sau mapping_id nu corespunde unei mapări stocate. |
1221 | O rulare "transform" indică un backend_name diferit de cel al potrivirii care i-a produs maparea. |
1216 | Instanța ta nu are niciun procesor cu backend_name pe care l-ai transmis. Soluția listează procesoarele pe care le are. |
1200 | Cheia ta API nu are acces la instanța sub care rulează jobul. |
3200 | backend_name nu începe cu ibm_. |
4500 | Datele au mai multe caracteristici decât are procesorul qubiți. |
6000 | Numărul de eșantioane înmulțit cu shots depășește 10 milioane de execuții. |
6001 | shots este mai mic decât 1. |
6002 | Datele au mai multe eșantioane decât permite o rulare. |
Cazuri de utilizare
În clasificarea tabulară pe seturi de date mici și medii, Kipu Quantum a aplicat extragerea cuantică a caracteristicilor pentru următoarele:
Dincolo de datele tabulare, rețelele neuronale înghețate pot transforma imaginile în caracteristici numerice, pe care extragerea cuantică a caracteristicilor le mapează apoi în caracteristici transformate cuantic:
Obține asistență
Pentru asistență, contactează support@kipu-quantum.com.
Pașii următori
-
Vizitează referința API pentru această Qiskit Function.
-
Încearcă tutorialul Clasifică riscul de credit cu extragerea cuantică a caracteristicilor Rimay de la Kipu Quantum.
Referințe
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Informații suplimentare
Rimay este un cuvânt quechua care înseamnă „a explica”.