Formule multi-produs pentru reducerea erorii Trotter
Timp estimat de utilizare: patru minute pe un procesor Heron r2 (NOTĂ: Aceasta este doar o estimare. Timpul tău de execuție poate varia.)
Rezultate ale învățării
-
Cum formulele multi-produs (MPF) reduc eroarea Trotter în simularea hamiltonienilor prin combinarea valorilor de așteptare din mai multe circuite superficiale
-
Când MPF-urile sunt avantajoase față de formulele produs standard și când nu sunt instrumentul potrivit
-
Cum să calculezi coeficienți MPF statici și dinamici folosind pachetul
qiskit_addon_mpf -
Cum să execuți un flux de lucru MPF de la un capăt la altul pe hardware IBM Quantum®, incluzând transpilarea, atenuarea erorilor și post-procesarea
Cerințe prealabile
-
Metode de compilare pentru circuitele de simulare hamiltoniană — introduce circuitele Trotter (formulă produs) în Qiskit.
-
Formule produs în Qiskit, în special clasele de sinteză
SuzukiTrotterșiLieTrotter.
Fundal
Ce sunt formulele multi-produs?
Atunci când simulezi sisteme cuantice pe un calculator cuantic, o sarcină centrală este aproximarea operatorului de evoluție temporală pentru un hamiltonian . Abordarea standard folosește formule produs (PF), cunoscute și ca descompuneri Trotter-Suzuki. Acestea descompun în termeni ale căror unitare individuale sunt eficient de implementat, iar apoi aproximează evoluția completă ca un produs ordonat al acestor unitare mai simple.
Formula produs de ordinul întâi (Lie-Trotter) este:
care produce o eroare pătratică: . Formulele simetrice de ordin superior , unde etichetează ordinul formulei produs simetrice (vezi Ref. [1]), converg mai rapid, ca , dar cu costul unor circuite mai adânci per pas.
Pentru a reduce eroarea la o ordine fixă, de obicei se împarte timpul total de evoluție în pași Trotter mai mici. Fiecare pas aproximează printr-o formulă produs, iar pașii sunt concatenați:
Pentru o formulă simetrică de ordin , eroarea Trotter reziduală scalează atunci ca . Deci creșterea lui suprimă rapid eroarea Trotter — dar adâncește și liniar circuitul, iar pe hardware zgomotos asta înseamnă mai mult zgomot acumulat al porților. Această tensiune între eroarea Trotter (favorizează un mai mare) și zgomotul hardware-ului (favorizează un mai mic) este exact ceea ce sunt concepute să rezolve formulele multi-produs. Reține că MPF-urile combină rezultate din alegeri diferite ale lui la o ordine fixă — ele nu schimbă ordinul formulei produs subiacente.
Formulele multi-produs (MPF) [1] construiesc o combinație liniară ponderată de valori de așteptare obținute din mai multe circuite Trotter mai puțin adânci, fiecare folosind un număr diferit de pași Trotter (un set de numere de pași):
unde este valoarea de așteptare a unei observabile la timpul , estimată dintr-un circuit Trotter cu pași, iar coeficienții sunt aleși astfel încât termenii principali de eroare Trotter din combinație să se anuleze. Vom reveni la această expresie în Pasul 4, unde o evaluăm explicit pentru a combina rezultatele noastre Trotter. Punctul-cheie practic este că cel mai adânc circuit din MPF necesită doar pași, mult mai puțin decât -ul unic necesar pentru a atinge direct aceeași eroare Trotter efectivă. Circuitele mai puțin adânci fac abordarea MPF mai potrivită pentru hardware zgomotos.
Cum sunt determinați coeficienții?
Există două familii de coeficienți MPF:
Coeficienții statici sunt independenți de hamiltonian, de starea inițială și de timpul de evoluție. Se găsesc rezolvând un sistem liniar care impune anularea termenilor principali de eroare Trotter. Pentru un set de pași Trotter folosiți cu o formulă produs simetrică de ordin , expandarea erorii Trotter în puteri inverse ale lui conduce la ecuații de constrângere de forma:
unde exponenții întregi sunt ordinele termenilor succesivi de eroare Trotter pentru formula produs aleasă. Pentru o PF simetrică de ordin , eroarea principală în scalează ca , cu corecții ulterioare la — deci exponenții sunt . Pentru PF-uri nesimetrice, atât puterile impare, cât și cele pare contribuie, iar . Vezi Ref. [1] pentru derivarea completă. Prima ecuație din sistemul de mai sus asigură nedeplasarea (MPF reproduce valoarea de așteptare exactă în limita ), iar celelalte ecuații anulează succesiv primii termeni de eroare Trotter. Când norma rezultată este prea mare (ceea ce amplifică zgomotul de eșantionare), poți în schimb rezolva o optimizare aproximativă care limitează minimizând în același timp .
Coeficienții dinamici [2], [3] depind în plus de hamiltonian, de starea inițială și de timpul de evoluție . Ei minimizează distanța Frobenius dintre starea real evoluată în timp și aproximarea MPF:
unde este matricea Gram a suprapunerilor dintre stările evoluate Trotter pentru diferite numere de pași , iar măsoară suprapunerea cu starea exactă (aproximativă). În acest tutorial, aceste cantități sunt calculate eficient folosind metode de tip rețea tensorială, în mod specific backend-urile bazate pe TeNPy din qiskit_addon_mpf.
Când să folosești MPF-urile
MPF-urile sunt cele mai avantajoase când:
-
Adâncimea circuitului este blocajul. Dacă zgomotul hardware-ului limitează adâncimea pe care o poți rula, folosește MPF-uri pentru a obține o precizie Trotter efectivă mai mare din circuite mai puțin adânci.
-
Ai nevoie de valori de așteptare precise, nu de pregătirea completă a stării. MPF-urile operează la nivelul valorilor de așteptare — ele combină numere clasice, nu stări cuantice. Sunt, prin urmare, ideale pentru estimarea observabilelor atunci când folosești primitiva Estimator.
-
Combini un număr modest de numere de pași Trotter. De obicei, combinarea a – numere diferite de pași este suficientă pentru a anula mai mulți termeni principali de eroare Trotter, păstrând totodată gestionabil.
Când MPF-urile ar putea să nu ajute
-
Timpi de evoluție foarte scurți. Când este suficient de mic încât o singură formulă Trotter de ordin inferior este deja precisă, costul suplimentar de a rula mai multe circuite este inutil.
-
Sarcini de pregătire a stărilor. MPF-urile produc o valoare de așteptare corectată, nu o stare cuantică corectată. Dacă ai nevoie de starea evoluată în timp real (de exemplu, ca intrare pentru o altă subrutină cuantică), MPF-urile nu se aplică.
-
Numere de pași Trotter care încalcă regimul de convergență. Derivarea cu coeficienți statici extinde fiecare individual ca o serie în ; această extindere converge bine doar când . Dacă este ales prea mic pentru dat, cel mai puțin adânc circuit se află mult în afara regimului perturbativ, termenii de eroare de ordin superior pe care MPF-ul îi lasă necompensați devin mari, iar compensarea poate necesita coeficienți mari. Norma , , este diagnosticul practic: atunci când , costul de eșantionare ar putea depăși reducerea erorii Trotter. Consultă ghidul despre alegerea pașilor Trotter pentru detalii.
Ce acoperă acest tutorial
Acest tutorial parcurge un flux de lucru MPF complet în două etape. Mai întâi, un exemplu la scară mică pe simulator (lanț Heisenberg cu 10 qubiți) demonstrează cum se configurează problema, cum se calculează coeficienții MPF statici și dinamici și cum se compară valorile de așteptare rezultate cu diagonalizarea exactă. Apoi, un exemplu la scară mare pe hardware (lanț XXZ cu 50 de qubiți) arată cum să transpilezi, să execuți pe hardware IBM Quantum cu atenuarea erorilor și să procesezi ulterior rezultatele folosind coeficienții MPF. Pe parcurs, folosim pachetul qiskit_addon_mpf alături de instrumentele Qiskit standard.
Cerințe
Înainte de a începe acest tutorial, asigură-te că ai instalate următoarele:
-
Qiskit SDK v2.0 sau mai recent cu suport pentru vizualizare
-
Qiskit Runtime v0.22 sau mai recent (
pip install qiskit-ibm-runtime) -
Simulatorul Qiskit Aer (
pip install qiskit-aer) -
Addon-ul Qiskit MPF cu backend-ul TeNPy (
pip install "qiskit-addon-mpf[tenpy]") -
Utilitare Qiskit addon (
pip install qiskit-addon-utils) -
SciPy (
pip install scipy)
Configurare
Mai jos colectăm toate importurile de pachete folosite pe parcursul acestui tutorial într-o singură celulă. De asemenea, definim un pass de transpiler CollectAndCollapse care fuzionează rotațiile rxx și ryy adiacente într-un singur XXPlusYYGate. Acest pass este aplicat atât la construirea circuitului în Pasul 1 (pentru a menține un număr scăzut de porți), cât și indirect atunci când extragem structura pe straturi pentru MPF-ul dinamic în Pasul 4 (TeNPy se așteaptă la porți cu doi qubiți, nu la perechi de rotații nefuzionate).
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-addon-mpf qiskit-addon-utils qiskit-aer qiskit-ibm-runtime scipy
import warnings

import numpy as np
import matplotlib.pyplot as plt
from functools import partial
from copy import deepcopy

from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp, Statevector
from qiskit.synthesis import SuzukiTrotter
from qiskit.transpiler import CouplingMap, PassManager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.circuit.library import XXPlusYYGate
from qiskit.transpiler.passes.optimization.collect_and_collapse import (
    CollectAndCollapse,
    collect_using_filter_function,
    collapse_to_operation,
)

from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import EstimatorV2 as Estimator, QiskitRuntimeService

from qiskit_addon_utils.problem_generators import (
    generate_xyz_hamiltonian,
    generate_time_evolution_circuit,
)
from qiskit_addon_utils.slicing import slice_by_depth
from qiskit_addon_mpf.static import setup_static_lse
from qiskit_addon_mpf.dynamic import setup_dynamic_lse
from qiskit_addon_mpf.costs import (
    setup_exact_problem,
    setup_sum_of_squares_problem,
    setup_frobenius_problem,
)
from qiskit_addon_mpf.backends.tenpy_layers import (
    LayerModel,
    LayerwiseEvolver,
)
from qiskit_addon_mpf.backends.tenpy_tebd import MPOState, MPS_neel_state

from scipy.linalg import expm

# Suppress TeNPy's `unit_cell_width` future-API warning. The default
# (`unit_cell_width=len(sites)`) is correct for Chain lattices, which is what
# `CouplingMap.from_line(...)` produces here, so the warning is informational.
warnings.filterwarnings(
    "ignore",
    message=r".*unit_cell_width.*",
    category=UserWarning,
)

# --- Helper: collect XX + YY rotations into a single gate ---
def filter_function(node):
    return node.op.name in {"rxx", "ryy"}

collect_function = partial(
    collect_using_filter_function,
    filter_function=filter_function,
    split_blocks=True,
    min_block_size=1,
)

def collapse_to_xx_plus_yy(block):
    param = 0.0
    for node in block.data:
        param += node.operation.params[0]
    return XXPlusYYGate(param)

collapse_function = partial(
    collapse_to_operation,
    collapse_function=collapse_to_xx_plus_yy,
)

pm = PassManager()
pm.append(CollectAndCollapse(collect_function, collapse_function))
Exemplu la scară mică pe simulator
Pasul 1: Maparea intrărilor clasice la o problemă cuantică
Începem cu un model Heisenberg cu 10 qubiți pe o linie, folosind starea Néel ca stare inițială. Hamiltonianul este:
unde este intensitatea cuplajului între cei mai apropiați vecini. Măsurăm corelatorul ZZ pe o pereche de qubiți din mijlocul lanțului și folosim pași Trotter cu o formulă de produs de ordinul doi.
L = 10

# Generate coupling map and Hamiltonian
coupling_map = CouplingMap.from_line(L, bidirectional=False)

hamiltonian = generate_xyz_hamiltonian(
    coupling_map,
    coupling_constants=(1.0, 1.0, 1.0),
    ext_magnetic_field=(0.0, 0.0, 0.0),
)
print(hamiltonian)
SparsePauliOp(['IIIIIIIXXI', 'IIIIIIIYYI', 'IIIIIIIZZI', 'IIIIIXXIII', 'IIIIIYYIII', 'IIIIIZZIII', 'IIIXXIIIII', 'IIIYYIIIII', 'IIIZZIIIII', 'IXXIIIIIII', 'IYYIIIIIII', 'IZZIIIIIII', 'IIIIIIIIXX', 'IIIIIIIIYY', 'IIIIIIIIZZ', 'IIIIIIXXII', 'IIIIIIYYII', 'IIIIIIZZII', 'IIIIXXIIII', 'IIIIYYIIII', 'IIIIZZIIII', 'IIXXIIIIII', 'IIYYIIIIII', 'IIZZIIIIII', 'XXIIIIIIII', 'YYIIIIIIII', 'ZZIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
# Observable: ZZ on the middle pair of qubits
observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)
print(observable)
SparsePauliOp(['IIIIZZIIII'],
              coeffs=[1.+0.j])
# MPF parameters
mpf_trotter_steps = [1, 2, 4]
order = 2
symmetric = False

trotter_times = np.arange(0.5, 1.55, 0.1)
exact_evolution_times = np.arange(trotter_times[0], 1.55, 0.05)
Construirea circuitelor Trotter
Creăm circuitele care implementează evoluțiile Trotter aproximative în timp pentru fiecare punct de timp și fiecare număr de pași Trotter. Pass-ul CollectAndCollapse definit în secțiunea Configurare colectează rotațiile XX și YY în porți XX+YY unice, pentru a pregăti o simulare mai eficientă cu rețele tensoriale ulterior.
# Initial Neel state preparation
initial_state_circ = QuantumCircuit(L)
initial_state_circ.x([i for i in range(L) if i % 2 != 0])

all_circs = []
for total_time in trotter_times:
    mpf_trotter_circs = [
        generate_time_evolution_circuit(
            hamiltonian,
            time=total_time,
            synthesis=SuzukiTrotter(reps=num_steps, order=order),
        )
        for num_steps in mpf_trotter_steps
    ]

    mpf_trotter_circs = pm.run(
        mpf_trotter_circs
    )  # Collect XX and YY into XX + YY

    mpf_circuits = [
        initial_state_circ.compose(circuit) for circuit in mpf_trotter_circs
    ]
    all_circs.append(mpf_circuits)
mpf_circuits[-1].draw("mpl", fold=-1)
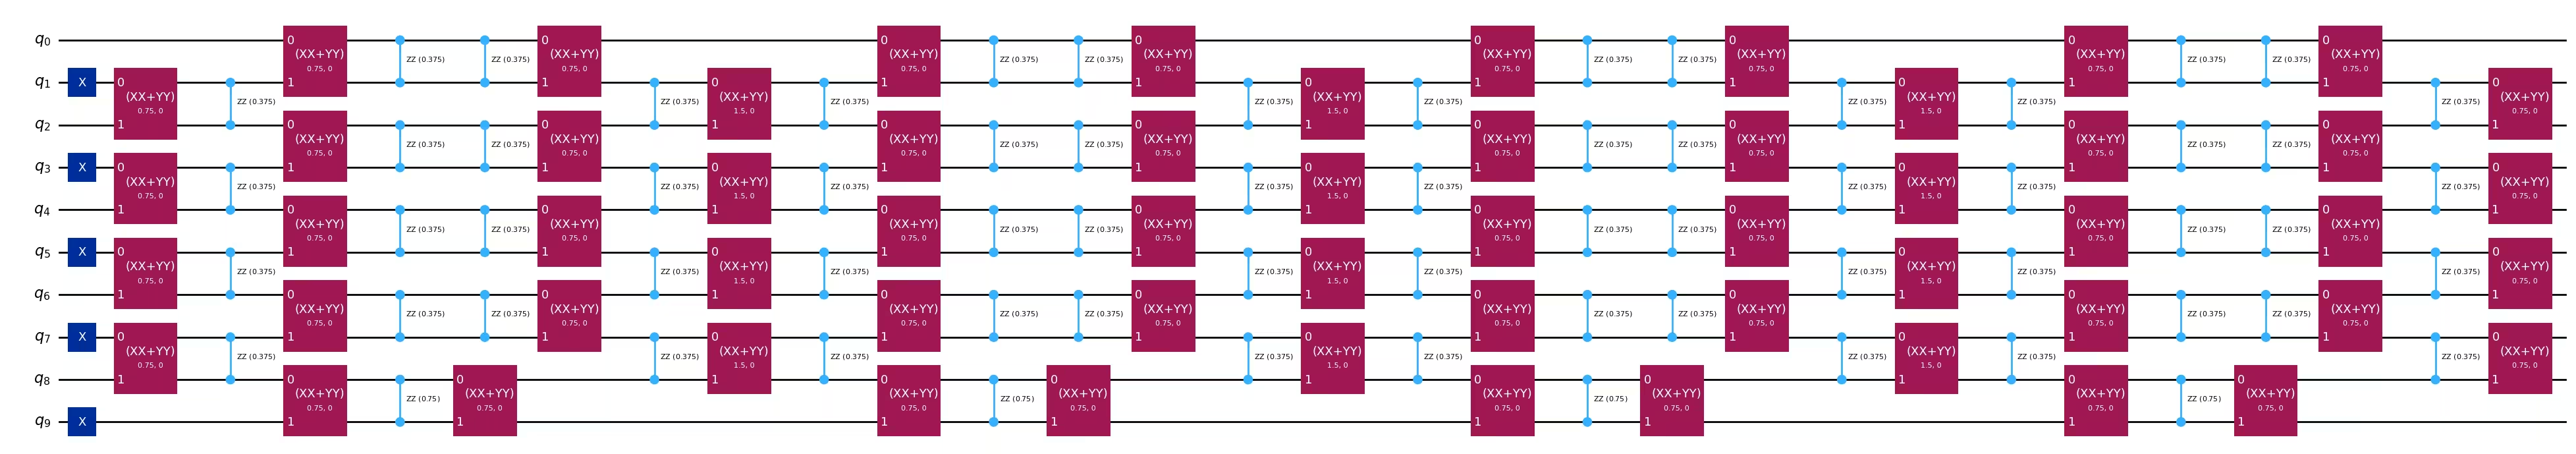
Pasul 2: Optimizarea problemei pentru execuția pe hardware cuantic
Pentru exemplul la scară mică vizăm simulatorul Aer. Două transformări au loc înainte ca circuitele să fie gata de execuție:
-
Colectarea porților la nivelul simulării hamiltonianului. În celula de Configurare am construit un pass
CollectAndCollapsecare fuzionează rotațiilerxxșiryyadiacente într-un singurXXPlusYYGate. Am aplicat deja acest pass când am construit circuitele Trotter în Pasul 1 (apelulpm.run(...)). Aceasta reduce numărul de porți cu doi qubiți și produce o structură mai adecvată pentru simularea cu rețele tensoriale, pentru calculul ulterior al coeficienților dinamici. -
Coborârea la ISA a simulatorului. Mai jos rulăm managerul de pass-uri predefinit Qiskit la
optimization_level=3pentru a coborî fiecare circuit Trotter la arhitectura setului de instrucțiuni (ISA) a simulatorului.
aer_sim = AerSimulator()
pm_sim = generate_preset_pass_manager(backend=aer_sim, optimization_level=3)

isa_circs_all_times = [
    pm_sim.run([deepcopy(c) for c in mpf_circuits])
    for mpf_circuits in all_circs
]
Pasul 3: Executare folosind primitivele Qiskit
Pentru exemplul la scară mică rulăm circuitele Trotter coborâte la ISA prin primitiva EstimatorV2 susținută de Aer. Astfel obținem o valoare de referință fără zgomot pentru fiecare pereche — acestea sunt valorile pe care MPF-ul le va combina în Pasul 4. Baleiem timpi de evoluție pentru a putea trasa ulterior curba completă a seriei temporale pentru fiecare formulă de produs individuală și pentru MPF.
estimator = Estimator(mode=aer_sim)

mpf_expvals_all_times, mpf_stds_all_times = [], []
for isa_circuits in isa_circs_all_times:
    result = estimator.run(
        [(circuit, observable) for circuit in isa_circuits], precision=0.005
    ).result()
    mpf_expvals_all_times.append([res.data.evs for res in result])
    mpf_stds_all_times.append([res.data.stds for res in result])
Pasul 4: Post-procesare și returnarea rezultatului în formatul clasic dorit
Pasul 4 este unde MPF-ul este construit efectiv. Chiar dacă coeficienții sunt calculați aici (iar pentru varianta dinamică, acest calcul poate fi intensiv), conceptual ei reprezintă o rețetă clasică pentru combinarea măsurătorilor cuantice din Pasul 3 într-o singură valoare de așteptare corectată — deci tratăm întregul flux de lucru de calcul al coeficienților și combinare ca post-procesare.
Pentru a evalua cât de bine urmărește MPF-ul dinamica reală, calculăm mai întâi valorile de așteptare exacte evoluate în timp prin exponențierea directă a hamiltonianului. Acest lucru este fezabil doar pentru că ; în exemplul la scară mare pe hardware de mai jos va trebui să ne bazăm în schimb pe estimări cu rețele tensoriale.
exact_expvals = []
for t in exact_evolution_times:
    exp_H = expm(-1j * t * hamiltonian.to_matrix())
    initial_state = Statevector(initial_state_circ).data
    time_evolved_state = exp_H @ initial_state

    exact_obs = (
        time_evolved_state.conj()
        @ observable.to_matrix()
        @ time_evolved_state
    ).real
    exact_expvals.append(exact_obs)
Coeficienți MPF statici
MPF-urile statice folosesc coeficienți care sunt independenți de timpul de evoluție, de hamiltonian și de starea inițială. Configurăm sistemul liniar descris în secțiunea Context și rezolvăm pentru coeficienți. Matricea este determinată de numerele de pași Trotter , ordinul al formulei de produs și dacă formula este simetrică (ceea ce controlează exponenții ).
Pentru exemplul nostru la scară mică folosim cu o formulă Suzuki-Trotter nesimetrică de ordin (deci și , dând ). Sistemul devine:
Prima linie impune lipsa de bias (); a doua și a treia linie anulează termenii de eroare Trotter de ordin principal și, respectiv, de ordin următor .
Configurarea LSE
Folosim setup_static_lse din qiskit_addon_mpf.static pentru a construi matricea și vectorul din dreapta descriși mai sus. Matricea depinde nu doar de , ci și de alegerea noastră de formulă de produs — în special de ordinul al acesteia și de faptul dacă este simetrică. Steagul symmetric controlează tiparul exponenților (formulele simetrice produc doar termeni de eroare Trotter de putere pară; vezi Ref. [1]). Rețineți că, așa cum se arată în Ref. [2], setarea symmetric=True nu este strict necesară chiar și atunci când PF-ul de bază este simetric — LSE-ul nesimetric rămâne valid (impune constrângeri suplimentare inutile).
Pentru exemplul nostru am setat deja order = 2 și symmetric = False în Pasul 1.
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
Inspectează matricea și vectorul construite pentru a confirma că se potrivesc cu sistemul scris mai sus.
lse.A
array([[1.      , 1.      , 1.      ],
       [1.      , 0.25    , 0.0625  ],
       [1.      , 0.125   , 0.015625]])
lse.b
array([1., 0., 0.])
Cu LSE-ul la îndemână, rezolvăm pentru coeficienții statici prin lse.solve() (aceasta este soluția directă ).
mpf_coeffs = lse.solve()
print(
    f"The static coefficients associated with the ansatze are: {mpf_coeffs}"
)
The static coefficients associated with the ansatze are: [ 0.04761905 -0.57142857 1.52380952]
Optimizarea pentru folosind un model exact
Ca alternativă la calculul , poți folosi setup_exact_model pentru a construi o instanță cvxpy.Problem care utilizează LSE ca constrângeri și a cărei soluție optimă va produce .
model_exact, coeffs_exact = setup_exact_problem(lse)
model_exact.solve()
print(coeffs_exact.value)
[ 0.04761905 -0.57142857 1.52380952]
print(
    "L1 norm of the exact coefficients:",
    np.linalg.norm(coeffs_exact.value, ord=1),
)
L1 norm of the exact coefficients: 2.1428571428556378
Optimizarea pentru folosind un model aproximativ
S-ar putea întâmpla ca norma pentru setul ales de valori să fie considerată prea mare. Dacă acesta este cazul și nu poți alege un set diferit de valori , poți folosi o soluție aproximativă care constrânge norma la un prag ales, minimizând în același timp . Consultă ghidul Cum să folosești modelul aproximativ.
model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=1.5
)
model_approx.solve()
print(coeffs_approx.value)
print(
    "L1 norm of the approximate coefficients:",
    np.linalg.norm(coeffs_approx.value, ord=1),
)
[-1.10294118e-03 -2.48897059e-01  1.25000000e+00]
L1 norm of the approximate coefficients: 1.5
Coeficienți MPF dinamici
MPF-ul static anulează termenii de eroare Trotter într-un mod agnostic față de hamiltonian și stare, deci nu produce neapărat cea mai mică eroare de aproximare posibilă pentru un hamiltonian și o stare inițială date. MPF-ul dinamic (Refs. [2], [3]) găsește în schimb coeficienți dependenți de timp care minimizează distanța Frobenius la fiecare moment . Așa cum se arată în secțiunea Context, aceasta necesită matricea de suprapunere între stările evoluate prin Trotter și suprapunerea cu starea exactă — ambele fiind estimate folosind backend-uri de rețele tensoriale (TeNPy) în qiskit_addon_mpf.
Pentru a configura LSE-ul dinamic avem nevoie de trei ingrediente:
-
O fabrică de evoluție aproximativă pe care addon-ul o va rula pentru fiecare pentru a produce ca MPS/MPO. O construim din structura pe straturi a circuitului Trotter de ordinul (un strat per
slice_by_depth), încapsulată caLayerwiseEvolvercu parametri de trunchiere TeNPy. -
O fabrică de evoluție exactă care produce o referință de înaltă precizie . Folosim un circuit Suzuki-Trotter de ordinul patru cu pas de timp mic (
dt=0.1,order=4) ca proxy pentru evoluția exactă. -
O fabrică de identitate și un MPS pentru starea inițială care inițializează simularea TeNPy.
Celula de mai jos construiește fabrica de evoluție aproximativă.
# Create approximate time-evolution circuits
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)  # collect XX and YY

# Find layers in the circuit
layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)

# Create tensor network models
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

# Create the time-evolution object
approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
Opțiunile LayerwiseEvolver care determină detaliile simulării rețelei tensoriale trebuie alese cu atenție pentru a evita configurarea unei probleme de optimizare prost definite.
Aproximăm starea evoluată exact în timp cu o formulă Suzuki-Trotter de ordinul patru, folosind un pas de timp mic dt=0.1. Parametrii de trunchiere TeNPy pot afecta acuratețea, deci este important să explorezi o gamă de valori.
single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
În cele din urmă, definim o identity_factory care produce starea MPO inițială și pregătim starea inițială Néel ca un MPS care se potrivește cu rețeaua folosită de modelul Trotter pe straturi.
def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)
Cu fabricile în loc, calculăm acum coeficienții dinamici la fiecare moment de evoluție. Pentru fiecare , setup_dynamic_lse construiește matricele de suprapunere relevante prin TeNPy, iar setup_frobenius_problem returnează o cvxpy.Problem care minimizează costul normei Frobenius. Rezolvatorul returnează coeficienți adaptați acelui timp; îi colectăm în mpf_dynamic_coeffs_list. Dacă rezolvatorul eșuează pentru un anumit , revenim la coeficienți zero pentru ca bucla să continue.
mpf_dynamic_coeffs_list = []
for t in trotter_times:
    print(f"Computing dynamic coefficients for time={t}")
    lse = setup_dynamic_lse(
        mpf_trotter_steps,
        t,
        identity_factory,
        exact_factory,
        approx_factory,
        mps_initial_state,
    )
    problem, coeffs = setup_frobenius_problem(lse)
    try:
        problem.solve()
        mpf_dynamic_coeffs_list.append(coeffs.value)
    except Exception as error:
        mpf_dynamic_coeffs_list.append(np.zeros(len(mpf_trotter_steps)))
        print(error, "Calculation Failed for time", t)
    print("")
Computing dynamic coefficients for time=0.5

Computing dynamic coefficients for time=0.6

Computing dynamic coefficients for time=0.7

Computing dynamic coefficients for time=0.7999999999999999

Computing dynamic coefficients for time=0.8999999999999999

Computing dynamic coefficients for time=0.9999999999999999

Computing dynamic coefficients for time=1.0999999999999999

Computing dynamic coefficients for time=1.1999999999999997

Computing dynamic coefficients for time=1.2999999999999998

Computing dynamic coefficients for time=1.4

Computing dynamic coefficients for time=1.4999999999999998
Combină valorile de așteptare Trotter cu coeficienții MPF
Acum evaluăm pentru fiecare set de coeficienți (static-exact, static-aproximativ și dinamic), propagăm erorile standard per circuit și trasăm seria temporală rezultată față de curba diagonalizării exacte.
sym = {1: "^", 2: "s", 4: "p"}
# Get expectation values at all times for each Trotter step
for k, step in enumerate(mpf_trotter_steps):
    trotter_curve, trotter_curve_error = [], []
    for trotter_expvals, trotter_stds in zip(
        mpf_expvals_all_times, mpf_stds_all_times
    ):
        trotter_curve.append(trotter_expvals[k])
        trotter_curve_error.append(trotter_stds[k])

    plt.errorbar(
        trotter_times,
        trotter_curve,
        yerr=trotter_curve_error,
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

# Get expectation values at all times for the static MPF with exact coeffs
exact_mpf_curve, exact_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_exact.value, trotter_stds)
            ]
        )
    )
    exact_mpf_curve_error.append(mpf_std)
    exact_mpf_curve.append(trotter_expvals @ coeffs_exact.value)

plt.errorbar(
    trotter_times,
    exact_mpf_curve,
    yerr=exact_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Exact",
    color="purple",
)

# Get expectation values at all times for the static MPF with approximate coeffs
approx_mpf_curve, approx_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_approx.value, trotter_stds)
            ]
        )
    )
    approx_mpf_curve_error.append(mpf_std)
    approx_mpf_curve.append(trotter_expvals @ coeffs_approx.value)

plt.errorbar(
    trotter_times,
    approx_mpf_curve,
    yerr=approx_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Approx",
    color="orange",
)

# Get expectation values at all times for the dynamic MPF
dynamic_mpf_curve, dynamic_mpf_curve_error = [], []
for trotter_expvals, trotter_stds, dynamic_coeffs in zip(
    mpf_expvals_all_times, mpf_stds_all_times, mpf_dynamic_coeffs_list
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(dynamic_coeffs, trotter_stds)
            ]
        )
    )
    dynamic_mpf_curve_error.append(mpf_std)
    dynamic_mpf_curve.append(trotter_expvals @ dynamic_coeffs)

plt.errorbar(
    trotter_times,
    dynamic_mpf_curve,
    yerr=dynamic_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Dynamic MPF",
    color="pink",
)

# Exact expectation values
plt.plot(
    exact_evolution_times,
    exact_expvals,
    color="red",
    linestyle="--",
    label="Exact time-evolution",
)

plt.title(f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ vs time")
plt.xlabel("Time")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Graficul de mai sus ilustrează interacțiunea dintre eroarea Trotter și eroarea de eșantionare.
-
Eroarea Trotter. Formulele de produs individuale (markeri gri) se abat de la curba exactă tot mai mult pe măsură ce timpul crește. Circuitul are cea mai mare abatere și este cel mai puțin adânc, dar se află deja în regimul în care , deci termenul de eroare principal este mare. Combinațiile MPF (markeri colorați) anulează mai mulți dintre acești termeni de eroare Trotter principali, deci urmăresc curba exactă mult mai fidel decât orice circuit individual . Diferența rămasă reflectă termenii Trotter de ordin superior pe care MPF-ul nu îi anulează: un MPF static de ordin , elimină doar primele două ordine de eroare, iar la mare, coada necompensată ajunge în cele din urmă să domine — deci MPF-ul nu garantează că circuitele foarte puțin adânci rămân precise la timpi arbitrari.
-
Eroarea de eșantionare. Barele de eroare mai late pe curbele MPF sunt o consecință directă a combinației liniare: propagarea erorilor standard independente per circuit dă o varianță totală . Prin urmare, cu cât este mai mare (și, în practică, , pe care îl controlăm), cu atât sunt necesare mai multe shot-uri pentru a atinge o incertitudine țintă dată. Acesta este compromisul din spatele opțiunii de rezolvator aproximativ din secțiunea Context: limităm pentru a menține acest cost sub control. Important, spre deosebire de eroarea Trotter, eroarea de eșantionare scade cu , deci poate fi întotdeauna redusă cheltuind mai multe shot-uri.
În exemplul la scară mare pe hardware de mai jos, zgomotul hardware apare ca o sursă suplimentară de eroare pentru fiecare , care este amplificată similar de coeficienții MPF. Vom vedea cum interacționează atenuarea erorilor cu MPF-urile în acea secțiune.
Exemplu la scară mare pe hardware
În această secțiune extindem problema dincolo de ceea ce poate fi simulat exact. Reproducem unele dintre rezultatele prezentate în Ref. [3], folosind un lanț XXZ cu 50 de qubiți la timpul . Urmăm același flux de lucru în patru pași ca exemplul la scară mică, vizând acum hardware cuantic real cu atenuarea erorilor. Ca și în șablon, fiecare pas este marcat inline în cod, iar un singur pas poate cuprinde mai multe celule atunci când ieșirile intermediare merită inspectate. Maparea reflectă exemplul la scară mică: definim un hamiltonian, alegem parametrii Trotter, calculăm coeficienții MPF (statici și dinamici) și construim circuite. Diferențele cheie sunt:
-
Un hamiltonian XXZ pe 50 de situri cu cuplaje aleatoare extrase din (Ref. [3]).
-
O formulă Trotter de ordinul doi simetrică cu (deci ,
symmetric=True). -
Un singur timp de evoluție fix . Cu aceasta dă , menținând constituenții puțin adânci în regimul de convergență Trotter în care modelul de eroare principal pe care se bazează MPF-ul este valid.
-
O rulare suplimentară de comparație cu un singur circuit cu pași Trotter, folosită drept referință. Am ales deoarece adâncimea sa în porți cu doi qubiți pe hardware este mai mare decât cea a celui mai adânc constituent MPF () plus costul de a rula mai multe circuite MPF — suficient de adâncă pentru a fi limitată de zgomot, care este regimul în care se așteaptă ca combinația MPF să depășească referința cu un singur circuit. Este o comparație de tip "un singur circuit adânc" față de combinația MPF, nu un circuit care vizează eroarea Trotter efectivă a MPF-ului (ceea ce ar necesita mult mai mulți pași).
Rețineți că, deși ne aflăm încă la Pasul 1 aici (mapare și construcție de circuite), precalculăm de asemenea coeficienții dinamici alături de cei statici în această celulă. Coeficienții dinamici depind de și , dar nu de măsurătorile cuantice, deci pot fi calculați oricând înainte de Pasul 4. Facem acest lucru acum pentru a păstra toată configurarea specifică MPF-ului într-un singur loc.
# -------------------------Step 1-------------------------
L = 50
coupling_map = CouplingMap.from_line(L, bidirectional=False)

# XXZ Hamiltonian with random couplings (Ref. [3])
np.random.seed(0)
even_edges = list(coupling_map.get_edges())[::2]
odd_edges = list(coupling_map.get_edges())[1::2]

Js = np.random.uniform(0.5, 1.5, size=L)
hamiltonian = SparsePauliOp(Pauli("I" * L))
for i, edge in enumerate(even_edges + odd_edges):
    hamiltonian += SparsePauliOp.from_sparse_list(
        [
            ("XX", (edge), 2 * Js[i]),
            ("YY", (edge), 2 * Js[i]),
            ("ZZ", (edge), 4 * Js[i]),
        ],
        num_qubits=L,
    )

observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)

total_time = 3
mpf_trotter_steps = [3, 4, 6]
order = 2
symmetric = True

# Static coefficients
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
mpf_coeffs = lse.solve()
print(f"Static coefficients: {mpf_coeffs}")
print(f"L1 norm: {np.linalg.norm(mpf_coeffs, ord=1)}")

model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=2.0
)
model_approx.solve()
print(f"Approximate coefficients: {coeffs_approx.value}")
print(f"L1 norm (approx): {np.linalg.norm(coeffs_approx.value, ord=1)}")

# -------------------------Dynamic coefficients-------------------------
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)

layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 4,
    },
)

single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 3,
    },
)

def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)

print(f"Computing dynamic coefficients for time={total_time}")
lse_dyn = setup_dynamic_lse(
    mpf_trotter_steps,
    total_time,
    identity_factory,
    exact_factory,
    approx_factory,
    mps_initial_state,
)
problem, coeffs_dyn = setup_frobenius_problem(lse_dyn)
try:
    problem.solve()
    mpf_dynamic_coeffs = coeffs_dyn.value
except Exception as error:
    mpf_dynamic_coeffs = np.zeros(len(mpf_trotter_steps))
    print(error, "Calculation Failed")

# -------------------------Step 1 (cont): Build circuits-------------------------
mpf_circuits = []
for k in mpf_trotter_steps:
    circuit = QuantumCircuit(L)
    circuit.x([i for i in range(L) if i % 2])
    trotter_circ = generate_time_evolution_circuit(
        hamiltonian,
        synthesis=SuzukiTrotter(reps=k, order=order),
        time=total_time,
    )
    circuit.compose(trotter_circ, qubits=range(L), inplace=True)
    mpf_circuits.append(circuit)

# Baseline "single deep circuit" comparison run with k=10 Trotter steps.
# Its two-qubit depth is deeper than the deepest MPF constituent (k_max=6) plus
# the overhead of running multiple circuits, pushing it into the noise-limited
# regime where MPF is expected to outperform. It does NOT target the MPF's effective
# Trotter error (which would require many more steps).
comp_circuit = QuantumCircuit(L)
comp_circuit.x([i for i in range(L) if i % 2])
trotter_circ = generate_time_evolution_circuit(
    hamiltonian,
    synthesis=SuzukiTrotter(reps=10, order=order),
    time=total_time,
)
comp_circuit.compose(trotter_circ, qubits=range(L), inplace=True)
mpf_circuits.append(comp_circuit)
Static coefficients: [ 0.42857143 -1.82857143  2.4       ]
L1 norm: 4.65714285714286
Approximate coefficients: [-0.4942491   0.40206845  1.09218065]
L1 norm (approx): 1.9884981979026675
Computing dynamic coefficients for time=3
Acum optimizăm circuitele pentru backend-ul ales. Folosim managerul de pass-uri predefinit Qiskit la optimization_level=3, care selectează automat un set bun de qubiți fizici și rutează fiecare circuit pe topologia dispozitivului.
# -------------------------Step 2-------------------------
service = QiskitRuntimeService()
# backend = service.least_busy(operational=True, simulator=False, min_num_qubits=L)
backend = service.backend("ibm_fez")
print(backend)

transpiler = generate_preset_pass_manager(
    optimization_level=3, backend=backend
)
transpiled_circuits = [transpiler.run(circ) for circ in mpf_circuits]

isa_observables = [
    observable.apply_layout(circ.layout) for circ in transpiled_circuits
]
<IBMBackend('ibm_fez')>
Rularea circuitelor mai adânci pe hardware real necesită atenuarea agresivă a erorilor. Activăm decuplarea dinamică, twirling-ul de porți și de măsurare, atenuarea erorii de măsurare și extrapolarea la zgomot zero (ZNE). Rețineți că factorii de zgomot ZNE pe care îi folosim aici (1, 1.2, 1.4) sunt mai mici decât într-un scenariu cu circuit puțin adânc, deoarece constituenții MPF mai adânci sunt deja aproape de pragul de zgomot, iar amplificări mari de zgomot i-ar împinge dincolo de punctul în care extrapolarea ZNE este fiabilă.
Trimitem toate cele patru circuite (trei constituenți MPF la plus referința ) într-un singur job Estimator.
# -------------------------Step 3-------------------------
estimator = Estimator(mode=backend)
estimator.options.default_shots = 30000

# Error suppression/mitigation
estimator.options.dynamical_decoupling.enable = True
estimator.options.twirling.enable_gates = True
estimator.options.twirling.enable_measure = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.twirling.strategy = "active-accum"
estimator.options.resilience.measure_mitigation = True
estimator.options.experimental.execution_path = "gen3-turbo"

estimator.options.resilience.zne_mitigation = True
estimator.options.resilience.zne.noise_factors = (1, 1.2, 1.4)
estimator.options.resilience.zne.extrapolator = "linear"

estimator.options.environment.job_tags = ["TUT_MPF"]

job_50 = estimator.run(
    [
        (circ, observable)
        for circ, observable in zip(transpiled_circuits, isa_observables)
    ]
)
Extragem valorile de așteptare per circuit și deviațiile standard din rezultatul job-ului, apoi le combinăm cu fiecare set de coeficienți MPF exact ca în exemplul la scară mică: , cu varianța propagată .
# -------------------------Step 4-------------------------
result = job_50.result()
evs = [res.data.evs for res in result]
std = [res.data.stds for res in result]

print(evs)
print(std)
[array(-0.07916195), array(-0.04479681), array(-0.2560756), array(-0.06045848)]
[array(0.04605538), array(0.10056336), array(0.14426151), array(0.04059092)]
exact_mpf_std = np.sqrt(
    sum([(coeff**2) * (std**2) for coeff, std in zip(mpf_coeffs, std[:3])])
)
print(
    "Exact static MPF expectation value: ",
    evs[:3] @ mpf_coeffs,
    "+-",
    exact_mpf_std,
)
approx_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(coeffs_approx.value, std[:3])
        ]
    )
)
print(
    "Approximate static MPF expectation value: ",
    evs[:3] @ coeffs_approx.value,
    "+-",
    approx_mpf_std,
)
dynamic_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(mpf_dynamic_coeffs, std[:3])
        ]
    )
)
print(
    "Dynamic MPF expectation value: ",
    evs[:3] @ mpf_dynamic_coeffs,
    "+-",
    dynamic_mpf_std,
)
Exact static MPF expectation value:  -0.5665938395816946 +- 0.3925273058119915
Approximate static MPF expectation value:  -0.25856647611537903 +- 0.164249927266166
Dynamic MPF expectation value:  -0.12667812062949296 +- 0.06059471006973169
sym = {3: "^", 4: "s", 6: "p"}
for k, step in enumerate(mpf_trotter_steps):
    plt.errorbar(
        k,
        evs[k],
        yerr=std[k],
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

plt.errorbar(
    3,
    evs[-1],
    yerr=std[-1],
    alpha=0.5,
    markersize=8,
    marker="x",
    color="blue",
    label="10 Trotter steps",
)

plt.errorbar(
    4,
    evs[:3] @ mpf_coeffs,
    yerr=exact_mpf_std,
    markersize=4,
    marker="o",
    color="purple",
    label="Static MPF",
)

plt.errorbar(
    5,
    evs[:3] @ coeffs_approx.value,
    yerr=approx_mpf_std,
    markersize=4,
    marker="o",
    color="orange",
    label="Approximate static MPF",
)

plt.errorbar(
    6,
    evs[:3] @ mpf_dynamic_coeffs,
    yerr=dynamic_mpf_std,
    markersize=4,
    marker="o",
    color="pink",
    label="Dynamic MPF",
)

exact_obs = -0.24384471447172074  # Calculated via Tensor Network calculation
plt.axhline(
    y=exact_obs, linestyle="--", color="red", label="Exact time-evolution"
)

plt.title(
    f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ at time {total_time} for the different methods"
)
plt.xlabel("Method")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Câteva observații despre rezultatele hardware de mai sus:
-
A merge mai adânc nu este gratuit pe hardware. Referințele cu un singur circuit spun direct povestea: circuitul este practic exact ( față de referința ), totuși referința mai adâncă este mai proastă (, decalată cu ), nu mai bună. Odată ce eroarea Trotter este deja mică, adăugarea de pași aprofundează în principal circuitul și acumulează mai mult zgomot de porți și decoerență. Acesta este exact regimul pentru care sunt construite MPF-urile: să atingi acuratețea unui circuit adânc folosind doar constituenți puțin adânci.
-
Un MPF cu normă mică bate circuitul unic adânc. MPF-ul static aproximativ (limitat la ) ajunge la , la de referință și mult mai aproape decât referința . MPF-ul dinamic () depășește de asemenea confortabil acea referință. Ambele combină doar circuitele puțin adânci , totuși recuperează un răspuns pe care circuitul unic adânc nu l-a putut obține.
-
Norma coeficienților contează mai mult decât optimalitatea matematică. MPF-ul static exact are și este cel mai prost estimator dintre toți (, decalat cu peste ): norma mare a coeficienților amplifică zgomotul rezidual de porți, decoerența și eroarea ZNE pentru fiecare cu aproximativ același factor, copleșind câștigul de anulare a erorii Trotter pe care îl aduce. Limitarea normei (rezolvatorul static aproximativ, ) elimină acest efect copleșitor și oferă cea mai bună estimare — chiar dacă coeficienții săi nu mai anulează exact eroarea Trotter principală.
-
Circuitele individuale puțin adânci pot fi în continuare competitive. Constituentul singular () este el însuși practic exact aici — în această rulare este chiar marginal mai aproape decât MPF-ul static aproximativ. Problema este că nu știi din timp care individual se află în punctul optim de "convergent, dar încă nelimitat de zgomot", iar alegerea aparent sigură de a merge pur și simplu mai adânc () pentru a garanta convergența Trotter este exact cea care eșuează. MPF-ul oferă o combinație principială de circuite puțin adânci care nu necesită ghicirea adâncimii corecte.
Concluzia practică este că pe hardware, MPF-urile ar trebui asociate cu o atenuare puternică a erorilor pentru fiecare individual, norma a coeficienților ar trebui menținută modestă (folosește rezolvatorul aproximativ sau MPF-ul dinamic), iar pașii Trotter ar trebui aleși astfel încât — aici la dă , menținând constituenții în regimul convergent în care modelul de eroare principal pe care se bazează MPF-ul static este valid. Cu aceste alegeri, MPF-urile cu normă mică de aici se potrivesc cu un circuit unic convergent, în timp ce referința naivă "pur și simplu mergi mai adânc" nu reușește, recuperând avantajul adâncime-versus-acuratețe prezentat în Ref. [3]. Rețineți de asemenea că rulările individuale sunt zgomotoase — la o altă trimitere a aceluiași job (sau pe un alt backend), ordinea exactă se poate schimba; tendințele robuste sunt că MPF-urile cu mic funcționează bine, MPF-ul static exact cu mare este amplificat de zgomotul hardware, iar circuitul unic prea adânc este limitat de zgomot.
Pași următori
Dacă ai găsit interesantă această lucrare, s-ar putea să te intereseze următoarele materiale:
- Cum să alegi pașii Trotter pentru un MPF — ghidare practică pentru alegerea valorilor pentru a evita instabilitățile
- Cum să folosești modelul aproximativ — reglarea constrângerii normei și a opțiunilor rezolvatorului pentru MPF-ul static aproximativ
- Referința API
qiskit-addon-mpf— documentație completă pentru modulele statice, dinamice și de backend
Referințe
[1] Vazquez, A. C., Egger, D. J., Ochsner, D., & Woerner, S. Well-conditioned multi-product formulas for hardware-friendly Hamiltonian simulation. Quantum, 7, 1067 (2023)
[2] Zhuk, S., Robertson, N. F., & Bravyi, S. Trotter error bounds and dynamic multi-product formulas for Hamiltonian simulation. Physical Review Research, 6(3), 033309 (2024)
[3] Robertson, N. F., et al. Tensor network enhanced dynamic multiproduct formulas. arXiv:2407.17405 (2024)