Învață stări cuantice zgomotoase cu umbre clasice
Estimare de utilizare: 34 de minute pe un procesor Heron r2 (NOTĂ: Aceasta este doar o estimare. Timpul tău de execuție poate varia.)
Obiective de învățare
-
Colectează măsurători aleatorizate pe un procesor cuantic IBM® din Julia și salvează-le pentru analiză ulterioară
-
Verifică datele de măsurare pentru qubiți și porți defecte înainte de învățare
-
Potrivește un model de tip operator produs de matrice (MPO) al unei stări zgomotoase la umbre clasice
-
Validează modelul pe măsurători păstrate deoparte și compară-l cu circuitul ideal
Cerințe preliminare
-
Umbre clasice, așa cum sunt introduse în tutorialul Tomografia prin umbre a stării Greenberger-Horne-Zeilinger (GHZ)
-
Matrice densitate și stări mixte, tratate în Bazele informației cuantice
-
Rularea circuitelor din Julia cu
Qiskit.jlșiQiskitIBMRuntime.jl, introdusă în tutorialul Simularea evoluției în timp a modelului Ising cu câmp transversal
Context
Pe un procesor cuantic real, zgomotul transformă starea pură pe care un circuit este conceput să o pregătească într-o stare mixtă . Tomografia completă a stării cuantice poate reconstrui , dar numărul de măsurători de care are nevoie crește exponențial cu numărul de qubiți. În schimb, Votto et al. [1] au învățat un model compact al lui pentru până la 96 de qubiți din măsurători aleatorizate. Acest tutorial urmează fluxul lor de lucru.
Într-o măsurătoare aleatorizată [2], fiecare qubit este rotit de o unitară aleatorie independentă și apoi măsurat în baza computațională. O extragere a rotațiilor se numește setare de măsurare, iar fiecare setare este repetată pentru execuții. O execuție cu biții de rezultat dă umbra clasică [3]
a cărei medie peste setări și execuții este . Tutorialul prerechizit extrage fiecare din cele trei baze Pauli; acest tutorial, ca și lucrarea, le extrage uniform din toate unitarele pe un singur qubit (aleatorii Haar), iar aceeași formulă se aplică.
Umbrele estimează proprietățile câtorva qubiți la un moment dat. Lucrarea le combină într-un operator produs de matrice (MPO), care scrie matricea densitate ca un lanț de tensori mici, câte unul pe qubit; stările zgomotoase cu corelații pe distanță scurtă au nevoie doar de legături mici între tensorii vecini. Ca și algoritmul grupului de renormalizare al matricei densitate (DMRG), algoritmul de învățare parcurge lanțul și actualizează câte un tensor, astfel încât modelul să se potrivească cu umbrele pe fereastra de qubiți centrată pe acel tensor (Ecuația 4 din lucrare). Dimensiunea legăturii rămâne fixă în timpul acestor actualizări, deci algoritmul de învățare nu trunchiază niciodată modelul. Deoarece datele intră doar prin aceste ferestre, numărul de setări necesare nu crește cu lungimea lanțului.
Setările sunt împărțite într-un set de antrenare și un set de testare. Pe setul de testare, lucrarea estimează fidelitatea maximă dintre și modelul ,
Măsurarea directă a lui ar necesita un număr exponențial de măsurători. În schimb, lucrarea presupune condiția de factorizare aproximativă (AFC): corelațiile din scad în câțiva qubiți, astfel încât suprapunerile și puritățile globale se factorizează în termeni pe blocuri de qubiți vecini. Puritatea oferă și entropia Rényi-2 , care măsoară cât de mixtă este starea.
Lucrarea pregătește starea Ising cu lovituri de adâncime
pe 96 de qubiți ai lui ibm_brisbane, un procesor Eagle, cu 2.048 de setări de câte 1.024 de execuții pentru . Figura 1(c,d) din lucrare raportează două rezultate pentru :
-
Modelul învățat atinge cu starea experimentală la , cu mult peste suprapunerea stării ideale cu experimentul.
-
Entropia crește liniar, , iar entropia modelului concordă cu o estimare independentă din setul de testare.
Acest tutorial verifică ambele rezultate, mai întâi într-o simulare cu opt qubiți în care răspunsurile exacte sunt cunoscute, apoi într-o nouă rulare pe 96 de qubiți pe ibm_fez, un procesor Heron r2. Algoritmul de învățare este o implementare Julia independentă a ecuațiilor din lucrare și din suplimentul ei.
Cerințe
Acest tutorial necesită macOS sau Linux, deoarece Qiskit.jl nu acceptă încă Windows (Qiskit.jl issue #15). Mai ai nevoie de următoarele:
-
Julia 1.11, de pe pagina de descărcare Julia sau cu
juliaup add 1.11, și pachetulIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Pentru exemplul pe hardware, un cont IBM Quantum® Platform cu acces la un QPU cu cel puțin 96 de qubiți și credențiale salvate. Fără un cont, poți rula exemplul pe hardware din măsurătorile salvate ale rulării
ibm_fezcare a produs rezultatele din acest tutorial. Celelalte secțiuni rulează fără cont.
Notebook-ul folosește Qiskit.jl și QiskitIBMRuntime.jl pentru a construi și a rula circuite, RandomMeas.jl [4] pentru măsurători aleatorizate (care oferă și ITensors.jl și ITensorMPS.jl), precum și NPZ.jl, JSON.jl și Plots.jl. Acest tutorial este testat cu Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 și RandomMeas.jl 0.3.1.
Există două moduri de a configura mediul:
-
Opțiunea 1: Instalează cele mai recente versiuni compatibile ale pachetelor într-un mediu temporar. Rulează celula următoare fără modificări.
-
Opțiunea 2: Reproduce exact mediul testat. Setează
download_toml_files = trueîn celula următoare. Celula descarcăProject.tomlșiManifest.tomldin depozitul de documentație într-un folderenv_tutorial/classical-shadows/de lângă acest notebook, apoi instalează versiunea exactă a fiecărui pachet înregistrat în manifest, inclusiv dependențele indirecte. Pentru detalii, vezi documentația Julia despre aceste fișiere.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Configurare
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Modulul auxiliar mpo_learning.jl, pe care celula Setup îl descarcă, implementează algoritmul de învățare. Tutorialul apelează din el următoarele funcții:
| Funcție | Scop |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO exact al stării Ising cu lovituri ideale sau al stării după zgomot depolarizant local |
split_settings(group; seed, train_fraction) | Atribuie aleatoriu setările de măsurare seturilor de antrenare și de testare (jumătate fiecare, implicit) |
training_marginals(train; ell, prior) | Estimări prin umbre ale fiecărei ferestre de învățare, doar din setările de antrenare |
fitted_prior(ideal, train) | Prior pentru măsurători aleatorizate comune (CRM), potrivit la puritatea măsurată a fiecărei ferestre, ca în lucrare |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Parcurge actualizarea pe un singur situs din lucrare de-a lungul lanțului, pornind de la starea maxim mixtă |
max_fidelity(a, b), mpo_overlap(a, b) | exact și între doi MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Estimări AFC ale și din setările de testare, cu bare de eroare jackknife |
Algoritmul de învățare stochează MPO în baza Pauli. Aceasta menține modelul hermitian cu urmă unitară, dar nu forțează modelul să fie pozitiv semidefinit, așa că notebook-ul raportează cât de negative devin valorile sale proprii.
Exemplu la scară mică cu simulator
Începe cu un sistem suficient de mic pentru a calcula totul exact: starea Ising cu lovituri de adâncime unu pe opt qubiți, cu zgomot depolarizant local de 12% pentru a modela hardware-ul. Deoarece starea zgomotoasă este cunoscută, poți compara direct modelul învățat cu ea.
Pasul 1: Transpune intrările clasice într-o problemă cuantică
Funcția kicked_ising_reference returnează starea exactă ca MPO. Cu depolarization=0.12, vectorul Bloch al fiecărui qubit se micșorează cu 12% după circuit.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Pasul 2: Optimizează problema pentru execuția pe hardware cuantic
Acest exemplu eșantionează clasic rezultatele măsurătorilor, deci nu există niciun circuit de transpilat. Exemplul pe hardware tratează acest pas.
Pasul 3: Execută folosind primitivele Qiskit
Folosește RandomMeas.jl pentru a extrage 2.048 de setări de măsurare aleatorii Haar și a eșantiona 256 de execuții din fiecare, apoi împarte setările în mod egal în seturi de antrenare și de testare. Împarte după setare, nu după execuție: execuțiile din aceeași setare împart rotațiile ei, deci nu sunt independente.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Pasul 4: Postprocesează și returnează rezultatul în formatul clasic dorit
Învață modelul cu parametrii de adâncime unu din lucrare: ferestre care se extind cu qubiți de fiecare parte a tensorului actualizat, o dimensiune a legăturii de 4 și 20 de parcurgeri pornind de la starea maxim mixtă. Prima parcurgere actualizează perechi vecine de tensori, ceea ce permite dimensiunii legăturii să crească de la 1 la 4; fiecare parcurgere ulterioară actualizează câte un tensor la acea dimensiune fixă a legăturii.
Pentru a reduce zgomotul statistic al umbrelor, lucrarea folosește măsurători aleatorizate comune (CRM) [5]. Pentru fiecare setare, scade umbra medie pe care o presupunere prior despre stare ar produce-o în aceeași setare, apoi adaugă la loc valoarea exactă a prior-ului. Corecția are media zero, deci prior-ul schimbă mărimea erorii statistice, dar nu ceea ce se estimează. Aici prior-ul este starea ideală cu depolarizare locală de 10%, aproape de cei 12% reali. Pe hardware, nivelul de zgomot este necunoscut, așa că exemplul pe hardware potrivește prior-ul la puritățile măsurate, ca în lucrare.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
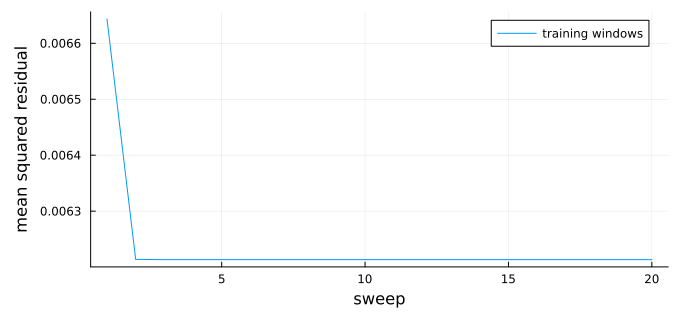
Reziduul măsoară cât de departe sunt ferestrele modelului de umbrele de antrenare. Scade când încep actualizările pe un singur situs, în a doua parcurgere, apoi rămâne aproximativ constant în loc să ajungă la zero, deoarece umbrele conțin zgomot statistic pe care un model cu dimensiune mică a legăturii nu îl poate reproduce.
Deoarece această stare este cunoscută, poți compara exact modelul învățat cu ea și poți compara cu ea și cele două presupuneri cele mai simple: prior-ul CRM și starea ideală.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Modelul învățat este mai aproape de starea zgomotoasă decât prior-ul sau starea ideală, deci a învățat zgomotul din date. Valorile sale proprii negative mici provin din numărul finit de măsurători.
Pe hardware, starea este necunoscută, așa că estimezi din setările de testare. AFC împarte lanțul în blocuri de câte qubiți și aproximează puritatea prin
și prin același raport de suprapuneri locale. Cu , cele două blocuri acoperă toți cei opt qubiți și formula este exactă; cu , se bazează pe ipoteza de factorizare. Barele de eroare jackknife, care omit pe rând câte o setare de testare, acoperă doar eroarea statistică a datelor de testare, nu aleatorismul antrenării sau aproximarea AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Ambele estimări păstrate deoparte concordă cu valoarea exactă în limitele barelor lor de eroare.
Exemplu la scară mare pe hardware
Acum rulează experimentul pe un lanț de 96 de qubiți al lui ibm_fez, un procesor Heron r2. Ca și ibm_brisbane, are o hartă de cuplare heavy-hex și un nivel de zgomot similar.
Colectarea datelor necesită 1.024 de joburi Sampler și aproximativ 34 de minute de timp QPU. Dacă nu ai acces la un QPU cu cel puțin 96 de qubiți sau coada este lungă, rulează exemplul pe hardware pornind de la măsurătorile înregistrate pe ibm_fez la 27 septembrie 2026, care au produs rezultatele prezentate în acest tutorial. Cu use_saved_data = true, notebook-ul descarcă aceste măsurători (15 MB) de pe Zenodo [6] în Pasul 1 și omite trimiterea joburilor în Pasul 3. Pentru a-ți colecta propriile date, setează-l la false.
use_saved_data = true; # set to false to collect new measurements on hardware
Pasul 1: Transpune intrările clasice într-o problemă cuantică
Fiecare setare necesită un circuit: circuitul kicked-Ising, o poartă pe fiecare qubit pentru și o măsurătoare a fiecărui qubit. Eșantionarea , cu , și uniforme în , face ca să fie aleatoare Haar. Funcția u3_matrix returnează matricea lui , pe care o folosește Pasul 4.
Bugetul este de 1.024 de setări cu 1.024 de shoturi fiecare, jumătate din numărul de setări din articol, împărțite egal între antrenare și testare. Cu datele salvate, celula încarcă unghiurile înregistrate. Altfel, generează unghiuri noi și le salvează înainte de a trimite ceva, deoarece nu poți analiza rezultatele fără ele. Dacă fișierul există deja, celula îl încarcă, astfel încât unghiurile să corespundă în continuare rezultatelor salvate după ce repornești sesiunea.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Pasul 2: Optimizează problema pentru execuția pe hardware cuantic
Un lanț este doar la fel de bun ca cel mai slab qubit al său, așa că alege singur cei 96 de qubiți fizici. Funcția transpile din Qiskit.jl nu poate încă accepta un layout inițial fix, iar într-un test pe ibm_phoenix, layout-ul ales de ea includea un qubit cu 51% eroare de citire. Următorul lanț este calea de 96 de qubiți din harta de cuplare ibm_fez pe care layout-ul sensibil la erori al funcției transpile din Qiskit Python (cu optimization_level=3) a selectat-o din datele de calibrare din 27 septembrie 2026. Eroarea medie de citire este de 1,6%, dar o rețea heavy-hex are puține căi de 96 de qubiți, iar aceasta include qubitul 35, care are o eroare de citire de 15%. Calibrările se schimbă, așa că alege un lanț nou din datele de calibrare curente înainte de a rula într-o altă zi sau pe un alt QPU.
Pentru a păstra acest lanț, scrie circuitele direct în porți native în loc să le transpilezi. O poartă este egală cu până la o fază globală. Această descompunere acoperă atât rotațiile aleatoare, cât și lovitura . Poarta este egală cu o poartă CZ urmată de pe ambii qubiți, până la o fază globală. Deoarece aceste porți sunt diagonale, ele comută cu porțile CZ, astfel încât fiecare qubit acumulează câte un pe legătură înainte de rotația sa de măsurare.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Pasul 3: Execută folosind primitivele Qiskit
QiskitIBMRuntime.jl rulează un circuit per job Sampler, deci colectarea datelor necesită 1.024 de joburi. Următoarea celulă păstrează până la 32 de joburi în coadă și salvează rezultatele fiecărei setări imediat ce jobul ei se termină. Fiecare shot este returnat ca un vector de biți, în care elementul este rezultatul qubitului din lanț.
Trebuie să recuperezi rezultatele în aceeași sesiune care a trimis joburile, deoarece QiskitIBMRuntime.jl nu poate încă să caute un job după ID (qiskit-ibm-runtime-c issue #28). Dacă un job eșuează, celula emite un avertisment și continuă. Dacă sesiunea se oprește, rulează din nou Pașii 1 până la 3. Rerularea celulei trimite doar setările ale căror rezultate lipsesc. Cu use_saved_data = true, celula nu trimite nimic.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Pasul 4: Post-procesează și returnează rezultatul în formatul clasic dorit
Acest pas citește doar date salvate: rularea ibm_fez descărcată dacă use_saved_data este true, sau altfel fișierele scrise de Pasul 3. Poți deci să-l rulezi într-o sesiune nouă fără a trimite joburi (rulează mai întâi celula Setup, celula use_saved_data și Pasul 1). Fișierul descărcat stochează cele 96 de rezultate ale fiecărui shot împachetate în 12 octeți, cu bitul cel mai semnificativ primul, așa că încărcătorul le despachetează. RandomMeas.jl etichetează rezultatele cu 1 și 2, deci încărcătorul adaugă și 1 la fiecare bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Înainte de învățare, verifică datele. Un qubit defect sau o poartă prost calibrată face starea măsurată mult mai mixtă în jurul său și poate face învățătorul să diverge. Puritatea câtorva qubiți vecini este un benchmark fără model al acestui zgomot: funcția get_purity din RandomMeas.jl estimează pentru un subsistem comparând perechi de shoturi din aceeași setare. Calculează entropia Rényi-2 a fiecărei ferestre de șase qubiți vecini și compar-o cu aceeași fereastră a stării ideale. Valoarea ideală nu este zero, deoarece fiecare fereastră este încâlcită cu restul lanțului; zgomotul o crește, iar un qubit defect împinge spre maximul de șase fiecare fereastră care îl conține.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
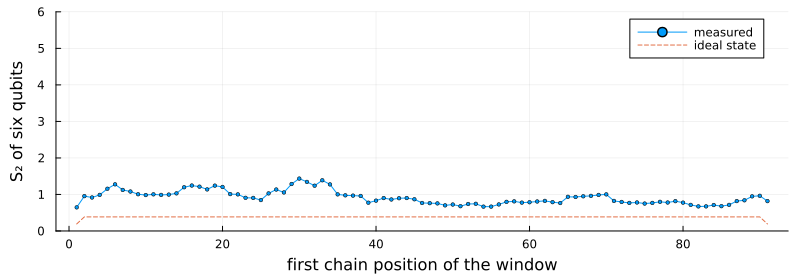
Fiecare fereastră este mai mixtă decât starea ideală, cu aproximativ o jumătate de bit până la un bit, iar porțiunea cea mai zgomotoasă este în jurul pozițiilor 30 până la 35 din lanț. Nicio fereastră nu se apropie de maximul de șase, deci niciun qubit nu este defect, iar analiza folosește întregul lanț de 96 de qubiți. Dacă unele ferestre ar avea o entropie apropiată de șase, ai elimina qubitul comun acelor ferestre și ai învăța cea mai lungă parte a lanțului fără el.
Aceleași puritați determină prior-ul CRM. Pentru fiecare fereastră, fitted_prior ia starea ideală și potrivește o intensitate locală de depolarizare astfel încât puritatea ei să corespundă purității măsurate în setările de antrenare, ca în articol.
Funcția learn_and_validate din celula următoare efectuează restul analizei. Ea învață modelul din setările de antrenare, apoi estimează și pe setările de testare pentru primii qubiți din lanț, în pași de 12. Acestea sunt mărimile din Figura 1(c,d) din articol. Starea ideală este evaluată pe aceleași date de testare ca referință.
Celula rulează funcția cu și apoi o repetă cu și pentru a vedea cât contează dimensiunea ferestrelor de învățare. Dimensiunea legăturii poate fi cel mult , deci învață o stare produs: fiecare qubit separat, fără corelații între qubiți.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
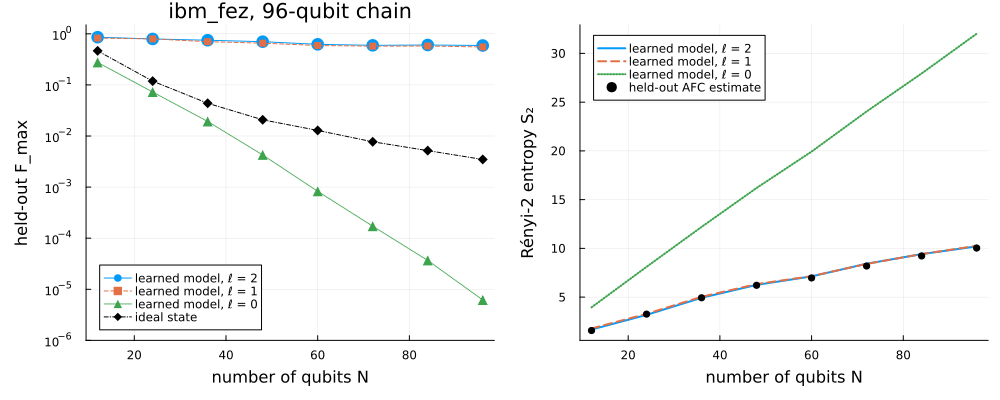
Rezultatele reproduc ambele afirmații din articol pe un procesor diferit:
-
Modelul descrie datele mult mai bine decât starea ideală. La , de testare al modelului cu este 0,59 ± 0,10, față de 0,0035 pentru starea ideală. Articolul raportează aproximativ 0,75 pe
ibm_brisbane. -
Entropia modelului concordă cu datele de testare pentru fiecare . La , este 10,2 din model și 10,0 ± 0,3 din datele de testare, adică , față de 0,14 până la 0,15 pe
ibm_brisbane, mai vechi.
Comparația dimensiunilor ferestrelor arată unde se află informația. Cu , modelul este aproape la fel de bun (), deci pentru aceste date, corelațiile dincolo de câțiva qubiți adaugă puțin. Cu , starea produs ratează încâlcirea dintre qubiții vecini: entropia ei crește la 32 în loc de 10, iar scade chiar mai repede decât cel al stării ideale, la pentru .
Ține cont de următoarele limitări când citești aceste numere:
-
Împărțirea antrenare/testare. Barele de eroare acoperă doar eroarea statistică a datelor de testare. Alte împărțiri aleatoare ale acelorași setări dau între 0,49 și 0,59 la pentru .
-
Baleiajul final. Învățătorul returnează întotdeauna modelul din baleiajul final, deci datele de testare nu influențează niciodată modelul.
-
Pozitivitate. Modelul nu este constrâns să fie semidefinit pozitiv; cea mai negativă valoare proprie a sa într-o fereastră de învățare este de aproximativ . Prin urmare, și ale sale descriu un operator, nu proprietăți certificate ale unei stări fizice.
-
Factorizare. Fiecare estimare de testare se bazează pe ipoteza AFC, pe care măsurătorile însele nu o pot certifica.
Pașii următori
-
Repetă experimentul la adâncimea doi cu parametrii din articol pentru acea adâncime ( și o dimensiune maximă a legăturii de 8) și determină de câte setări de măsurare are nevoie învățătorul.
-
Învață cu actualizarea pe două situri (
update=:two_siteîntraining_marginalsșilearn_mpo), care trunchiază dimensiunea legăturii după fiecare pas, și vezi cum se comportă cu mai puține setări de antrenare. -
Învață fără prior-ul CRM (
prior=nothing) și compară fidelitatea de testare. -
Aplică aceeași analiză măsurătorilor
ibm_brisbanepublicate de autori. -
Citește suplimentul articolului pentru derivarea actualizării și a estimatorilor AFC.
-
Explorează alte protocoale de măsurare aleatoare în exemplele
RandomMeas.jl.
Referințe
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174