Reîmprospătează proprietățile backend-ului cu benchmarking în timp real
Estimare de utilizare: 3 minute pe ibm_kingston (NOTĂ: Aceasta este doar o estimare. Timpul tău de execuție poate varia.)
Rezultate ale învățării
-
De ce proprietățile raportate de un QPU pot rămâne în urma comportamentului actual al dispozitivului și când merită să le remăsori tu însuți
-
Ce măsoară fiecare dintre cele cinci experimente standard de caracterizare (citire, benchmarking randomizat pe un singur qubit, benchmarking randomizat stratificat pe doi qubiți, și )
-
Cum să rulezi suita completă de caracterizare într-un singur apel sau pas cu pas, și să obții înapoi un obiect backend cu proprietăți reîmprospătate
-
Cum să compari proprietățile măsurate cu cele raportate și de ce unele diferențe reflectă metodologia de măsurare, nu deriva dispozitivului
Cerințe preliminare
-
Fluxul de lucru Qiskit patterns
-
Moduri de execuție Qiskit Runtime, în special batch mode
-
Cum să explorezi informațiile despre QPU, cum ar fi proprietățile backend-ului și datele de calibrare
Context
Fiecare QPU IBM Quantum® raportează un set de proprietăți care descriu cât de bine funcționează în prezent fiecare dintre qubiții săi: timpi de relaxare (), timpi de coerență (), erori de citire și erori ale porților cu unul și doi qubiți. Aceste numere contează în practică. Transpiler-ul le folosește pentru a decide pe ce qubiți fizici ar trebui să ruleze circuitul tău, tehnicile de atenuare a erorilor se bazează pe ele, iar tu le-ai putea folosi pentru a evalua dacă un dispozitiv funcționează suficient de bine pentru un experiment.
Proprietățile raportate provin din proceduri de calibrare care rulează de obicei aproximativ o dată pe zi. Qubiții supraconductori, totuși, pot deriva pe scale de timp mai scurte, iar defectele tranzitorii (așa-numitele sisteme cu două niveluri) pot degrada temporar un qubit care părea excelent la momentul calibrării. În plus, un job este adesea transpilat cu mult înainte de a se executa efectiv, astfel încât deciziile bazate pe proprietățile raportate se pot baza pe informații învechite. Tutorialul Benchmarking în timp real pentru selecția qubiților arată cât de mult pot fluctua aceste proprietăți de la o zi la alta și construiește manual un flux de lucru complet de caracterizare din Qiskit Experiments individuale.
Acest tutorial arată versiunea simplificată a acelui flux de lucru, folosind utilitarul BackendCharacterization din Qiskit Device Benchmarking, care combină construcția experimentelor, trimiterea joburilor și ajustarea curbelor în câteva apeluri. Cheltuiești aproximativ 70 de secunde de timp QPU și primești înapoi un obiect backend ale cărui proprietăți reflectă dispozitivul chiar acum, gata să fie comparat cu valorile raportate sau transmis instrumentelor din aval.
Experimentele de caracterizare
Suita măsoară cinci proprietăți, fiecare cu un experiment standard:
-
Eroare de citire (
readout): Fiecare qubit este pregătit în sau și măsurat imediat. Probabilitatea de a citi starea greșită dă eroarea de pregătire și măsurare a stării (SPAM). -
Eroarea porții pe un singur qubit (
rb_1q): Benchmarking-ul randomizat (RB) rulează secvențe de porți Clifford aleatorii pe un singur qubit care, în mod ideal, se compun la identitate. Modul în care probabilitatea de supraviețuire scade odată cu lungimea secvenței dă eroarea medie per poartă, independent de erorile SPAM. -
Eroarea porții pe doi qubiți (
rb_2q): Aceeași idee RB aplicată unor straturi complete de porți cu doi qubiți care nu se suprapun, executate simultan, ca într-un experiment de fidelitate a stratului. Deoarece multe porți rulează simultan, ratele de eroare rezultate includ efecte de crosstalk și sunt mai apropiate de ceea ce experimentează efectiv un circuit adânc. -
(
t1): Fiecare qubit este excitat și măsurat după întârzieri crescânde. Declinul populației stării excitate dă timpul de relaxare. -
(
t2): Un experiment de ecou Hahn pune fiecare qubit într-o suprapunere, aplică un impuls de ecou la jumătatea unei întârzieri și măsoară cât de repede se pierde coerența de fază. În mod implicit se folosește un singur ecou; o variantă cu multiple ecouri (de tip CPMG) este demonstrată la sfârșitul acestui tutorial.
Ce face și ce nu face reîmprospătarea
Ține cont de trei aspecte atunci când folosești acest flux de lucru:
-
Proprietățile reîmprospătate există doar în obiectul backend returnat ție. Nimic nu se schimbă pe dispozitivul în sine sau în datele de calibrare pe care IBM Quantum le raportează altor utilizatori.
-
Valorile măsurate sunt un instantaneu obținut cu o metodologie specifică. Unele dintre ele, în special erorile stratificate cu doi qubiți și valorile paralele cu un singur ecou, sunt măsurate diferit față de datele de calibrare raportate, astfel încât o parte din orice diferență observată este metodologică, nu derivă. Acest tutorial subliniază unde se întâmplă acest lucru.
-
Caracterizarea în sine costă timp de QPU (aproximativ 70 de secunde pentru suita completă pe un procesor Heron r2), care este prețul informațiilor actualizate.
Fluxul de lucru urmează cei patru pași ai unui pattern Qiskit:
-
Pasul 1: Mapează intrările clasice la o problemă cuantică. Alege dispozitivul și setul de proprietăți de măsurat.
-
Pasul 2: Optimizează problema pentru execuția pe hardware cuantic. Utilitarul construiește circuitele experimentale direct în porțile native ale dispozitivului și le paralelizează pe cip.
-
Pasul 3: Execută folosind primitivele Qiskit. Experimentele rulează ca joburi Sampler într-un batch.
-
Pasul 4: Post-procesează și returnează rezultatul în formatul clasic dorit. Ajustează datele de măsurare în hărți de erori per qubit, reîmprospătează backend-ul și compară proprietățile măsurate cu cele raportate.
Cerințe
Înainte de a începe acest tutorial, asigură-te că ai instalate următoarele:
-
Qiskit SDK v2.0 sau o versiune ulterioară, cu suport pentru vizualizare
-
Qiskit Runtime v0.40 sau o versiune ulterioară (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, care instalează și Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Configurare
Importă bibliotecile necesare.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Suita de caracterizare construiește mai multe experimente, trimite mai multe joburi și ajustează rezultatele, ceea ce poate dura câteva minute în total. Activează logarea la nivel INFO astfel încât fiecare etapă să își afișeze progresul pe măsură ce se produce.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Exemplu de simulator la scară mică
Acest tutorial nu include un exemplu de simulator. Fluxul de lucru măsoară imperfecțiunile fizice ale unui dispozitiv specific: cât de repede se relaxează și se defazează qubiții săi și cât de des eșuează porțile și citirea sa. Un simulator ideal nu are niciuna dintre aceste imperfecțiuni, deci nu este nimic de caracterizat. Ai putea atașa un model sintetic de zgomot unui backend fals, dar experimentele ar recupera atunci doar numerele pe care tu însuți le-ai introdus. Din acest motiv, trecem direct la hardware, împărțit în cei patru pași ai unui pattern Qiskit.
Exemplu de hardware la scară mare
Pasul 1: Mapează intrările clasice la o problemă cuantică
În acest flux de lucru, „problema” este chiar dispozitivul: intrările clasice sunt QPU-ul pe care vrei să îl caracterizezi și lista de proprietăți de măsurat, iar experimentele cuantice sunt circuitele de caracterizare generate din acestea.
Mai întâi, selectează un backend. Acest tutorial folosește ibm_kingston, un procesor Heron r2 cu 156 de qubiți; poți substitui orice dispozitiv IBM Quantum la care ai acces (sau poți alege unul cu service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Apoi, alege ce proprietăți să măsori. Poți transmite orice subset din următoarele experimente:
-
readout: experiment SPAM (pregătirea și măsurarea stării) -
rb_1q: benchmarking randomizat izolat pe un singur qubit -
rb_2q: benchmarking randomizat simultan pe doi qubiți dintr-un experiment de fidelitate a straturilor -
t2: experiment ecou Hahn (un singur ecou implicit) -
t1: experiment de relaxare
Rulează suita completă pentru a obține o imagine completă a dispozitivului; elimină intrări din listă dacă îți pasă doar de anumite proprietăți și vrei să economisești timp de QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Pasul 2: Optimizează problema pentru execuția pe hardware cuantic
În majoritatea tutorialelor, acesta este pasul în care ai transpila circuitele. Aici, BackendCharacterization se ocupă de asta intern. Construiește circuitele experimentului direct în porțile native ale dispozitivului, rulează experimentele pe un singur qubit pe toți qubiții în paralel și programează benchmarking-ul pe doi qubiți pe straturi disjuncte ale hărții de cuplare, astfel încât întregul dispozitiv este acoperit cu doar câteva joburi. Datorită acestei paralelizări, întreaga suită consumă doar aproximativ 70 de secunde de timp QPU.
Inițializează clasa care gestionează fluxul de lucru:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Pasul 3: Execută folosind primitivele Qiskit
Metoda run_experiments construiește circuitele și le trimite ca joburi Sampler. Rulează-o într-un context Batch astfel încât joburile să fie programate împreună pe QPU, iar metoda revine odată ce toate joburile au fost trimise. (Poți de asemenea să o rulezi în afara unui batch, sau într-o Session.)
Este posibil să vezi un avertisment despre transmiterea unui backend în timp ce un context manager de sesiune este deschis. Acest lucru este așteptat și poate fi ignorat în siguranță.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Metoda returnează joburile trimise ca un dicționar indexat după experiment, ceea ce este util pentru a le urmări în tabloul de bord IBM Quantum Platform sau pentru depanare.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Pasul 4: Post-procesează și returnează rezultatul în formatul clasic dorit
Analizează rezultatele
Metoda analyze_results așteaptă finalizarea joburilor și potrivește datele de măsurare: declinuri exponențiale pentru și , declinuri ale probabilității de supraviețuire pentru experimentele RB și matrici de atribuire pentru citire. Returnează un dicționar de hărți de eroare, câte o intrare pentru fiecare proprietate măsurată, fiecare mapând un qubit (sau o pereche de qubiți) la valoarea sa măsurată.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Hărțile acoperă eroarea de citire, erorile porților x și sx pe un singur qubit, erorile stratificate pe doi qubiți (lf_error_map, din experimentul de fidelitate a straturilor) și timpii și în secunde.
Actualizează proprietățile backend-ului
Metoda update_backend scrie valorile măsurate în proprietățile unei copii a backend-ului și o returnează. Obiectul original backend păstrează datele de calibrare raportate, astfel încât să putem compara cele două, așa cum este arătat mai jos. Reține că această actualizare este pur locală sesiunii tale Python; nu schimbă nimic pe dispozitiv sau pentru alți utilizatori.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Compară proprietățile măsurate cu cele raportate
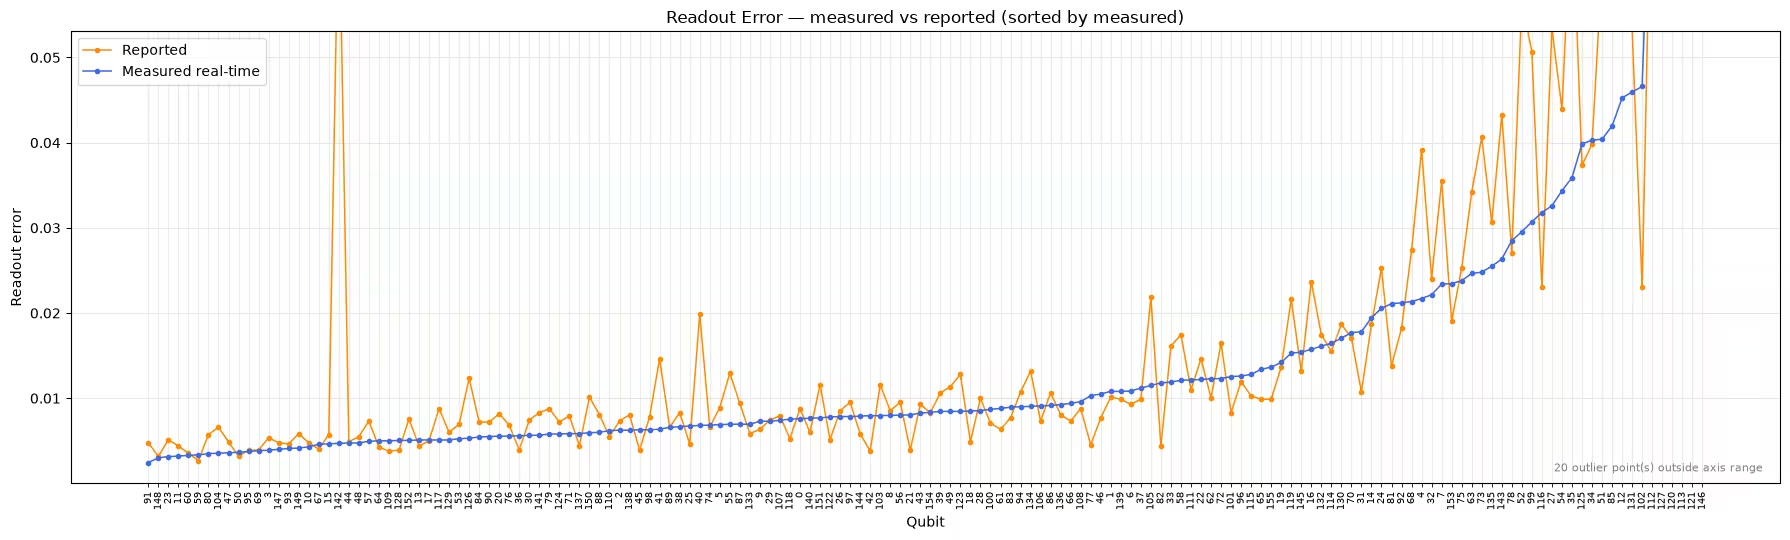
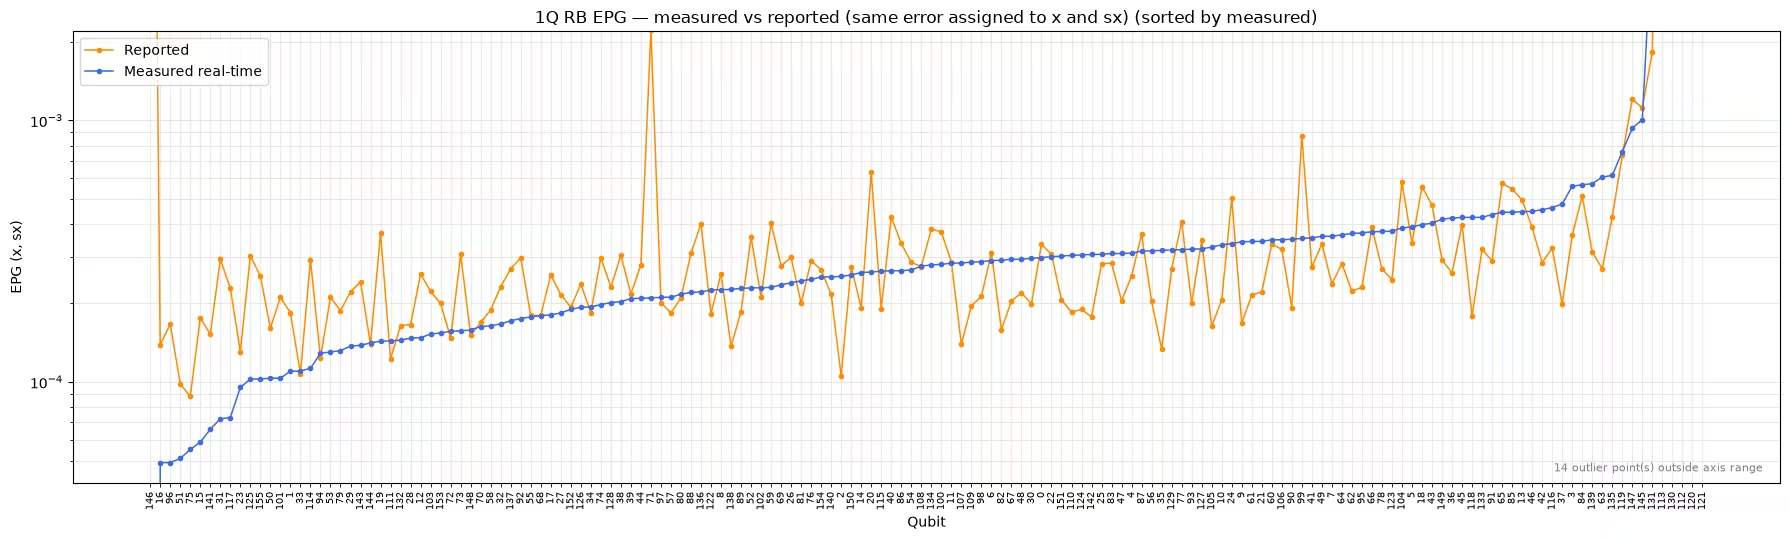
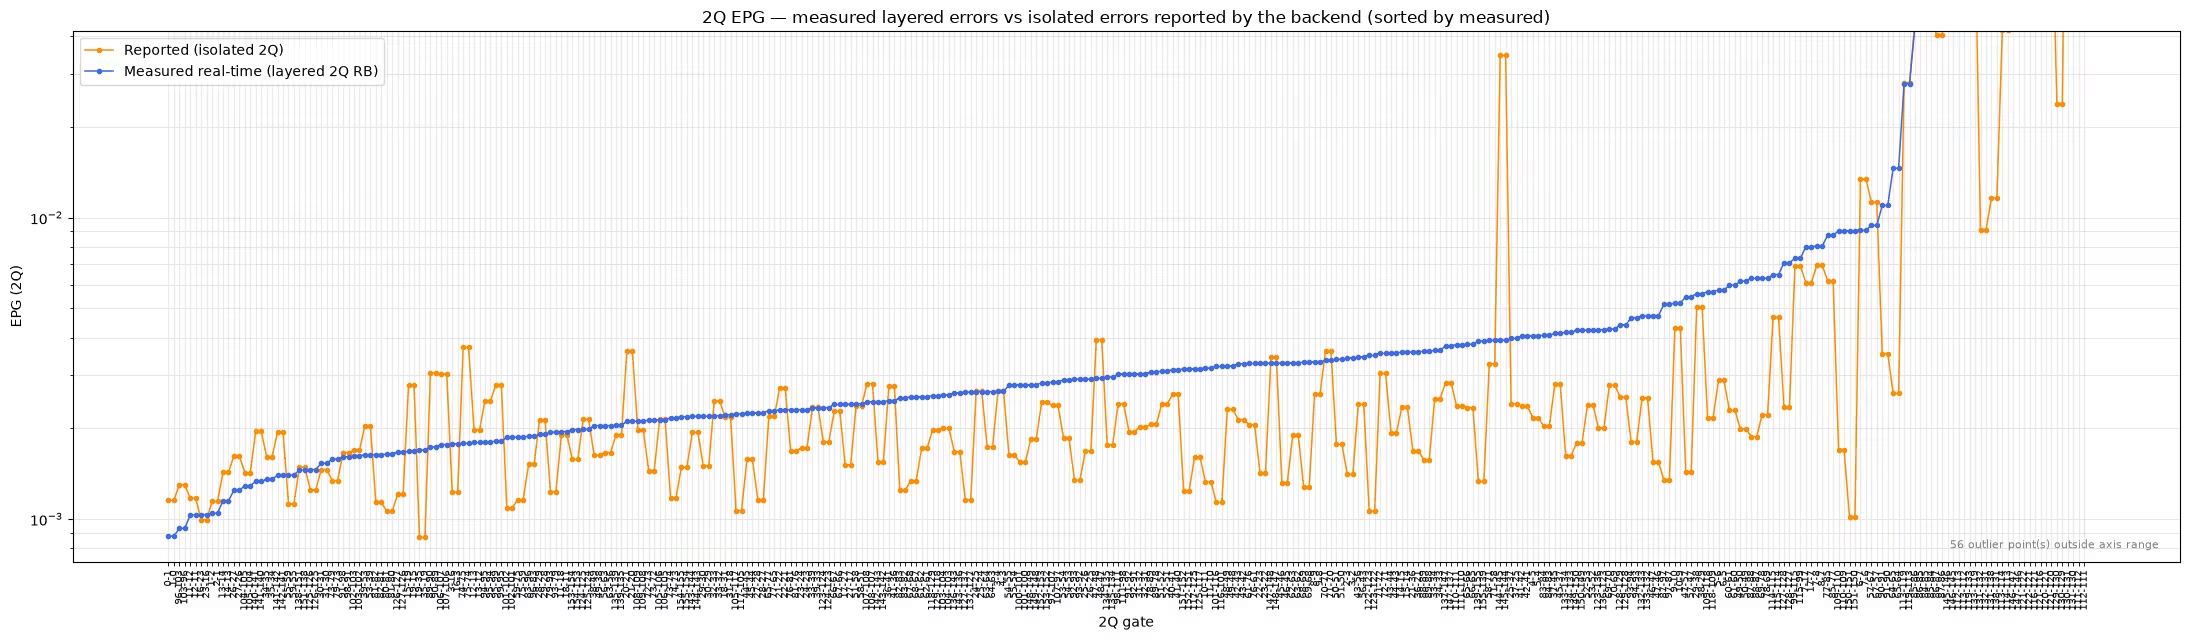
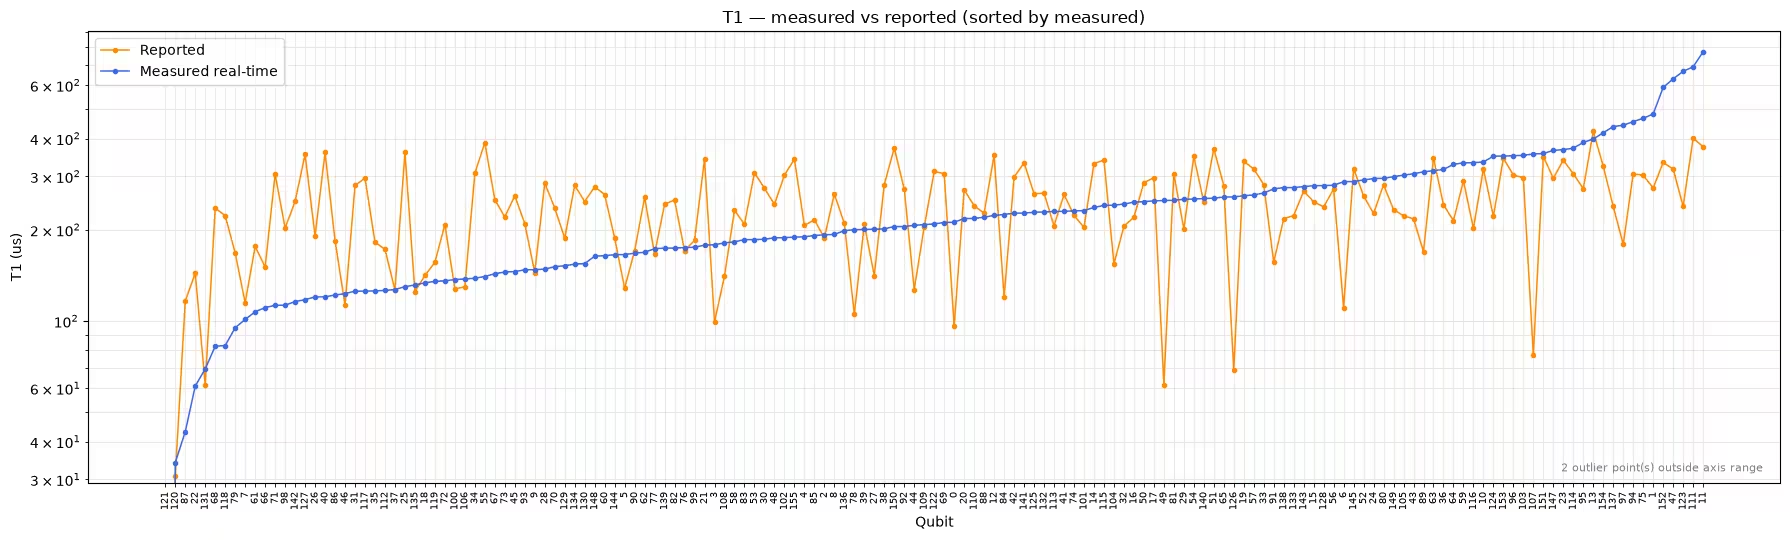
În final, reprezintă grafic proprietățile măsurate în timp real față de valorile raportate de backend. În fiecare panou, qubiții (sau perechile de qubiți) sunt sortați după valoarea măsurată, astfel încât curba măsurată este netedă prin construcție, iar dispersia valorilor raportate în jurul ei arată unde cele două diferă. Este afișat un singur grafic pentru RB pe un singur qubit deoarece aceeași eroare măsurată per poartă este atribuită atât porții x, cât și porții sx. Limitele axelor sunt alese din grosul datelor astfel încât câteva valori extreme aberante să nu comprime graficele; orice puncte în afara intervalului sunt numărate într-o adnotare pe grafic (sau treci ylim pentru a suprascrie limitele).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
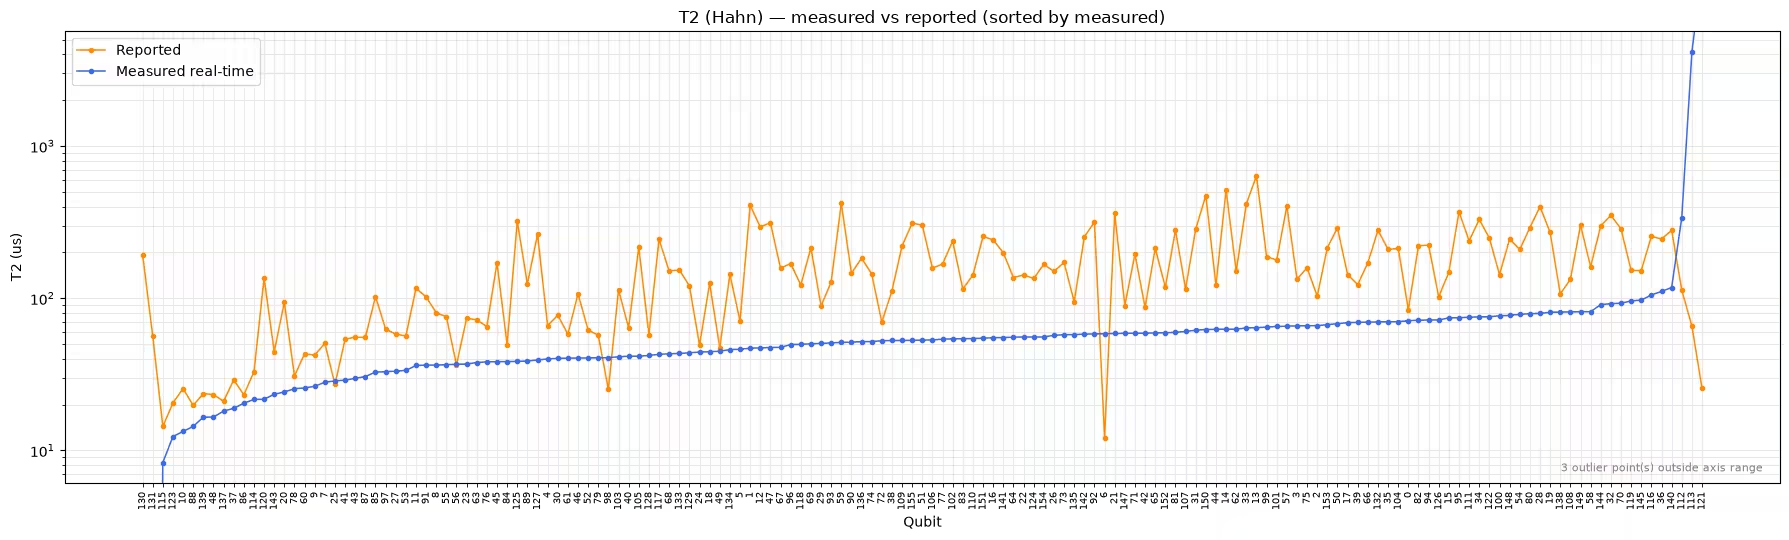
Aceste grafice necesită o citire atentă, deoarece nu orice decalaj între cele două curbe înseamnă că parametrii dispozitivului au suferit o derivă:
-
Erori de citire și pe un singur qubit: Valorile măsurate urmăresc pe cele raportate pentru majoritatea qubiților, în timp ce valoarea raportată pentru câțiva qubiți este mult depărtată de curba măsurată. Acele diferențe localizate reprezintă deriva pe care acest flux de lucru este conceput să o detecteze.
-
: Cele două seturi de date se dispersează unul în jurul celuilalt fără o abatere sistematică, ceea ce este în concordanță cu fluctuația naturală a în timp.
-
Erori pe doi qubiți: Valorile măsurate se situează sistematic peste cele raportate. Acest lucru este de așteptat deoarece valorile raportate sunt măsurate pe porți izolate, în timp ce experimentul de fidelitate a straturilor rulează multe porți simultan și, prin urmare, include crosstalk. Numerele stratificate sunt mai relevante pentru circuite adânci, dar nu sunt direct comparabile cu datele de calibrare raportate.
-
: Valorile măsurate se situează cu mult sub cele raportate pentru majoritatea qubiților. Din nou, metodologia joacă un rol important, așa cum este examinat în secțiunea următoare.
Inspectează rezultatele experimentelor individuale
Poți de asemenea să inspectezi rezultatele brute ale experimentelor individuale de caracterizare prin proprietatea experiment_data, care returnează obiectele ExperimentData subiacente din Qiskit Experiments. De exemplu, următoarea afișează curba de declin măsurată a unui singur qubit, ceea ce este util pentru verificarea calității unei potriviri înainte de a avea încredere în numărul pe care l-a produs.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Măsoară T2 cu un tren de decuplare dinamică
Implicit, experimentul aplică un singur ecou Hahn și măsoară toți qubiții în paralel, ceea ce, așa cum a arătat graficul de comparație de mai sus, poate produce valori vizibil mai mici decât cele raportate de backend. O ipoteză este numărul de ecouri: valorile raportate pot fi calibrate cu decuplare dinamică, care suprimă zgomotul de frecvență joasă. Pentru a testa asta, rulează o caracterizare doar- cu t2_num_echoes setat la o valoare mai mare, ceea ce aplică un tren de impulsuri ecou de stil CPMG. Întârzierile reprezintă timpul total de evoluție liberă în ambele cazuri, astfel încât valorile obținute prin ajustare (fit) sunt direct comparabile cu rezultatele cu un singur ecou.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
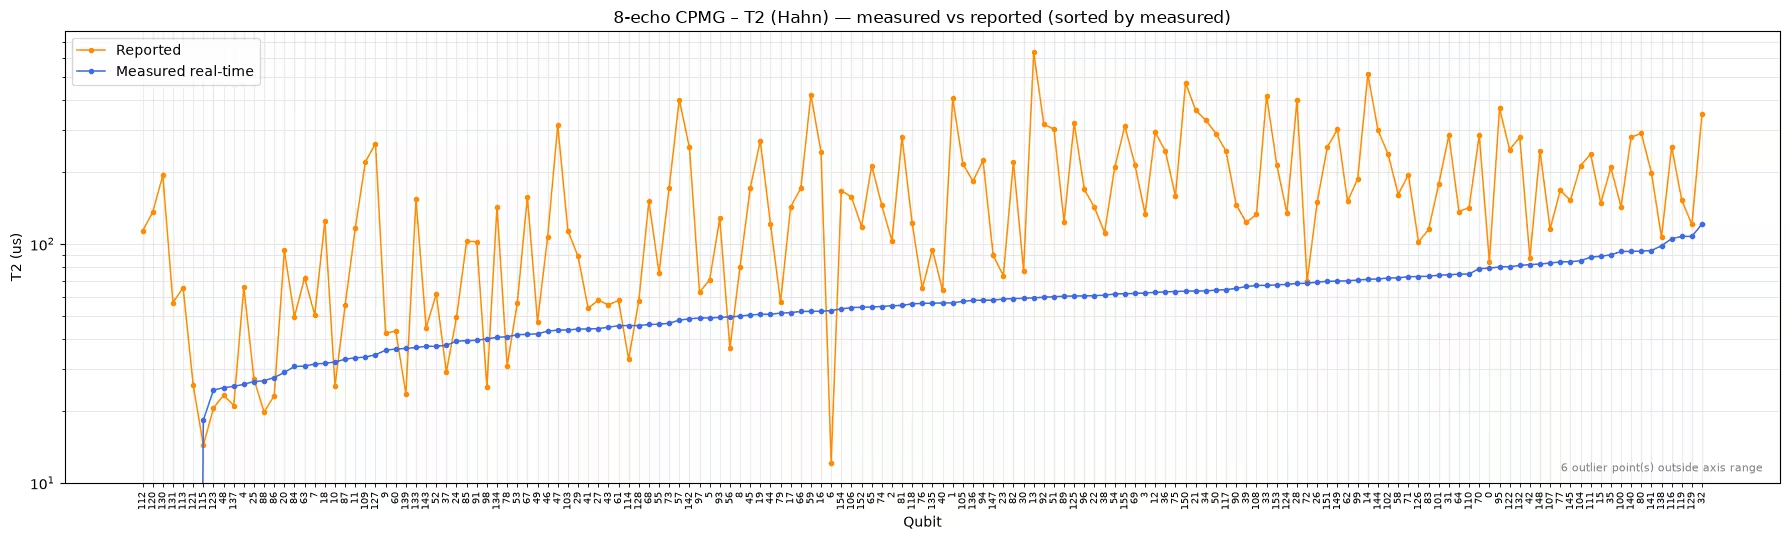
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
În această rulare, ecourile suplimentare au schimbat rezultatul foarte puțin: mediana cu 8 ecouri (56 µs) este aproape de cea cu un singur ecou (53 µs), și ambele rămân mult sub mediana raportată (142 µs). Numărul de ecouri singur nu explică acest decalaj; sunt implicate alte diferențe metodologice, precum detalii ale procedurii de calibrare, măsurarea tuturor qubiților în paralel în loc de izolat și așa mai departe.
Lecția practică este să tratezi comparațiile (și eroarea stratificată pe doi qubiți) între metodologii cu grijă. Valorile reîmprospătate sunt un instantaneu auto-consistent luat în condiții apropiate de o sarcină de lucru reală, ceea ce le face potrivite pentru compararea qubiților unul cu altul sau urmărirea unui dispozitiv în timp. Un decalaj față de datele de calibrare raportate, totuși, nu este automat dovadă de derivă.
Pașii 1–4 comprimați într-un singur apel
Pentru uzul zilnic, rareori ai nevoie de rezultatele intermediare. Metoda run_and_update înlănțuie tot ce ai făcut mai sus (construire, trimitere, potrivire și actualizare) într-un singur apel care returnează backend-ul reîmprospătat. Acceptă aceeași listă experiments (și transmite opțiuni precum t2_num_echoes) și poate fi de asemenea încadrată într-un context Batch sau Session.
Următoarea celulă nu se finalizează până când toate job-urile și post-procesarea nu sunt terminate.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Obiectul reîmprospătat backend_updated este acum gata de utilizat oriunde proprietățile backend-ului alimentează fluxul tău de lucru. Încearcă acest proces împreună cu tutorialul Benchmarking în timp real pentru selecția qubiților pentru a alege qubiții cu cea mai bună performanță atunci când transpilezi un circuit. Deoarece dispozitivul continuă să derive, reîmprospătează proprietățile aproape de momentul în care chiar execuți sarcina ta de lucru.
Pași următori
Dacă ai găsit această lucrare interesantă, ar putea să te intereseze următoarele materiale:
- Folosește proprietățile reîmprospătate pentru a alege qubiți mai buni în tutorialul Benchmarking în timp real pentru selecția qubiților
- Află cum sunt expuse datele de calibrare raportate în ghidul Informații despre QPU
- Explorează experimentele individuale de caracterizare în documentația Qiskit Experiments
- Răsfoiește alte benchmark-uri la nivel de dispozitiv în repository-ul Qiskit Device Benchmarking