Limitarea dimensiunii subspațiului
În acest ghid practic, vom arăta efectul dimensiunii subspațiului în tehnica de recuperare auto-consistentă a configurațiilor.
A priori, nu știm care este dimensiunea corectă a subspațiului pentru a obține un anumit nivel de acuratețe. Totuși, știm că mărirea dimensiunii subspațiului crește acuratețea metodei. Prin urmare, putem studia acuratețea predicțiilor în funcție de dimensiunea subspațiului. Specifică molecula și proprietățile ei.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Generează câteva șiruri de biți aleatorii care să înlocuiască eșantioanele QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Apelează SQD cu dimensiuni de lot crescătoare.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
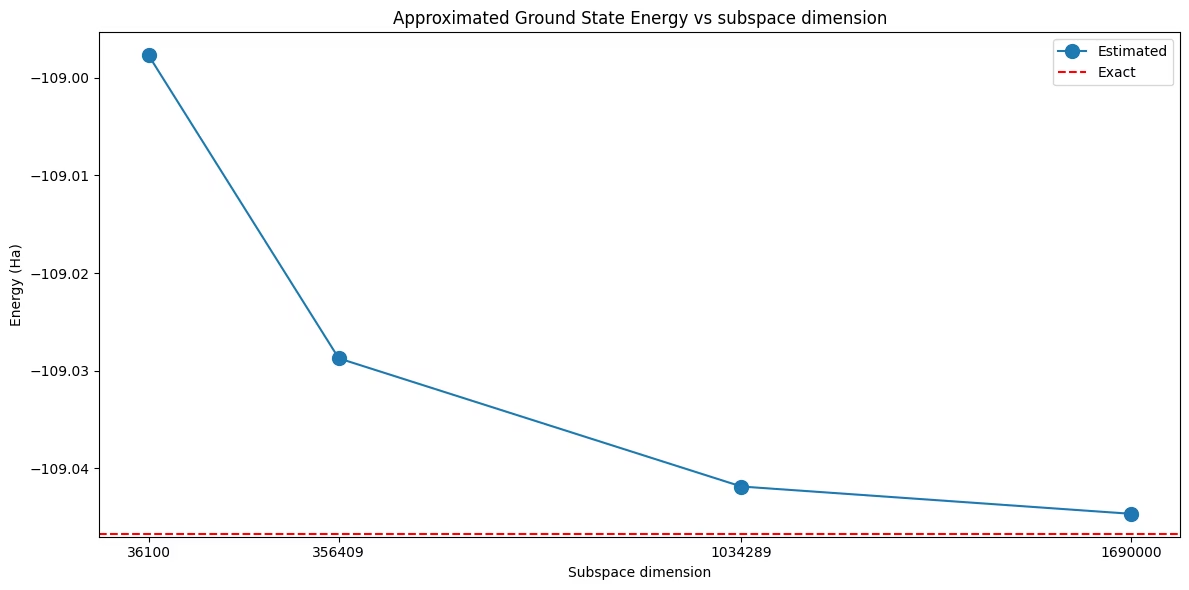
Acest grafic arată că mărirea dimensiunii subspațiului duce la rezultate mai precise.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Stabilirea unei limite explicite cu max_dim
În parcurgerea de mai sus, dimensiunea subspațiului a fost controlată doar indirect. samples_per_batch stabilește câte șiruri de biți sunt extrase în fiecare lot, dar dimensiunea subspațiului rezultat este determinată de câte șiruri de spin-alfa și spin-beta distincte conțin acele șiruri de biți, iar setul de configurații disponibile pentru subeșantionare crește de la o iterație de recuperare a configurațiilor la următoarea. De aceea dimensiunile subspațiului de pe axa orizontală de mai sus sunt numere neregulate pe care nu le-am ales noi.
Argumentul max_dim al funcției diagonalize_fermionic_hamiltonian limitează direct dimensiunea. El limitează numărul de șiruri CI păstrate în fiecare sector de spin, iar deoarece subspațiul este generat de produsul cartezian al celor două sectoare, dimensiunea lui este produsul dimensiunilor celor două sectoare:
-
max_dim=dlimitează ambele sectoare ladșiruri, deci dimensiunea subspațiului este cel multd ** 2. -
max_dim=(d_a, d_b)limitează separat sectoarele spin-alfa și spin-beta, deci dimensiunea subspațiului este cel multd_a * d_b. Cândsymmetrize_spin=True, cele două limite trebuie să fie egale. -
max_dim=None, valoarea implicită, nu impune nicio limită.
Când un lot conține mai multe șiruri decât permite limita, cele mai puțin importante sunt eliminate: șirurile transmise prin include_configurations sunt păstrate primele, urmate de șirurile preluate din iterația anterioară (vezi carryover_threshold), iar locurile rămase sunt completate cu șirurile eșantionate, în ordine descrescătoare a frecvenței cu care au fost eșantionate.
Deoarece max_dim plafonează dimensiunea celei mai mari diagonalizări pe care i se va cere solverului de stări proprii să o efectueze, este o modalitate convenabilă de a menține solverul într-un buget de timp de execuție și de memorie: alege samples_per_batch generos și lasă max_dim să decidă cât de mult are voie să crească subspațiul.
Mai jos repetăm studiul, de data aceasta menținând samples_per_batch fix și crescând max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
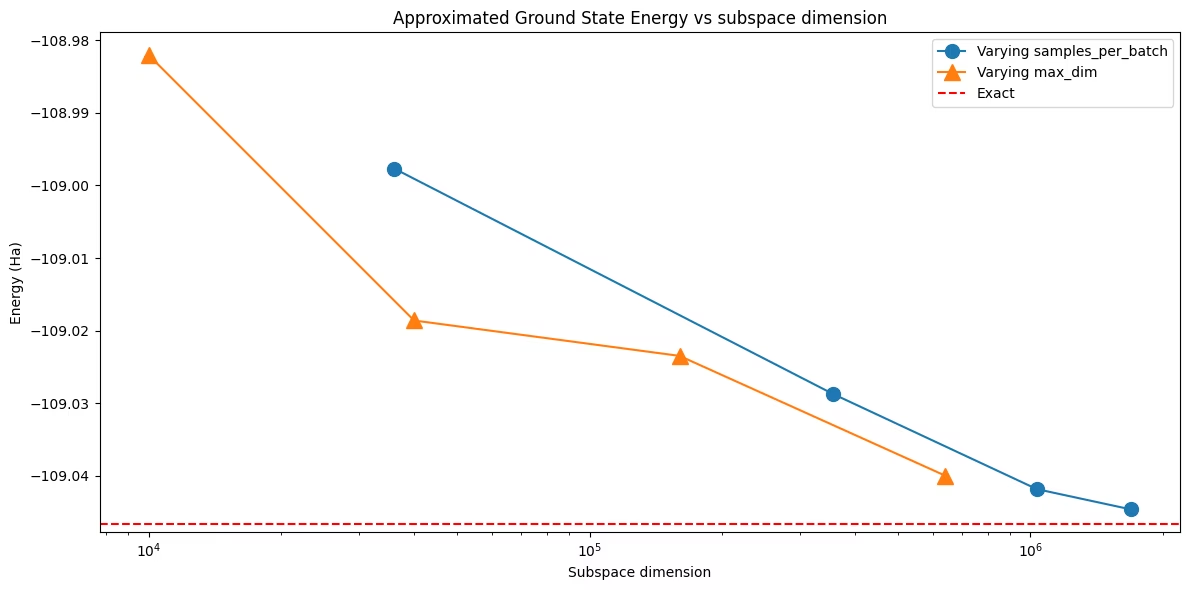
Dimensiunea subspațiului este acum exact max_dim ** 2 în fiecare rulare: a fost aleasă, nu descoperită. Reprezentarea împreună a ambelor parcurgeri arată că acuratețea este determinată de dimensiunea subspațiului în sine, indiferent de argumentul folosit pentru a ajunge la ea. Cele două curbe nu trebuie totuși să coincidă exact. Rulările cu max_dim extrag 600 de șiruri de biți pe lot și apoi păstrează șirurile eșantionate cel mai frecvent, astfel că, la o anumită dimensiune, pot păstra un set de configurații mai bun decât o rulare care a ajuns la acea dimensiune eșantionând de la început mai puține șiruri de biți.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()