Atenuarea erorilor
Această lecție oferă informații de fond despre diverse tehnici de atenuare a erorilor, pentru a ajuta utilizatorii să-și formeze intuiția despre cum și când se folosesc cel mai bine. Important este că aplicațiile moderne ale acestor tehnici vor folosi instrumente mai sofisticate, precum Samplomatic, Shaded Lightcones și Executor. Aceste fluxuri de lucru vor fi tratate în lecțiile următoare.
Acest videoclip oferă o privire de ansamblu asupra tehnicilor de atenuare a erorilor. Textul de mai jos adaugă mai multe detalii și explorează aceste metode folosind Qiskit.
Privire de ansamblu asupra tehnicilor de atenuare a erorilor
Atenuarea erorilor se referă la orice proces care încearcă să reducă efectele erorilor din calculele cuantice după ce acestea au apărut. Este diferită de suprimare, care încearcă să prevină erorile, și de corecția erorilor, care codifică informația pe mulți qubiți fizici și verifică consistența acelei informații pentru a păstra informația într-un singur qubit logic. Pe parcursul acestei lecții, tehnicile de atenuare a erorilor pot fi înțelese cel mai bine ca metode de construire a unor estimatori mai buni ai valorilor de așteptare ideale sau a unor eșantionatori mai buni ai distribuțiilor de probabilitate, nu ca metode de corectare a stărilor cuantice în timpul execuției. Vom examina mai jos metodele de atenuare a erorilor, toate disponibile în Qiskit și în addonurile sale, și care sunt instrumente promițătoare în căutarea avantajului cuantic.
Twirled readout error extinction (TREX) randomizează procesul de măsurare aplicând operații Pauli alese aleatoriu înainte de măsurare și apoi anulând clasic efectele lor cunoscute asupra șirurilor de biți observate. Sub ipoteze adecvate despre zgomotul de măsurare, acest lucru transformă canalul erorii de citire într-o formă mai simplă și mai simetrică, mai ușor de calibrat și de atenuat.
Matrix-free measurement mitigation (M3) este o tehnică scalabilă de atenuare a erorilor de măsurare, care evită construirea explicită a matricei de atribuire sau a inversei sale.
Zero noise extrapolation (ZNE) aproximează valoarea pe care ar avea-o o observabilă în absența zgomotului, scalând artificial zgomotul cu un factor cunoscut și extrapolând înapoi la cazul fără zgomot. Aceasta necesită ca zgomotul să scaleze într-un mod previzibil. Această previzibilitate ar putea necesita alte metode discutate în această lecție (întinderea pulsurilor, pliarea porților și amplificarea probabilistică a erorilor (PEA)).
Probabilistic error cancellation (PEC) este printre cele mai puternice, dar și cele mai costisitoare computațional, tehnici de atenuare a erorilor. Funcționează învățând comportamentul zgomotului sistemului și încercând să anuleze zgomotul prin construirea statistică a unei estimări nedeplasate a calculului ideal. PEC produce observabile corectate statistic, nu rezultate corectate prin corecția erorilor.
Acum vom aprofunda fiecare dintre aceste metode.
M3
Erorile de măsurare sunt una dintre cele mai persistente și specifice hardware-ului surse de zgomot în dispozitivele cuantice pe termen apropiat. Chiar și atunci când o stare cuantică este pregătită și evoluează corect, pasul final de citire poate raporta greșit rezultatul real din baza computațională. Aceste erori apar din discriminarea imperfectă între stările fizice corespunzătoare lui și , din relaxarea în timpul măsurării și din imperfecțiunile electronicii de măsurare. Drept urmare, distribuția observată a șirurilor de biți este adesea o versiune distorsionată a distribuției reale (ideale), cu probabilitate realocată incorect între rezultate.
Atenuarea măsurătorilor abordează această problemă modelând explicit modul în care rezultatele măsurătorilor sunt atribuite greșit. În formularea standard, acest comportament este surprins de o matrice de atribuire , ale cărei elemente reprezintă probabilitatea de a înregistra rezultatul când starea reală din bază era . Dacă zgomotul de măsurare este clasic și staționar, vectorul de probabilități observat este legat de distribuția ideală printr-o relație liniară simplă,
Reține că matricea de atribuire este o hartă stocastică clasică, nu un canal cuantic. Ea acționează asupra citirilor clasice, nu asupra stărilor cuantice subiacente care au fost eșantionate pentru a obține citirile.
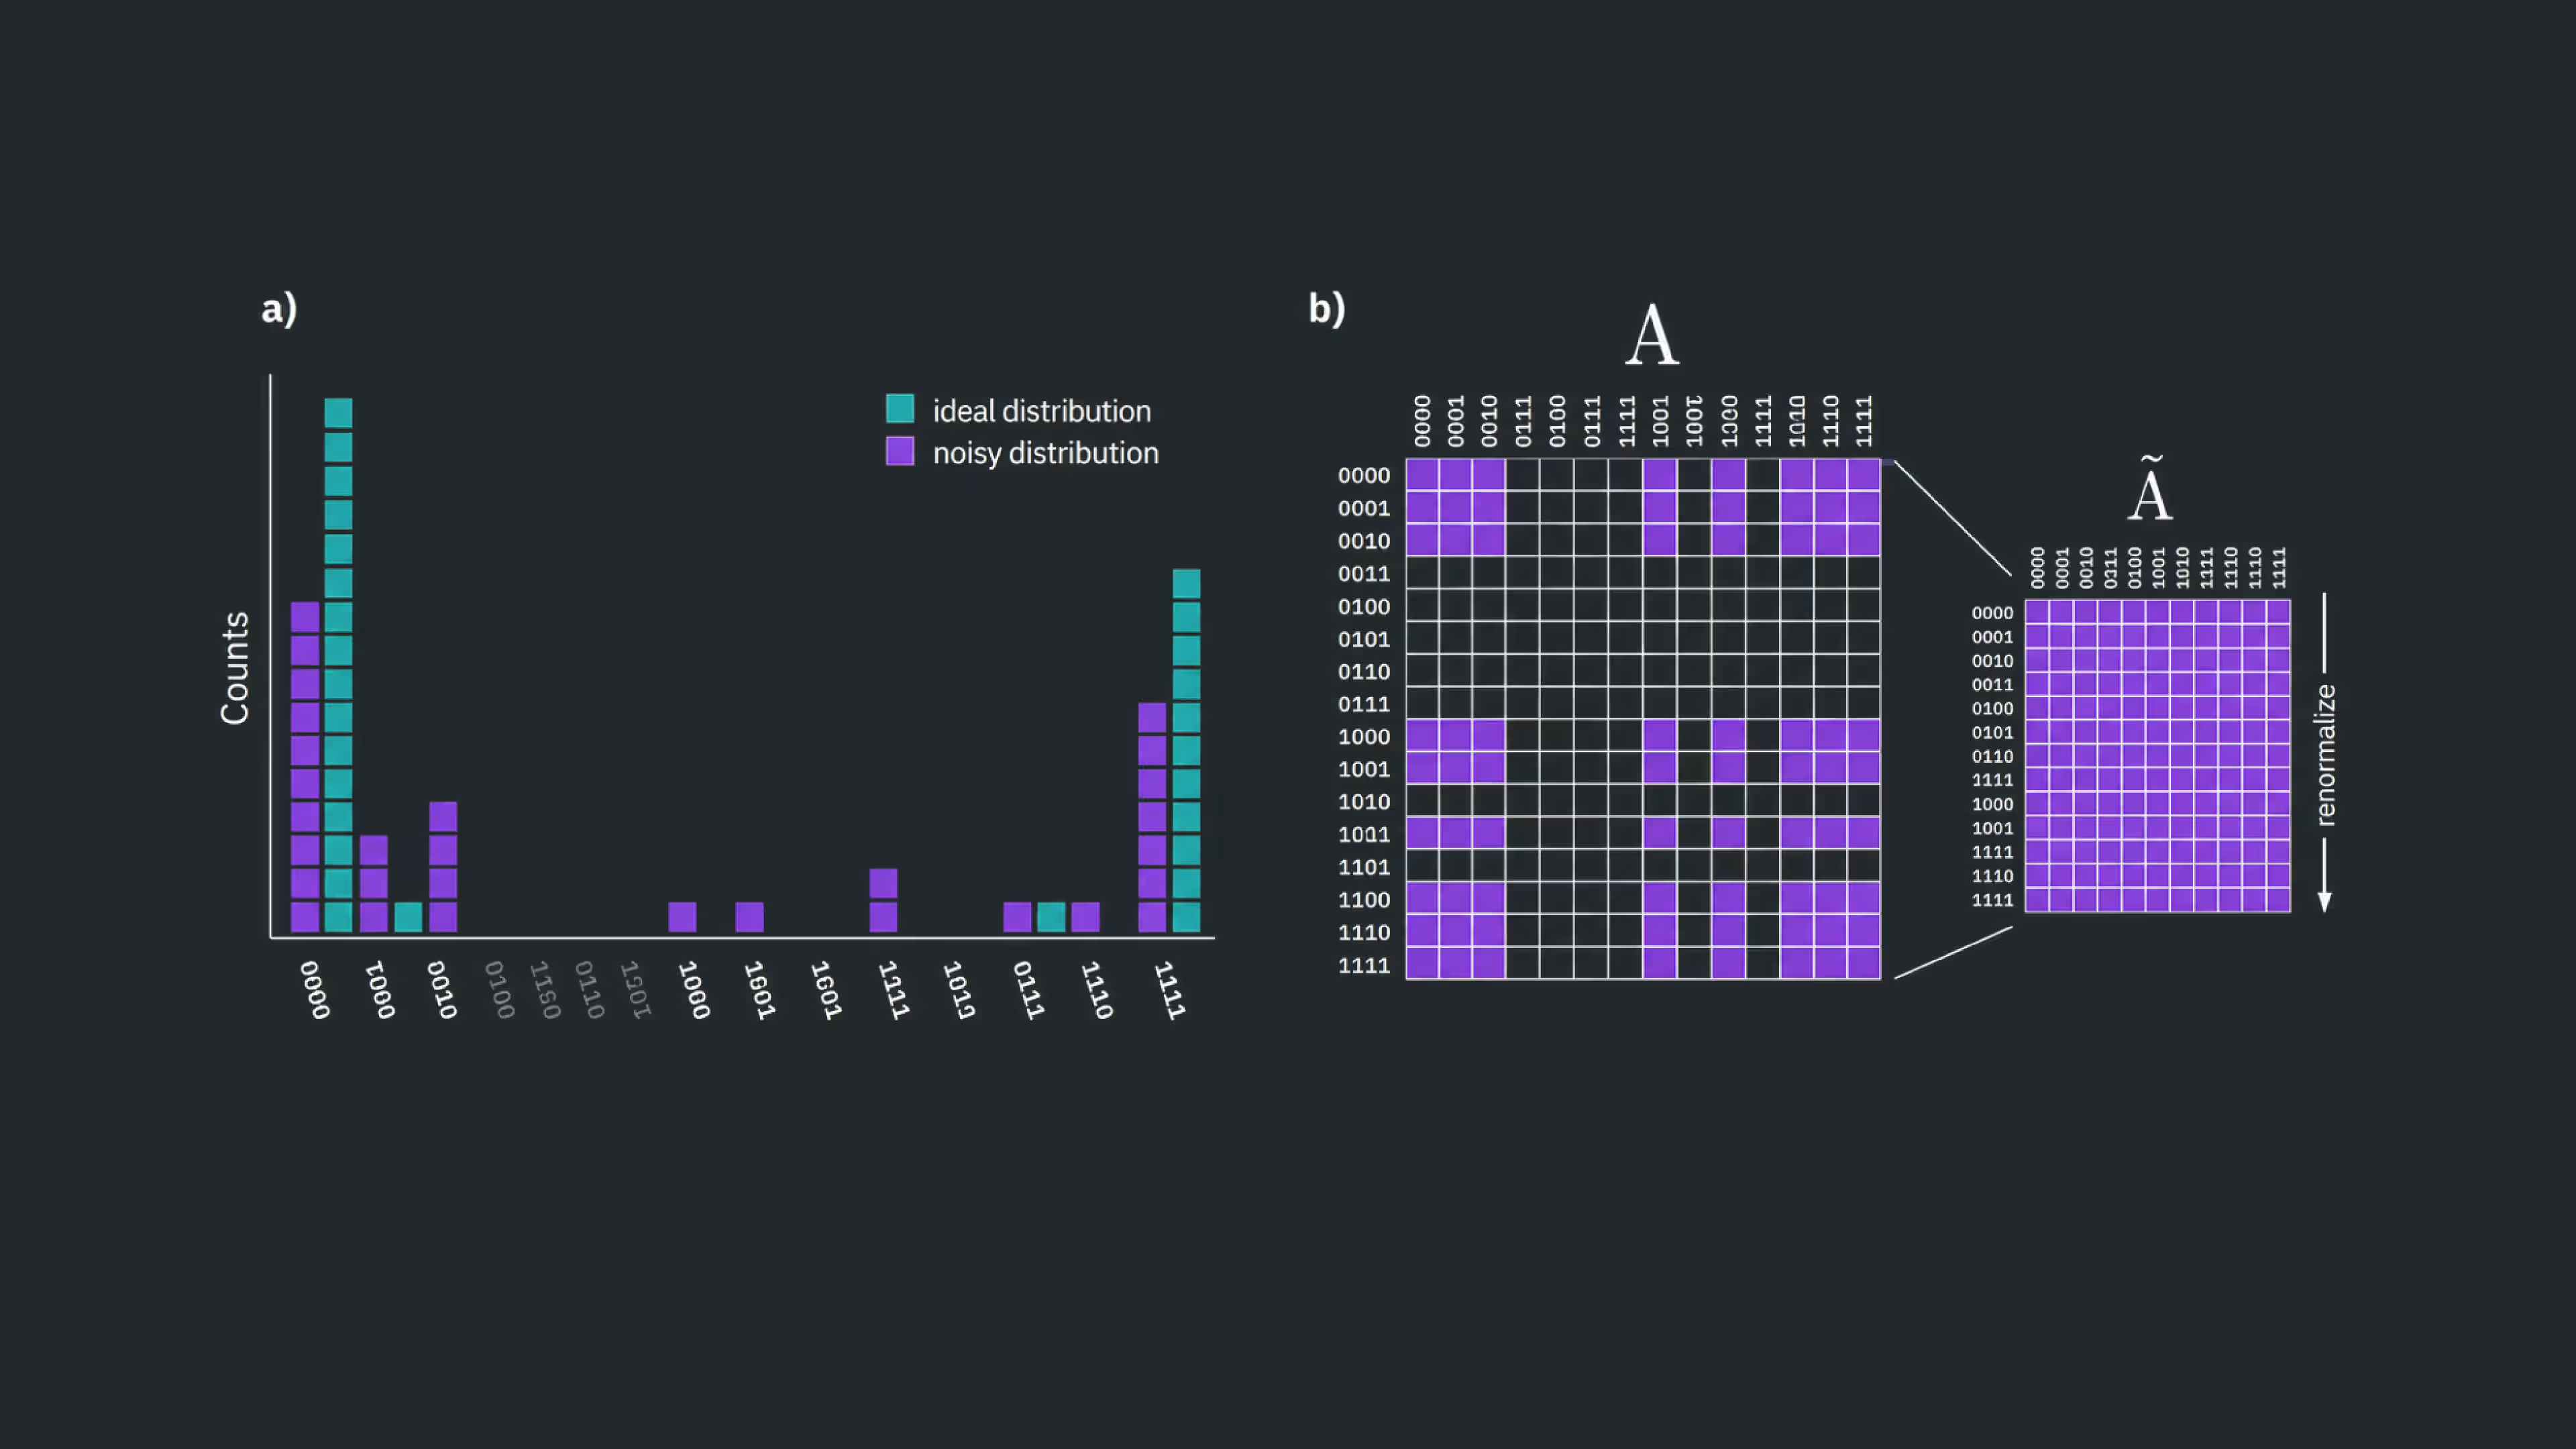
Matrix-free measurement mitigation (M3) folosește această structură pentru a construi o estimare atenuată a lui fără a forma sau inversa vreodată matricea completă , ceea ce ar fi imposibil pentru numere mari de qubiți. În schimb, M3 exploatează faptul că multe sarcini cuantice pe termen apropiat produc distribuții puternic concentrate sau cu entropie scăzută, astfel încât atenuarea se concentrează doar pe submulțimea de rezultate care contribuie semnificativ la distribuția observată.
Pentru a construi modelul de atribuire, trebuie rulate experimente suplimentare de calibrare pe hardware-ul cuantic. Acestea implică de obicei pregătirea unor stări cunoscute din baza computațională și înregistrarea modului în care sunt raportate de sistemul de măsurare. Costul suplimentar al calibrării scalează cu numărul de qubiți măsurați, în timp ce costul computațional al atenuării depinde de structura distribuției observate. Acest cost este mult mai mic decât ar fi necesar pentru a caracteriza explicit întreaga matrice de atribuire . Deși acest cost suplimentar de calibrare este real, el este ușor în comparație cu tehnicile la nivel de circuit precum extrapolarea la zero zgomot sau anularea probabilistică a erorilor, ceea ce face din M3 un instrument practic și larg folosit pentru atenuarea erorilor de citire în experimentele cuantice pe termen apropiat.
Reține că calibrarea este utilă doar în măsura în care procesul de măsurare rămâne suficient de stabil între rulările de calibrare și experimentul țintă.
Vom parcurge mai întâi manual un caz simplu pentru a ilustra cum funcționează, apoi vom folosi instrumentele integrate în Qiskit pentru a arăta utilizarea M3 la o scară mai realistă.
Un exemplu mic cu M3
Începem prin a construi o stare Bell simplă.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Putem folosi un simulator cu un model de zgomot, deoarece limităm acest exemplu la un circuit foarte mic. Configurăm explicit modelul nostru de zgomot să aibă o eroare de citire de forma:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Aceste rate ale erorilor de citire sunt mult mai mari decât cele întâlnite la computerele cuantice IBM® reale. Valorile mari au fost alese din motive pedagogice, pentru a vedea clar efectul M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Putem rula circuitul pe simulatorul cu zgomot pentru a observa efectele erorii de citire.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
În exemplul nostru simplificat, am definit noi eroarea de citire pentru modelul de zgomot. Dar când folosești un computer cuantic real, eroarea de citire nu este cunoscută a priori. În schimb, trebuie estimată experimental. Pentru aceasta, creăm circuite care pregătesc un qubit într-o stare cunoscută din baza computațională sau și îl măsoară. În absența erorii de citire am măsura exact starea pregătită. Colectând statistici din aceste măsurători, putem construi o matrice de atribuire care descrie eroarea de citire. În acest exemplu simplificat, ar trebui să arate similar cu cea pe care am definit-o.
Pentru un sistem mai realist, ar trebui acumulate statistici pentru fiecare qubit fizic. Acest lucru este uneori netrivial, deoarece transpilarea mapează un circuit abstract pe hardware, iar numărul qubitului se schimbă. Vom reveni la asta în exemplul următor. În acest exemplu cu simulator, am atribuit același model de eroare de citire fiecărui qubit, deci o singură caracterizare este suficientă.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Reține că aceasta este foarte apropiată de matricea erorii de citire folosită pentru a construi simulatorul.
Din nou, pe un computer cuantic real am avea statistici ca acestea pentru mai mulți qubiți fizici. Pentru acest simulator, presupunem că cei doi qubiți au erori de citire identice și independente, ceea ce ne permite să construim matricea de atribuire pe doi qubiți A_2q ca produs tensorial al matricelor corespunzătoare pe un qubit. De asemenea, reține că scopul M3 nu este să construiască întreaga matrice de atribuire. În schimb, M3 se concentrează pe submulțimea de rezultate care contribuie semnificativ la distribuția observată. Vom construi întreaga matrice pentru exemplul nostru foarte mic, ca să vedem cum funcționează. Implementarea M3 din qiskit-ibm-runtime este mai sofisticată decât acest exemplu simplificat, deoarece trebuie să gestioneze mulți qubiți cu caracteristici de citire distincte, evitând în același timp construirea matricei de atribuire complete.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Pentru acest exemplu presupunem că erorile de citire ale diferiților qubiți sunt independente, ceea ce permite construirea matricei de atribuire pe doi qubiți ca produs tensorial al matricelor corespunzătoare pe un qubit.
Obținem rezultatele brute și cele atenuate pentru comparație.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
În acest punct, am caracterizat experimental modul în care procesul de măsurare distorsionează probabilitățile ideale ale rezultatelor. Scopul nostru este acum să anulăm această distorsiune și să aplicăm corecția rezultată asupra probabilităților brute.
Deoarece efectuăm o inversare liniară și nu o corecție fizică, "probabilitățile" rezultate nu trebuie să fie întotdeauna pozitive. Cvasi-probabilitățile negative foarte mici sunt de așteptat și reflectă faptul că atenuarea măsurătorilor produce un estimator, nu o distribuție de probabilitate fizică.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Le convertim în numărători pentru reprezentare grafică.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
În final, ne uităm la distribuțiile brute, atenuate și ideale. "Numărătorile" atenuate de mai jos sunt doar un ajutor de vizualizare, obținut prin rescalarea cvasi-probabilităților atenuate.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
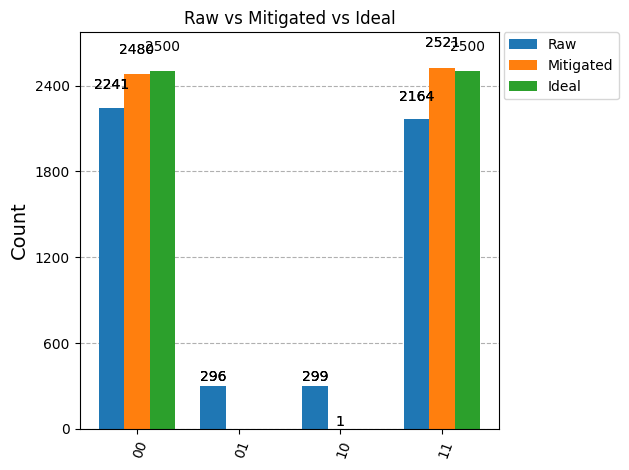
În mod clar, rezultatele atenuate cu M3 sunt mult mai apropiate de distribuțiile ideale, și putem vedea de ce.
Aplicarea M3 la fluxuri de lucru mai realiste este mult mai complexă. Ia în considerare:
- Computerele cuantice reale conțin mulți qubiți fizici, fiecare cu propriile caracteristici ale erorii de citire. Aceste erori trebuie modelate și combinate în mod adecvat.
- Matricea de atribuire completă crește exponențial cu numărul de qubiți și devine rapid imposibil de construit explicit. De aceea M3 se concentrează pe submulțimea de rezultate care contribuie semnificativ la distribuția observată, în loc să construiască întreaga matrice de atribuire.
- Pentru problemele reale de interes, distribuția ideală ar putea să nu fie cunoscută.
Din toate aceste motive, fluxul de lucru complet de atenuare este încapsulat în addonul Qiskit mthree.
Un exemplu M3 mai mare
Aplicăm acum M3 unui circuit mai mare, pentru care determinarea manuală a subspațiului relevant al lui ar fi anevoioasă, dar care este încă suficient de simplu încât să cunoaștem distribuția ideală: o stare GHZ. Începem prin a importa pachetul mthree și a defini un circuit cuantic GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
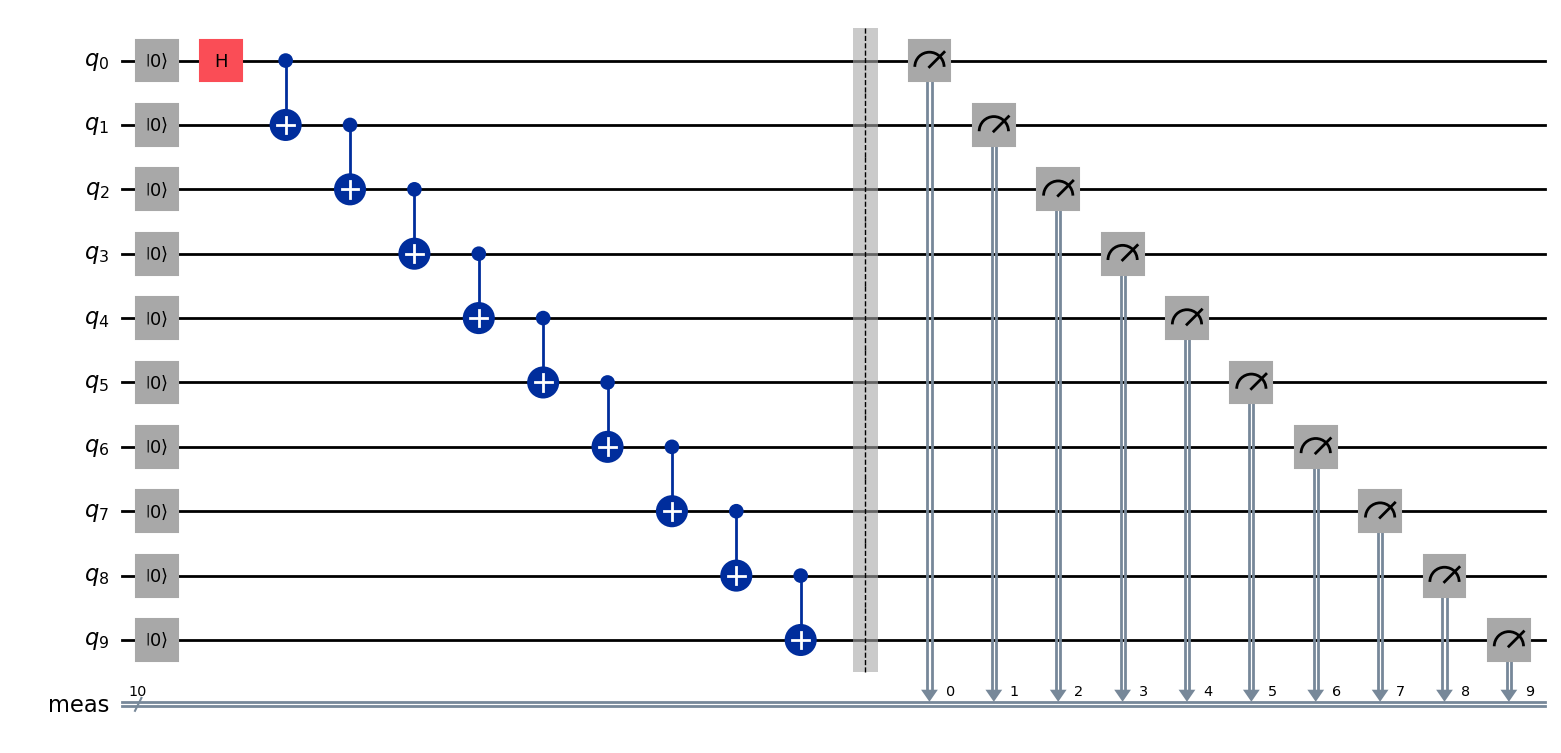
Pentru a rula acest lucru pe un computer cuantic real, importăm qiskit_ibm_runtime și alte pachete necesare. Folosim SamplerV2 pentru a obține o distribuție a rezultatelor.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Acum transpilăm circuitul pentru backend-ul nostru. Setăm aici nivelul de optimizare la 0 pentru a ne concentra pe efectele M3, fără a adăuga alte instrumente. Aceasta înseamnă că fidelitatea finală nu va fi reprezentativă pentru ceea ce se poate obține pe hardware-ul IBM Quantum® folosind întreaga suită de instrumente disponibile, dar ne permite să ne concentrăm specific pe utilitatea M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Configurăm acum Sampler, dezactivând din nou tehnicile suplimentare de suprimare a erorilor, precum decuplarea dinamică și twirling-ul.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
În final, executăm job-ul.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Putem extrage numărătorile brute din circuitul de mai sus.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Acum rulăm mthree pe backend-ul nostru pentru a caracteriza modelul de atribuire folosit la atenuarea măsurătorilor. Rescalăm distribuția brută folosind aceste informații. Reține că acest lucru poate duce uneori la probabilități negative foarte mici (de aici termenul cvasi-probabilități).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Corecția mthree produce cvasi-probabilități, nu numărători. Putem rescala manual la numărători. Funcția ajutătoare de mai jos convertește în numărători și rotunjește la valori întregi. De asemenea, pentru circuite mari, vor exista multe șiruri eronate cu foarte puține numărători, dar care aglomerează o histogramă. A doua funcție ajutătoare de mai jos elimină orice șiruri cu mai puține numărători decât un prag ales de noi, pentru a ne oferi o imagine clară a termenilor dominanți din distribuție.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Putem produce de asemenea cu ușurință distribuția teoretică, ideală, în care avem probabilități egale pentru stările cu toți zerourile și cu toți de unu, și probabilitate zero pentru toate celelalte rezultate, pentru comparație.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
În final, putem vizualiza rezultatele.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
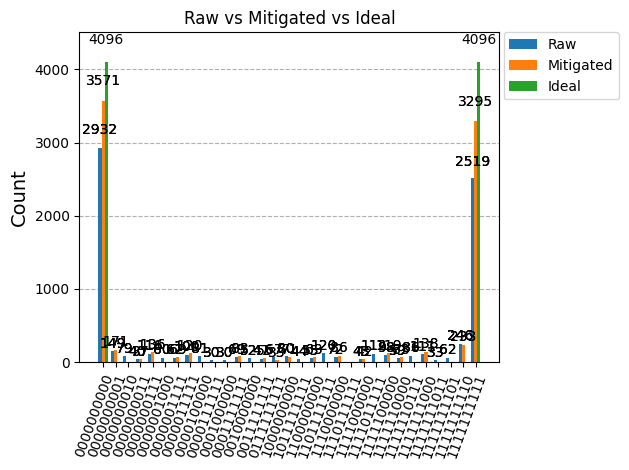
Rezultatele atenuate sunt mai apropiate de distribuția ideală decât cele neatenuate. Putem cuantifica acest lucru mai bine folosind numărătorile pentru șirurile de biți ideale.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Acest instrument simplu ne-a îmbunătățit fidelitatea cu 26% față de fidelitatea neatenuată, cu un cost suplimentar destul de mic. În mod clar, M3 poate fi foarte valoros. Dar circuitul GHZ a fost ales ca un caz de utilizare bun, deoarece este puternic concentrat pe două stări de ieșire. Unele probleme duc la numărători distribuite mai uniform (stări cu entropie ridicată). Pentru circuite foarte adânci cu mulți qubiți, erorile porților și zgomotul fără legătură cu erorile de măsurare vor duce adesea la o stare cu entropie ridicată. În astfel de cazuri, M3 operează pe un spațiu de stări destul de mare. Există trei abordări posibile:
(1) Acceptă că aceasta este o limitare a M3.
(2) Reține că limita superioară a spațiului matricei formate de M3 este num_shots num_shots, și nu , prima fiind mult mai mică pentru un număr mare de qubiți .
(3) Doar cu mare precauție, elimină din numărătorile brute furnizate lui M3 șirurile de biți cu probabilitate foarte mică. Acest lucru ar putea introduce o deplasare (bias), iar limitarea suportului stărilor tale poate interfera cu convergența în abordări precum metoda Krylov. Aceasta ar trebui făcută doar atunci când știi exact de ce o faci și poți anticipa toate efectele ei. De aceea o astfel de tăiere nu este o funcționalitate integrată a M3.
Pentru mai multe informații despre addonul Qiskit mthree, consultă exemplele, instrucțiunile de instalare, informațiile de fond și referințele API din documentația sa.
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) este o tehnică de atenuare a erorilor de măsurare folosită pe computerele cuantice moderne. Scopul ei este să elimine deplasarea (bias) introdusă de erorile clasice de citire, fără a necesita caracterizarea completă sau inversarea matricei de atribuire a măsurătorilor.
TREX nu este corecție a erorilor și nu îmbunătățește fidelitatea stării. În schimb, asigură că estimatorii valorilor de așteptare sunt nedeplasați în raport cu zgomotul de citire, până la eroarea statistică, prin mediere peste baze de măsurare randomizate și rescalare. Pe hardware-ul IBM Quantum, TREX este metoda implicită de atenuare pentru estimarea valorilor de așteptare și corespunde lui resilience_level = 1 în primitiva IBM Quantum Estimator.
Natura erorilor de citire pe hardware supraconductor
La qubiții supraconductori IBM, erorile de citire sunt dominate de:
-
Probabilități asimetrice de inversare a bitului (de exemplu, mai frecvent decât invers)
-
Relaxare dependentă de stare în timpul măsurării însăși
-
Diafonie ușoară, dar nenegligabilă, între rezonatorii de citire vecini
Important, aceste erori pot fi adesea modelate ca un proces stocastic clasic care acționează asupra rezultatelor măsurătorilor. TREX exploatează o idee standard din adaptarea zgomotului (noise tailoring): randomizarea (twirling) procedurii de măsurare. TREX se desfășoară de obicei în două etape:
-
Twirling și "untwirling" clasic
-
Rescalarea valorilor de așteptare folosind circuite de calibrare
Presupune că o valoare de așteptare a observabilei este legată de estimări zgomotoase, astfel:
unde este un factor fix care scalează estimarea, iar este o deplasare provenind din sursele descrise mai sus. Folosim aici ca reamintire că abordăm doar eroarea de citire; mai există și eroarea porților de luat în considerare.
Chiar înainte de măsurare, fiecare qubit este conjugat aleatoriu cu un operator Pauli (precum I sau X). Rezultatele măsurătorilor sunt apoi "untwirled" clasic.
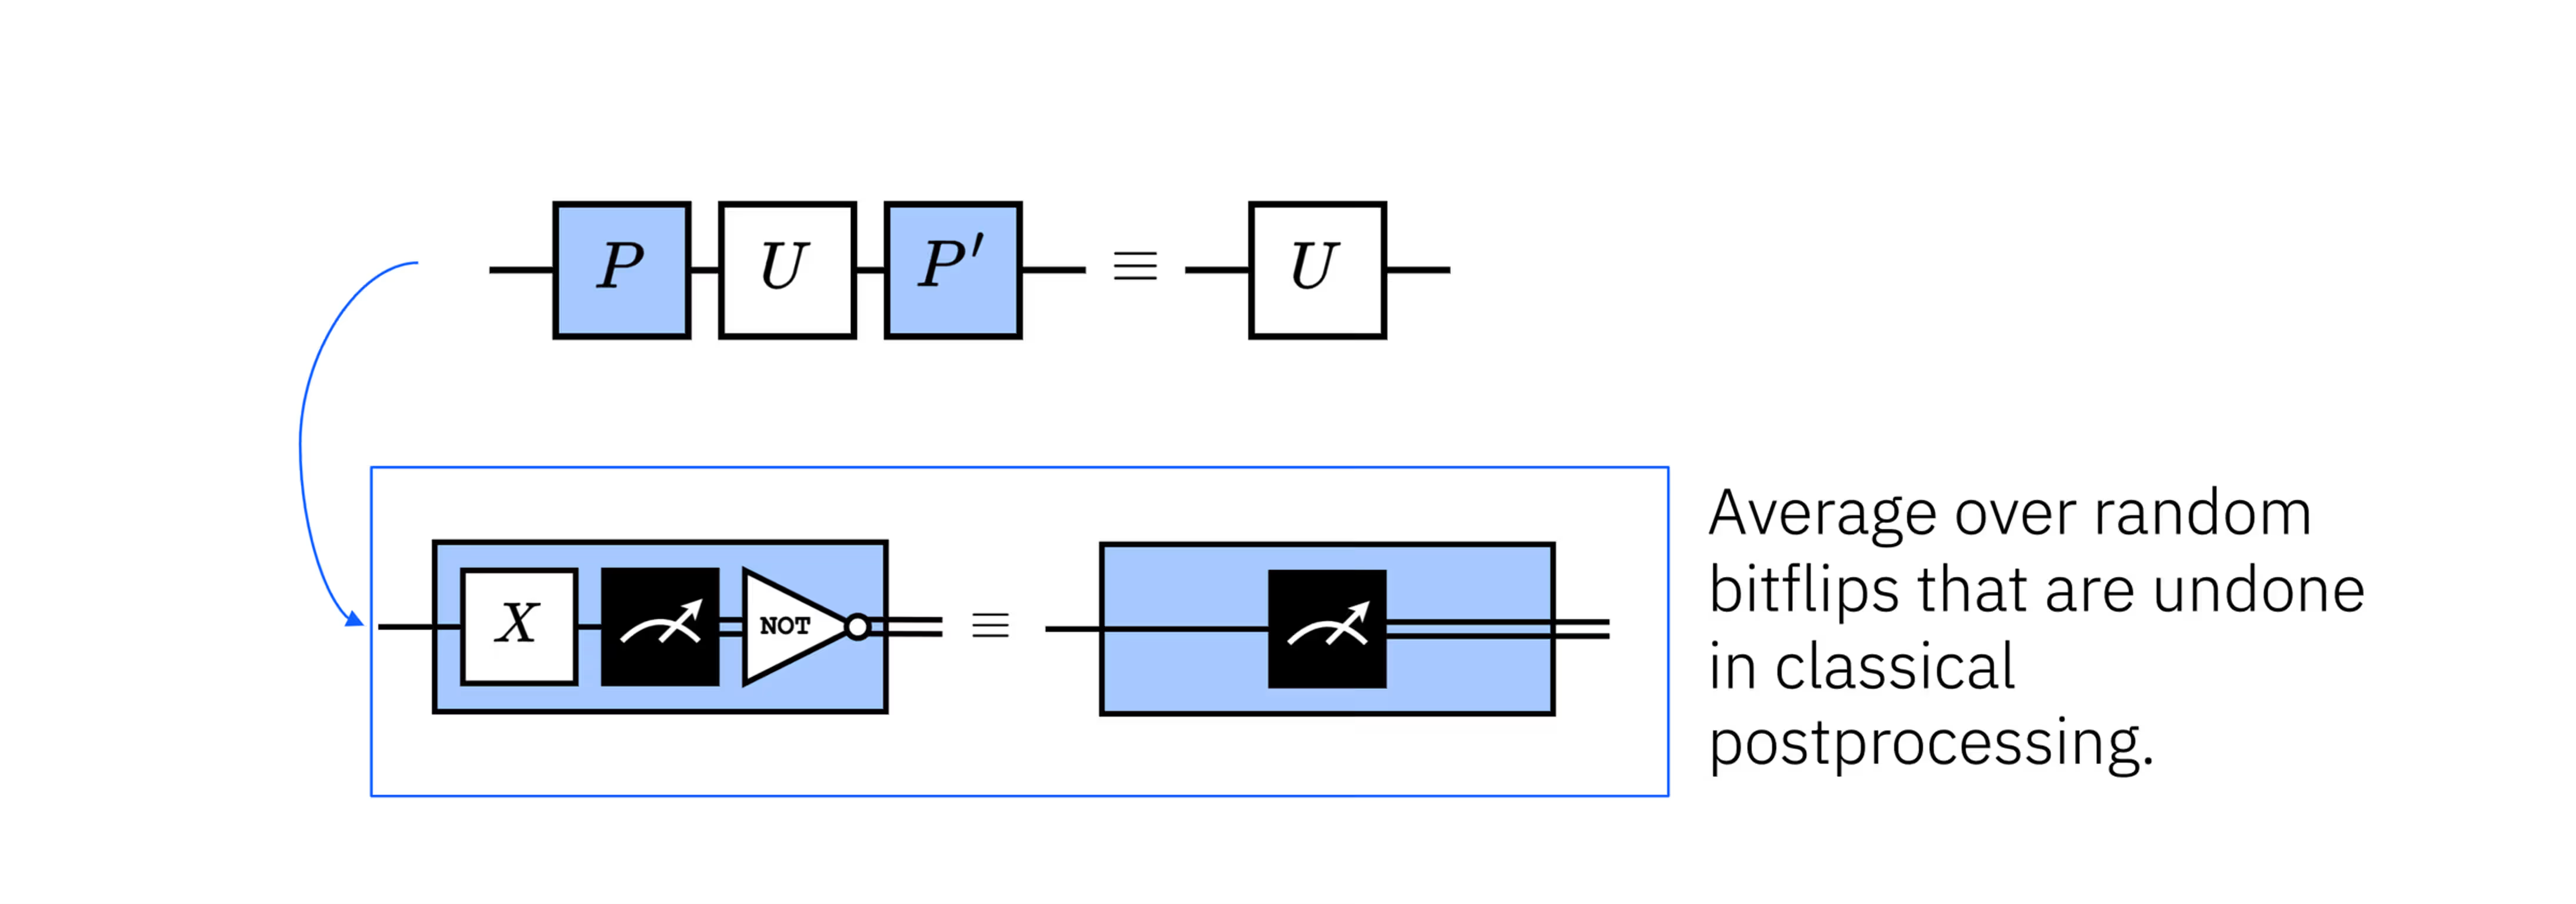
Medierea peste aceste randomizări simetrizează canalul de citire. Drept urmare, asimetriile sistematice din procesul de citire sunt convertite într-un canal de eroare mai simetric, al cărui efect rămas poate fi tratat prin calibrare și rescalare. Pe scurt, dacă de exemplu exista o înclinație spre starea , ne-ar lipsi unele măsurători ale lui . Prin twirling în jurul măsurătorii, interschimbăm aleatoriu ce rezultat logic este asociat procesului fizic de citire, apoi anulăm clasic acea interschimbare. Medierea peste multe astfel de măsurători randomizate elimină preferința sistematică pentru un rezultat raportat în detrimentul celuilalt. Aceasta elimină deplasarea dominantă a măsurătorii sub ipotezele modelului TREX, astfel încât avem:
Totuși, valorile de așteptare ar putea avea în continuare nevoie de rescalare. A doua etapă folosește circuite de calibrare (circuite cu rezultate cunoscute) pentru a estima factorul de scalare . Acesta poate fi apoi folosit pentru a obține o estimare mult îmbunătățită.
Valorile de așteptare ale observabilelor Pauli devin estimatori nedeplasați ai valorilor lor ideale. Nu se învață și nu se inversează niciun model explicit de zgomot, motiv pentru care TREX este stabil numeric și ieftin. Din nou, eroarea porților nu a fost abordată aici.
La estimarea unei valori de așteptare a observabilei , poate exista varianță datorată eșantionării finite, pot exista multe tipuri de erori incoerente și coerente, și poate exista de asemenea o deplasare, , datorată erorii de citire. Această deplasare provine din surse precum tranzițiile asimetrice discutate. În practică, această deplasare este de obicei bine modelată ca un canal stocastic clasic care acționează după evoluția cuantică. TREX transformă canalul efectiv de măsurare astfel încât estimatorul lui să fie nedeplasat în raport cu eroarea de citire. Acest lucru este relativ ușor de văzut folosind cel mai simplu exemplu de porți de twirling: X. Dacă există o asimetrie între și , dar comutăm aleatoriu care stare este citită (inversând înapoi mai târziu, clasic), atunci evident se elimină asimetria sistematică (deși eșantionarea finită înseamnă că ar mai putea exista o ușoară asimetrie stocastică în măsurare). În practică, porțile de twirling pentru TREX nu se limitează la I și X, dar acestea sunt suficiente pentru o explicație.
TREX ne permite să obținem o estimare a unei valori de așteptare lipsită de deplasarea datorată erorii de citire. Ar putea exista în continuare o deplasare dintr-o altă sursă (precum supra-rotația coerentă); TREX vizează doar citirea. Deoarece TREX înlocuiește deplasarea sistematică cu simetrizare randomizată, în general convertește deplasarea în varianță stocastică suplimentară, mărind varianța estimatorului la un cost de eșantionare fix.
Verifică-ți înțelegerea
Presupune că folosim estimator pe un circuit care a pregătit starea pentru estimarea lui . Presupune în continuare că erorile de măsurare fac ca rezultatele corespunzătoare lui să fie raportate ca în 10% din cazuri, în timp ce rezultatele corespunzătoare lui sunt raportate ca doar în 1% din cazuri. Asimetria dintre aceste erori de raportare introduce o deplasare a măsurătorii.
(a) În absența oricăror astfel de erori de măsurare, care ar fi valoarea de așteptare ideală a observabilei ?
(b) Cu erorile asimetrice de măsurare sau de citire, care este valoarea de așteptare a observabilei ?
(c) Ia în considerare un set limitat de porți de twirling Pauli: I și X. Presupune că I și X sunt aplicate aleatoriu cu probabilitate de 50% în mai multe shot-uri. Se aplică în continuare aceleași rate ale erorilor de măsurare. Apoi poarta Pauli (I sau X) este anulată clasic. Alcătuiește un tabel cu toate rezultatele posibile și probabilitățile lor, datorate suprapunerii inițiale, erorilor asimetrice de măsurare și porților Pauli atribuite aleatoriu.
(d) Folosește tabelul pentru a determina valoarea de așteptare cu strategia de twirling.
(e) Compară valorile de așteptare: ideală, fără twirling și cu twirling.
(f) Ce a fost omis din acest tratament și se găsește într-o aplicare completă a TREX?
Răspuns
(a) Poți folosi pur și simplu intuiția și simetria pentru a spune că . Pentru a arăta explicit:
(b) Starea poate colapsa fie în , fie în la măsurare, fiecare cu șanse de 50%. Dar din cele 50% care colapsează în starea , 1% (adică 0,5% din toate cazurile) vor fi raportate greșit ca . Din cele 50% care colapsează în , 10% (adică 5% din toate cazurile) vor fi raportate greșit ca . Rezultă:
- 54,5%
- 45,5% Ignorând toate celelalte tipuri posibile de erori, am obține o estimare de
(c)
| Pauli | Rezultat ideal al măsurătorii | Rezultat după Pauli | Eroare de citire | Anulare Pauli | Rezultat final raportat | Probabilitate |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Niciuna | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Niciuna | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Niciuna | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Niciuna | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Din părțile anterioare cunoaștem valorile de așteptare ale lui Z în fiecare dintre stările finale. Trebuie doar să calculăm media ponderată:
(e) În acest caz foarte simplu, aplicarea twirling-ului a recuperat exact valoarea de așteptare ideală. Acest lucru nu este tipic. Ceea ce este tipic este că twirling-ul anulează deplasările precum cele introduse de tranzițiile asimetrice și returnează o valoare de așteptare mai apropiată de cea ideală.
(f) Aceasta este o aplicare a unui model simplificat. Ar putea lipsi mai multe lucruri. În special, nu am rulat aici circuite de calibrare pentru a estima un factor de rescalare . Acest lucru este de obicei necesar.
Detalii de implementare
TREX se aplică automat la folosirea primitivei EstimatorV2 cu resilience_level = 1 (valoarea implicită). Reține că nu se aplică automat primitivei Sampler, deoarece Sampler returnează distribuții de probabilitate complete, nu valori de așteptare.
Când TREX este activat, runtime-ul generează variante de circuit cu twirling al măsurătorii, inserând operatori Pauli aleatorii pe un singur qubit chiar înainte de măsurare. Post-procesarea clasică inversează acești operatori Pauli. Aceste variante de circuit sunt aleatorii între shot-uri diferite și, de asemenea, între qubiți diferiți dintr-un shot. Toate variantele de circuit sunt apoi combinate într-un singur estimator.
TREX este foarte scalabil. Necesită circuite de calibrare suplimentare, astfel încât costul suplimentar de eșantionare este de obicei un factor constant mic (adesea 2-4x). Dar atenuarea este specifică observabilei, nu păstrează distribuția.
TREX este conceput să se integreze fără probleme cu multe metode de suprimare și atenuare a erorilor, inclusiv următoarele:
-
Decuplare dinamică (DD) - acționează în timpii de inactivitate, ortogonală față de atenuarea citirii.
-
Twirling de porți sau Pauli - adesea complementar; TREX se bazează deja pe twirling, dar vizează doar zgomotul de citire.
-
Zero-Noise Extrapolation (ZNE) - ZNE vizează zgomotul porților, în timp ce TREX tratează deplasarea măsurătorii. Această combinație este folosită la nivelul de reziliență 2.
-
Amplificarea probabilistică a erorilor și anularea probabilistică a erorilor în fluxurile de lucru Estimator.
Totuși, unele metode nu pot (sau nu ar trebui) fi combinate cu TREX:
-
Corecția probabilităților la nivel de Sampler: TREX nu returnează probabilități corectate ale șirurilor de biți.
-
Atenuare post-hoc pe date TREX deja atenuate: dubla corecție poate reintroduce deplasarea.
Combinarea TREX cu atenuarea erorilor de citire bazată pe matricea de atribuire, precum M3, este dificilă. M3 presupune un canal de măsurare fix. TREX randomizează deliberat măsurarea, invalidând presupunerea folosită de M3. În acest sens, nu poți pur și simplu să combini aceste tehnici. Totuși, dacă aplici twirling de măsurare în timpul calibrării folosite în M3, ai putea valorifica simultan o abordare de tip matrice de atribuire și o abordare de atenuare prin twirling (deși această abordare prin twirling nu este chiar la fel cu TREX). Aceasta este o temă recurentă în combinarea tehnicilor de atenuare și suprimare: adăugarea oarbă a tehnicilor eșuează; adăugarea lor cu grijă, astfel încât să fie „conștiente" una de alta, poate funcționa și poate fi foarte benefică.
TREX garantează doar valori medii libere de bias cauzat de erorile de citire; nu reduce varianța și nici nu protejează împotriva altor tipuri de bias. Cu siguranță nu corectează toate erorile. Totuși, adesea reprezintă o îmbunătățire substanțială și se poate obține cu un overhead mult mai mic decât al altor metode care necesită învățarea unor modele complete de zgomot. TREX este adesea cea mai ieftină și mai robustă atenuare a erorilor de citire disponibilă, ceea ce o face o alegere implicită excelentă în experimente.
TREX cu Qiskit
Aici creăm un circuit simplu cu doi qubiți și folosim Estimator pentru a estima valoarea medie a unei observabile foarte simple, ZX. Valoarea medie ideală este 1. Vom compara valorile medii cu și fără TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Creează circuitul cuantic simplu.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpilează circuitul folosind un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Aplică observabilei același layout obținut la transpilare.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Rulează experimentul pe un computer cuantic real. Mai întâi continuăm cu reslience_level = 1; aceasta este valoarea implicită, dar am făcut-o explicită pentru a distinge cele două cazuri.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Acum setăm resilience_level la 0 pentru a rula fără TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Valoarea medie este substantial mai aproape de cea ideală (1) cu TREX, așa cum era de așteptat. Desigur, aceasta a fost o singură valoare medie pe un singur qubit. Pregătim acum un circuit care folosește porți non-Clifford și mulți qubiți, pentru a testa dacă îmbunătățirea adusă de TREX rămâne robustă într-un alt context.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Aici, unghiul de rotație nu are nimic special. Am ales pur și simplu o suprapunere inegală oarecare de și pentru a investiga efectele tranzițiilor eronate asimetrice și modul în care sunt tratate de TREX. Având această stare, valoarea medie ideală a lui Z pe fiecare qubit, în absența oricăror erori (de citire sau de altă natură), ar fi:
Sperăm așadar să obținem valori medii apropiate de -0.924 pe toți qubiții. Vom vedea dacă TREX îmbunătățește fiecare valoare medie în parte și dacă îmbunătățește și media pe toți qubiții.
Verifică-ți înțelegerea
Verifică prin calcul direct valoarea medie de mai sus.
Răspuns
Transpilăm folosind un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Acum construim câte o observabilă pentru fiecare qubit, astfel încât să putem estima toate cele douăzeci de valori medii într-un singur flux de lucru. Adică, pentru al qubit, vrem o observabilă cu identități peste tot, cu excepția poziției , unde vrem un . Nu uita să aplici layoutul transpilat și observabilelor tale.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Acum putem executa. Celula de cod de mai jos folosește session mode; dacă nu ai acces la sesiuni, o poți înlocui cu batch mode pentru a rula același flux de lucru, dar cu posibile timpi de așteptare în coadă între circuite.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Aici comparăm erorile absolute medii cu și fără TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
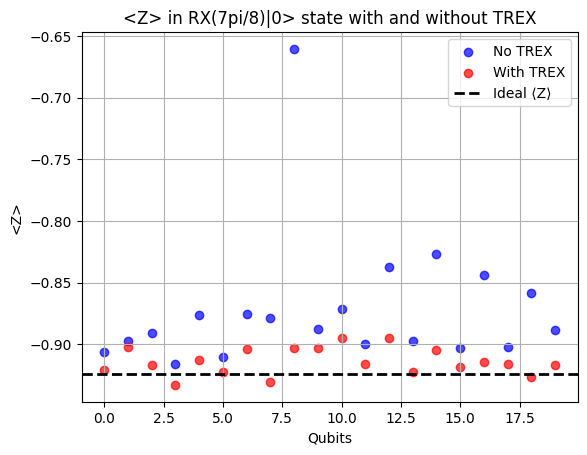
Se pare că TREX a ajutat cu siguranță. Valoarea medie pe fiecare qubit s-a îmbunătățit, cu singura excepție a qubitului 16. Un astfel de caz izolat este de așteptat. Putem cuantifica efectul general al TREX asupra circuitului calculând valorile medii.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
În medie, TREX ne-a apropiat rezultatele cu aproximativ 2.9% de cele ideale și ne-a lăsat cu un rezultat care, în medie, diferă de idealul teoretic cu doar 0.4%. Este excelent, iar această îmbunătățire cu overhead redus este exact motivul pentru care TREX este atenuarea implicită a erorilor în Estimator. Dar trebuie să subliniem încă o dată că TREX elimină un bias al erorii de citire, nu corectează toate erorile noastre. Am ales o stare inițială care avea șanse mari să fie afectată de asimetria citirii. Efectul ar fi fost diferit dacă am fi pregătit fiecare qubit într-o altă stare. Pentru un argument trivial de ce trebuie să fie așa, gândește-te ce s-ar întâmpla dacă am lăsa fiecare qubit în starea fundamentală . Nu ar exista nicio ocazie de a observa (sau corecta) o asimetrie a erorii de citire între stările și .
Extrapolarea la zero zgomot (ZNE)
Extrapolarea la zero zgomot (ZNE) este una dintre cele mai utilizate tehnici de atenuare a erorilor. Strategia generală este ușor de înțeles, deși detaliile implementării sunt complexe. ZNE funcționează astfel:
-
Rulează un circuit țintă la mai multe „niveluri de zgomot" — modificări ale circuitului care fac ca zgomotul său să scaleze în moduri previzibile
-
Estimează observabila de interes pentru fiecare scală de zgomot.
-
Extrapolează înapoi la zero zgomot folosind un model de ajustare (liniar, polinomial, exponențial etc.).
Rezultatul este o estimare a ceea ce ar fi fost observabila în limita de zero zgomot implicată de modelul de extrapolare.
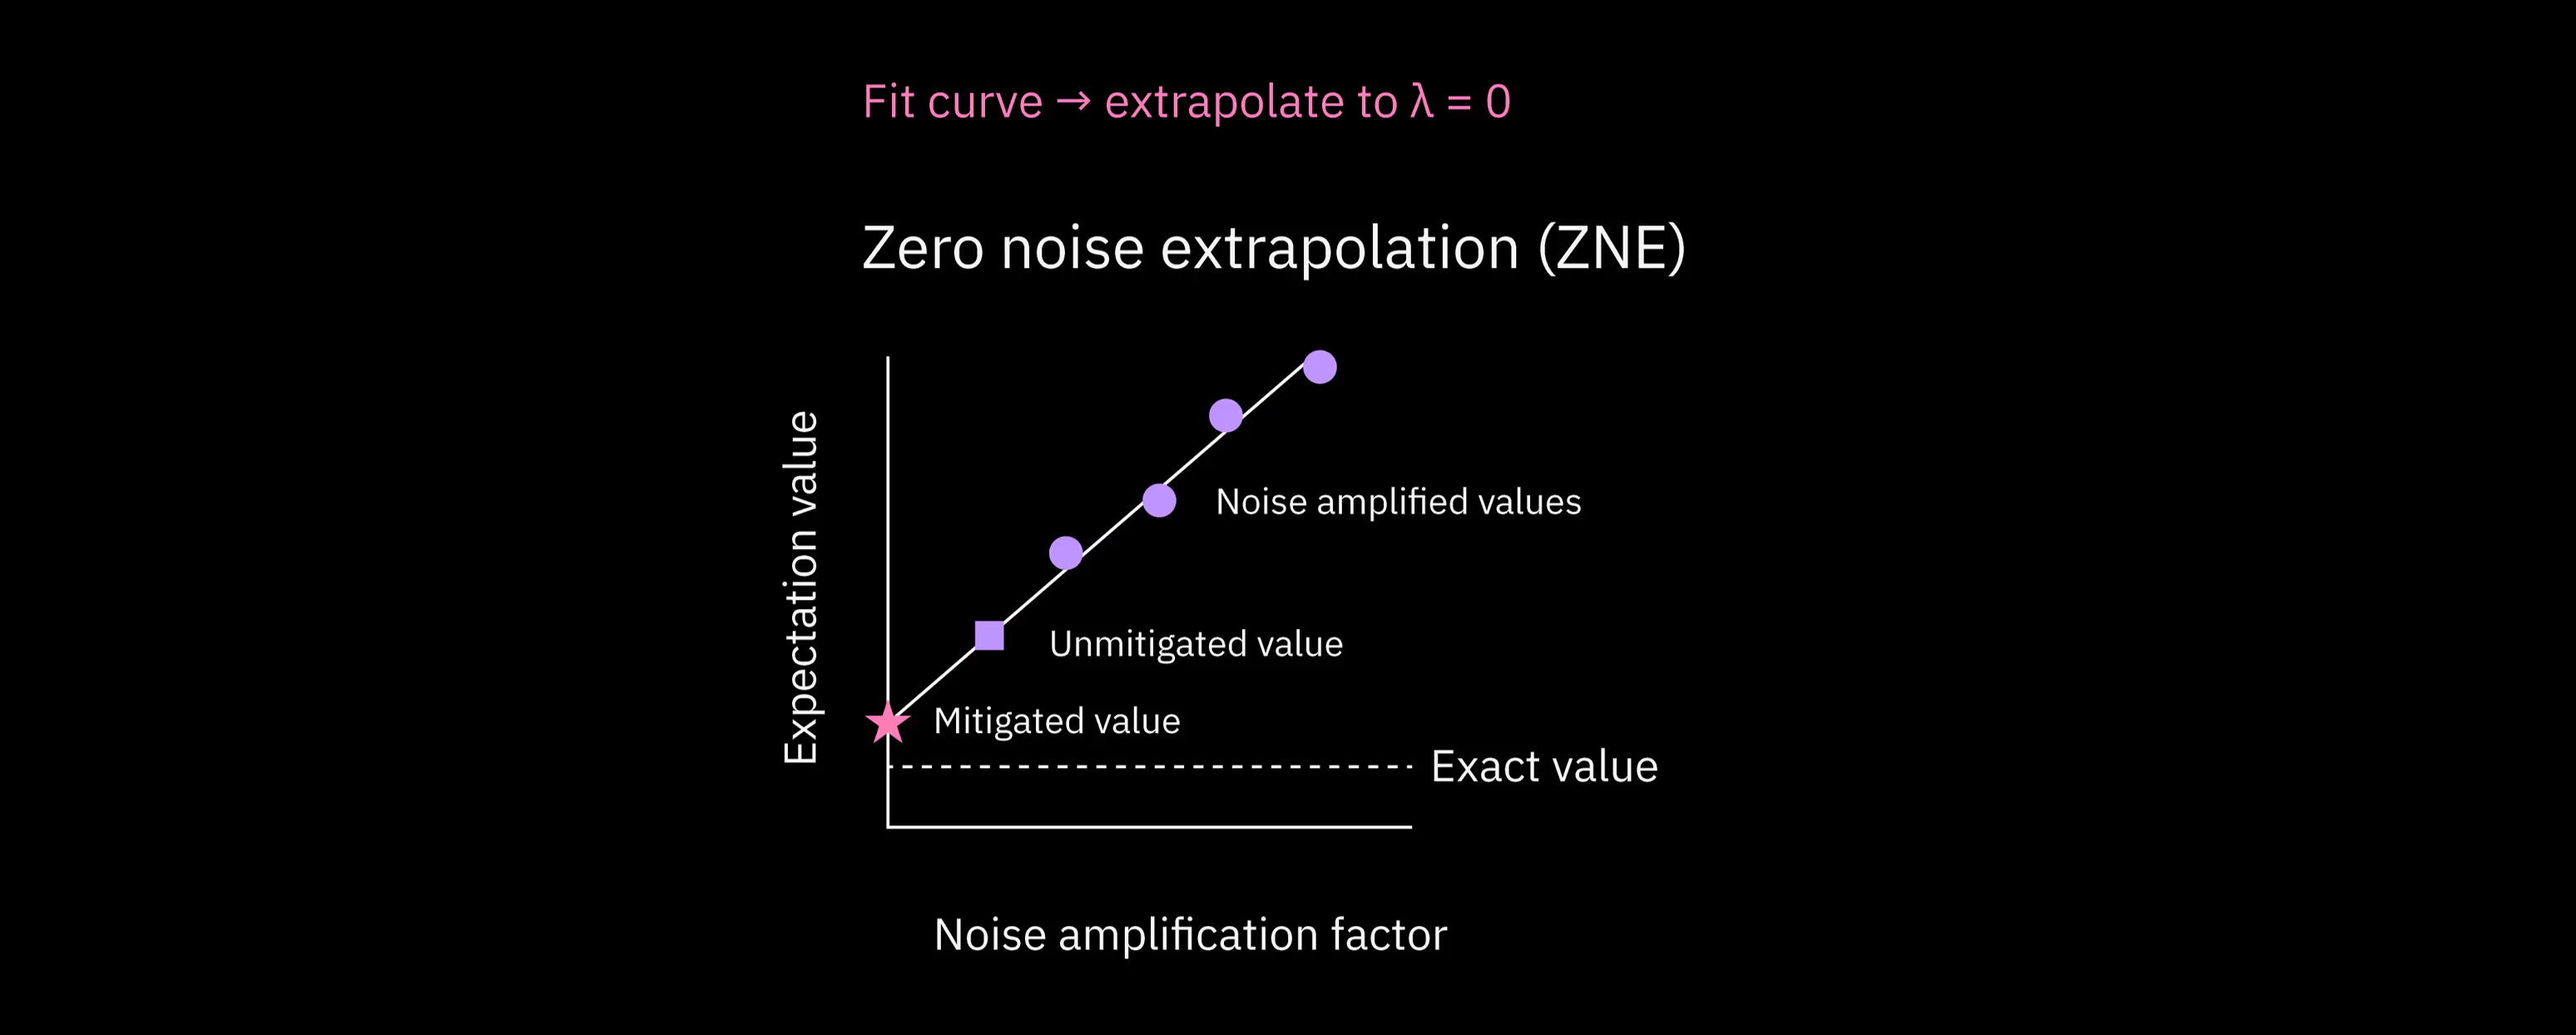
ZNE nu garantează că zgomotul crește uniform sau liniar pe măsură ce modificăm circuitele. În schimb, presupune că scalarea zgomotului se comportă suficient de bine pentru a permite extrapolarea. Complexitatea ZNE constă în modul în care se modifică circuitele pentru a satisface cât mai bine această presupunere. Vom examina câteva abordări în această lecție.
Scalarea resurselor în ZNE
În ZNE, overheadul este în mare parte unul cuantic. Adică, pentru a obține valori medii la niveluri de zgomot, trebuie să efectuezi experimentul pe circuite, fiecare cu multe shoturi. Pentru a menține o precizie statistică fixă, numărul total de eșantioane crește în general pe măsură ce se introduc circuite suplimentare cu zgomot scalat.
Numărul de niveluri de zgomot pe care le examinezi, , depinde de metoda folosită pentru scalarea zgomotului. Pentru o tehnică simplă de scalare a zgomotului (numită „gate-folding", discutată mai jos), este de obicei între 3 și 5. O altă metodă (amplificarea probabilistică a zgomotului, PNA) permite factori de zgomot non-întregi și duce de obicei la niveluri de zgomot mai mici decât gate-folding. Overheadul total scalează aproximativ astfel:
unde este numărul de bază de shoturi. Un alt aspect de reținut este că, dacă scalarea zgomotului implică porți repetate, adâncimea circuitului poate crește cu un factor proporțional cu valoarea de scalare a zgomotului. Scalarea zgomotului care vine odată cu adâncimea crescută este chiar scopul, dar ține cont de adâncimea totală.
ZNE se potrivește bine problemelor în care se aplică următoarele puncte:
-
Ai nevoie de o metodă de atenuare de uz general, eficientă pentru multe tipuri de erori.
-
Adâncimea circuitului nu este prea mare; ZNE eșuează când circuitul scalat devine prea zgomotos pentru extrapolare.
-
Poți tolera un overhead moderat de timp de execuție pentru o acuratețe mai bună.
În practică, acest lucru face ZNE ideală pentru multe circuite variaționale, estimarea valorilor medii și alți algoritmi cuantici pe termen scurt. Este implementată în Estimator folosind resilience_level = 2. Reține că ZNE extrapolează într-un spațiu care are un singur rezultat în funcție de zgomotul din întregul circuit. Aceasta înseamnă că se pretează la probleme de estimare, dar nu la probleme de eșantionare. Nu este concepută pentru a lucra cu distribuții de bitstring-uri.
Factori de zgomot
Cum putem crește exact nivelul de zgomot dintr-un circuit? Există două moduri principale, deși există multe variante.
-
Înlocuiește o poartă sau un bloc de porți cu . Deoarece porțile din computerele cuantice sunt unitare, știm că , astfel încât logic: . Totuși, fiecare repetiție a lui sau adaugă o eroare similară sau identică, ceea ce ne permite să scalăm nivelurile de zgomot/eroare. Observă că înlocuirea de mai sus ne duce de la zgomotul original al porții (nivel de zgomot 1) la de trei ori acel nivel în (nivel de zgomot 3). În practică, putem repeta ultimele două porți de ori: pentru a obține un nivel de zgomot . Aceasta se numește gate folding și este o tehnică foarte comună de scalare a zgomotului.
-
Există și alte metode de creștere a nivelului de zgomot, precum amplificarea probabilistică a erorilor (PEA). În PEA, învățăm mai întâi un model de zgomot adecvat pentru circuit, exprimat de obicei ca un canal Pauli. Zgomotul este apoi amplificat prin eșantionarea dintr-o versiune rescalată a acestui canal de zgomot învățat. Ajustând eșantionarea, poți scala continuu intensitatea efectivă a zgomotului, inclusiv la valori non-întregi.
În practică, gate folding poate scala erorile foarte fiabil, dar poate duce și la circuite foarte adânci. Dacă ai nevoie doar de trei niveluri de zgomot (1, 3 și 5), înseamnă că măriți adâncimea circuitului de 5 ori și totuși obții rezultate rezonabile. Așadar, dacă circuitul tău țintă are o adâncime transpilată, la doi qubiți, de 60 sau mai mult, PEA se potrivește probabil mai bine decât gate-folding.
Porțile pot fi pliate fie local (adică repeți pentru fiecare poartă cu doi qubiți imediat ce apare), fie pot fi grupate într-un bloc de porți și blocul poate fi repetat (precum porțile ). Adesea plierea locală este preferabilă pentru presupunerile făcute de ZNE, dar ambele sunt posibile.
Tratamentul statistic al rezultatelor cu zgomot scalat în ZNE implică multe nuanțe. De exemplu, la un nivel de zgomot de cinci ori mai mare, rezultatele tale vor avea cu siguranță o varianță mai mare și vor fi mai puțin fiabile. Ar trebui tratate cu aceeași pondere ca punctele de date cu zgomot mai mic? Nu. Totuși, pentru a vedea ZNE în acțiune, vom ignora o parte din această complexitate într-un experiment cu model simplificat, în care vom construi manual circuitele pliate și vom face o extrapolare naivă cu ponderi egale pentru a ilustra pașii cheie. Dar vom urma cu un experiment care folosește funcționalitatea ZNE din Qiskit și vom vedea că gestionează mult mai bine complexitatea pe care o sărim.
ZNE manual
Începem prin a alege un circuit cuantic și o observabilă pentru care putem calcula valoarea medie ideală în absența zgomotului și a erorilor. Alegem o stare GHZ , cu un număr par de qubiți. Observabila noastră este . Alegem aceasta din mai multe motive:
- Valoarea medie este trivial de calculat în cazul ideal. Deoarece numărul de qubiți este par, obținem fie un
1de la fiecare , înmulțite împreună, fie un-1de la fiecare , înmulțite împreună de un număr par de ori. - Aceasta va fi destul de sensibilă la erori și zgomot, deoarece o singură eroare pe un qubit poate schimba rezultatul general al acelui shot de la +1 la -1.
- Valoarea medie este departe de 0. ZNE poate întâmpina dificultăți când valoarea medie ideală este foarte aproape de zero, deoarece nivelurile ridicate de zgomot tind să randomizeze rezultatele, făcându-le pozitive la fel de des ca negative. Rezultatul este că valorile cu zgomot mare vor ajunge să dea valori apropiate de cea ideală; acest lucru poate face extrapolarea foarte dificilă.
Cu această motivație în minte, să construim circuitele.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Observă subtilitatea că aici . Chiar dacă gate folding a fost prezentat ca fiind format din operatori de forma , aici aceeași structură arată ca CNOT CNOT CNOT.
Să ne asigurăm că circuitul nostru este într-adevăr circuitul GHZ normal:
ghz_amp[0].draw("mpl")
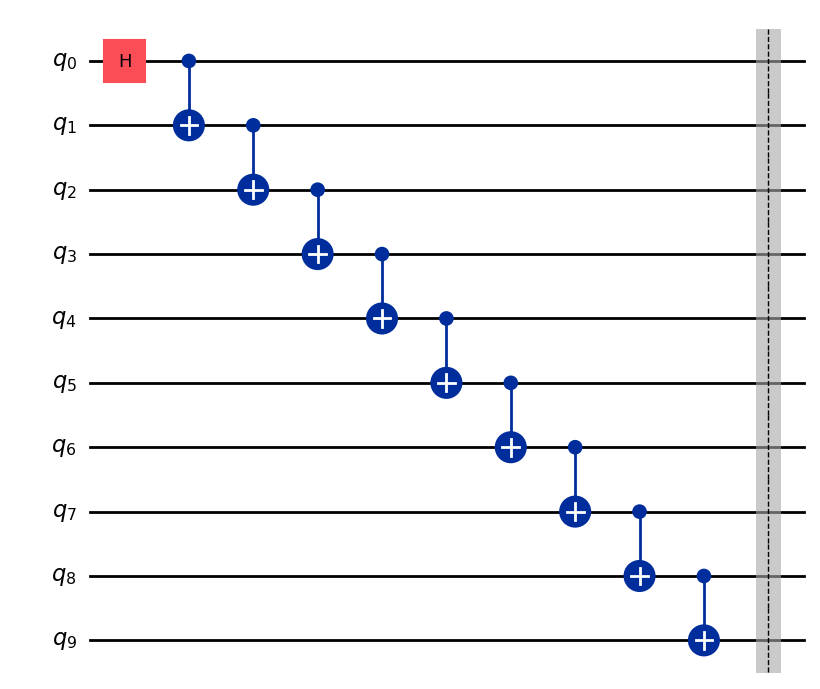
Poți privi celelalte circuite pentru a verifica dacă au structura așteptată.
Acum construim observabilele.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Construim un pass manager și îl aplicăm circuitelor noastre. Apoi luăm layout-urile și le aplicăm observabilelor.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Formatează pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Acum rulăm Estimator. Ne-ar plăcea să ne concentrăm pe rolul ZNE, așa că am putea seta resilience_level = 0 pentru a evita amestecarea efectelor twirling-ului cu efectul ZNE. Totuși, vrem să comparăm și ZNE-ul nostru „manual" cu setările ZNE integrate în Qiskit, care includ twirling. Prin urmare, setăm aici resilience_level = 1. Setarea resilience_level = 2 invocă setările ZNE din Qiskit, pe care le vom folosi în curând.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Acum afișăm nivelurile de zgomot și valorile medii.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Aceasta este partea în care suntem cei mai neglijenți: facem o ajustare liniară a acestor date fără să acordăm atenție varianței fiecărei valori obținute și fără să încercăm să prezicem teoretic dacă ajustarea trebuie să fie liniară. Din nou, ZNE-ul integrat face o treabă mult mai bună decât ceea ce facem noi manual.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Trasăm graficul înainte de interpretare.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
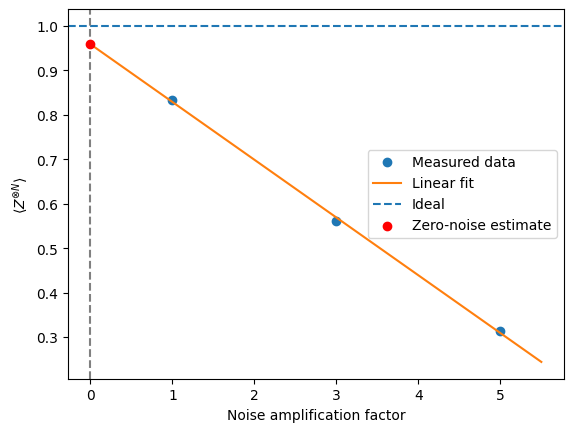
La crearea acestei lecții, din extrapolarea la cazul de zero zgomot obținem o valoare medie de 0.959. Valorile tale pot diferi. Aceasta este substanțial mai bună decât valoarea medie a circuitului brut, de 0.83, cu aproximativ 13% mai aproape de valoarea ideală. Dar poți vedea și că folosim un punct de date la care valoarea medie a scăzut la 0.31. Evident, acest punct de date este de calitate mai slabă. Dacă acestui punct i s-ar fi acordat o pondere mai mică în aproximarea noastră liniară, iar dreapta ar fi fost ajustată mai mult după primele două puncte de date, vedem că estimarea extrapolată la zero ar fi fost mai mare (mai aproape de valoarea ideală). Acest gen de considerente este gestionat automat în ZNE-ul integrat în Estimator.
ZNE integrat în Estimator
Acum să vedem ce se întâmplă când folosim funcționalitatea ZNE integrată în Estimator. Începem prin a defini un circuit GHZ simplu, fără gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Definim aceeași observabilă ca înainte.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Definim din nou un pass manager, folosind optimization_level = 1. Vom reveni mai jos asupra acestei alegeri.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpilează circuitul și aplică layoutul observabilelor.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Rulăm Estimator folosind ZNE și twirling și comparăm rezultatele cu implementarea noastră ZNE manuală. În special, le comparăm cu rezultatul fără ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Putem obține valorile pentru fiecare factor de zgomot folosind sintaxa job_zne.result()[0].data.evs_noise_factors. Ca înainte, am putea folosi naiv aceste rezultate pentru a obține o ajustare liniară și a extrapola la cazul de zero zgomot, dar estimatorul cu resilience_level = 2 a făcut deja o treabă mai bună, luând în considerare varianța și alte aspecte. Mai jos arătăm ce ar da o extrapolare liniară și ce a dat de fapt ZNE-ul integrat.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
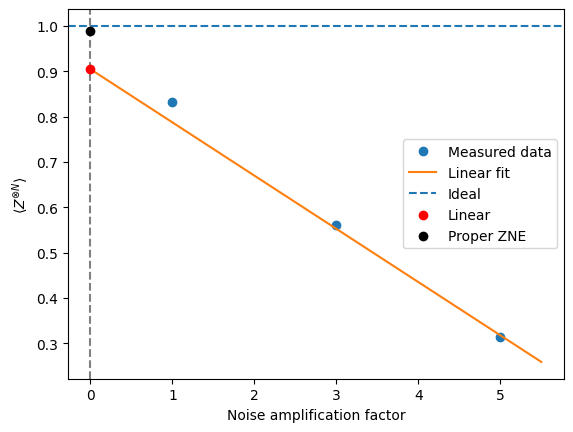
Vedem că ZNE-ul integrat ne-a îmbunătățit estimarea cu peste 15% și a funcționat considerabil mai bine decât încercarea noastră manuală.
Înainte de a continua, reține că în toată această explorare ZNE am setat optimization_level = 1 în pass manager. Nivelurile mai ridicate de optimizare reduc eroarea, iar uneori reducerea erorii poate face ca erorile să scaleze mai puțin previzibil. Cum se întâmplă adesea, există un echilibru: reduci erorile, cu excepția cazului în care le crești intenționat cu un factor cunoscut.
Combinarea metodelor
ZNE se bazează pe următoarele:
-
Un parametru de scalare a zgomotului bine definit
-
O scalare suficient de netedă și previzibilă a valorilor medii cu
-
Același canal de zgomot efectiv, la intensități diferite
-
Niciun bias introdus care să nu scaleze cu
ZNE se combină curat cu tehnici care elimină bias-urile care nu scalează (precum M3) sau care fac zgomotul mai regulat (precum twirling), dar intră în conflict cu tehnici care fie încearcă să anuleze complet zgomotul (PEC), fie îl remodelează dinamic (DD).
În special, M3 abordează doar erorile de măsurare/citire, care în practică pot fi tratate separat de erorile de porți (care sunt ținta proceselor de scalare a erorilor din ZNE). M3 este în mare măsură independent de gate folding; poate fi combinat curat cu ZNE. TREX este foarte similar și poate fi combinat cu ZNE.
Pauli twirling se concentrează pe porți, spre deosebire de M3 și TREX. Totuși, amintește-ți că Pauli twirling nu atenuează direct eroarea/zgomotul; mai degrabă îl modifică pentru a-l face mai previzibil. Pauli twirling ar putea fi de fapt benefic pentru procesul ZNE, făcând erorile porților să scaleze mai liniar și astfel extrapolarea mai precisă.
Decuplarea dinamică (DD) este mai nuanțată. DD modifică dinamic comportamentul zgomotului prin anularea parțială a anumitor erori prin adăugarea de secvențe de porți. Dacă este posibil să construiești circuite astfel încât DD să se comporte la fel chiar și când porțile sau blocurile sunt pliate, atunci în principiu s-ar putea combina ZNE și DD, dar în practică DD interferează uneori cu scalarea. Dacă vrei să le combini, de luat în considerare sunt următoarele:
- Este DD aplicat consecvent la toate nivelurile de zgomot?
- Păstrează plierea structura DD?
- Se comportă scalarea rezultată a zgomotului în continuare monoton?
Ultima metodă de atenuare a erorilor pe care o discutăm ca abordare de sine stătătoare nu este compatibilă cu ZNE: anularea probabilistică a erorilor.
Anularea probabilistică a erorilor (PEC)
Spre deosebire de ZNE sau de atenuarea erorilor de măsurare, PEC încearcă să anuleze zgomotul la nivelul porților prin reconstruirea canalului ideal în valoare medie. Anularea probabilistică a erorilor (PEC) este cea mai puternică și cea mai costisitoare tehnică de atenuare a erorilor tratată în această lecție. PEC se bazează pe inversarea explicită a canalului de zgomot, realizată statistic, nu fizic. PEC funcționează astfel:
-
Caracterizează modelul de zgomot în termenii unei baze de „operații de eroare".
-
Exprimă inversul canalului de zgomot ca o distribuție cvasi-probabilistică peste operații fizice.
-
Eșantionează din această distribuție în timpul execuției circuitului pentru a construi statistic o estimare nedeplasată a calculului ideal.
Conceptual, PEC este ca o corecție virtuală a erorilor — „anulează" zgomotul combinând operații zgomotoase în tipare aleatorii ponderate cu grijă. Procedural însă, PEC nu este strâns legată de corecția sau de codurile de detecție a erorilor. Estimarea nedeplasată de către PEC a valorii medii ideale, fără zgomot, vine cu prețul unui overhead de eșantionare foarte mare și al unei dependențe puternice de o caracterizare precisă a zgomotului.
Pe computerele cuantice IBM, PEC este privită cel mai bine ca un instrument de precizie, nu ca un strat de atenuare de uz general: este cea mai potrivită pentru circuite mici sau porțiuni mici din circuite mai mari, sarcini de benchmarking și studii de înaltă acuratețe în care un overhead cuantic ridicat este acceptabil.
Caracterizarea canalului de zgomot
În PEC, fiecare poartă ideală dintr-un circuit cuantic este modelată ca un canal unitar ideal urmat de un proces de zgomot. Fie matricea densitate a stării cuantice. Poarta ideală este reprezentată de o matrice unitară , care induce un canal cuantic:
Pe hardware real, această evoluție ideală este alterată de zgomot. Modelăm implementarea fizică a porții ca un canal zgomotos efectiv:
unde este un canal de zgomot care surprinde erorile stocastice asociate porții. În toată această discuție, , și sunt aplicații liniare care acționează asupra operatorilor densitate. Canalul ideal este unitar și reversibil, în timp ce canalul de zgomot (și deci ) este o aplicație complet pozitivă care păstrează urma (CPTP).
PEC presupune că canalul de zgomot este cunoscut sau aproximativ cunoscut. Pe hardware-ul IBM Quantum, această informație se obține de obicei din datele de calibrare ale dispozitivului, din ratele de eroare deduse din experimente de benchmarking și din modele de zgomot simplificate, precum aproximările Pauli sau depolarizante pentru seturi mici de porți. Deși PEC nu necesită un model de zgomot perfect precis, performanța sa se degradează rapid pe măsură ce canalul de zgomot presupus diverge de comportamentul real al hardware-ului.
Descompunerea cvasi-probabilistică a canalului de zgomot invers
Ideea centrală a PEC este să anuleze efectul zgomotului în valoare medie construind o aproximare stocastică a inversului canalului de zgomot. Formal, scopul este aplicarea unei aplicații liniare care anulează aproximativ , astfel încât:
în valoare medie peste multe execuții ale circuitului.
Inversul este definit aici ca inversul algebric al lui tratat ca un superoperator liniar care acționează asupra operatorilor. Acest invers există doar dacă are rang complet; procesele de zgomot neinversabile nu pot fi atenuate exact folosind PEC.
Când inversarea este posibilă, PEC exprimă canalul de zgomot invers ca o combinație liniară de operații implementabile fizic:
Aici, fiecare este o operație zgomotoasă care poate fi executată pe hardware (de obicei porți native sau secvențe scurte de porți), iar coeficienții reali formează o distribuție cvasi-probabilistică. Spre deosebire de probabilitățile obișnuite, coeficienții pot fi negativi sau pot depăși 1.
Norma cvasi-probabilistică:
cuantifică costul inversării zgomotului. Pentru orice canal de zgomot netrivial, . Pe hardware-ul IBM Quantum, această descompunere se realizează de obicei:
- pe poartă sau pe set mic de porți,
- presupunând modele de zgomot restrânse (adesea aproximări Pauli-diagonale),
- folosind operații native specifice backend-ului și constrângeri de programare.
Reconstrucția Monte Carlo a circuitului ideal
Pentru a estima valoarea medie a unei observabile , PEC folosește eșantionare Monte Carlo bazată pe descompunerea de mai sus. Pentru fiecare apariție a unei porți zgomotoase în circuit, se aplică următoarea procedură:
-
Selectează aleatoriu o operație cu probabilitatea:
-
Atribuie o pondere clasică:
-
Execută circuitul zgomotos randomizat rezultat pe Backend-ul cuantic.
-
Înmulțește rezultatul măsurat cu produsul tuturor ponderilor acumulate.
-
Mediază rezultatele ponderate peste multe execuții ale circuitului.
Estimatorul rezultat satisface
cu condiția ca modelul de zgomot să descrie cu acuratețe hardware-ul. PEC nu introduce deci niciun bias sistematic în valoare medie, dar înlocuiește bias-ul cu o varianță statistică mare. Fiecare rulare produce o estimare zgomotoasă, dar ponderată; abia după medierea multor astfel de rulări apare valoarea medie ideală.
Interpretare conceptuală
PEC este uneori descrisă ca corecție virtuală a erorilor. Deși această formulare nu este complet greșită, nu trebuie confundată cu corecția cuantică adevărată a erorilor. PEC nu implică codificare logică, extragerea sindromului sau feedback în timp real. Erorile nu sunt prevenite sau corectate în timpul execuției circuitului.
În schimb, PEC anulează zgomotul statistic, combinând multe realizări zgomotoase ale circuitului cu ponderi clasice cu semn, astfel încât erorile se anulează doar după post-procesarea clasică. Informația nu este protejată în timpul execuției; rezultatele ideale sunt reconstruite ulterior.
Scalarea resurselor și costul
Costul dominant al PEC provine din amplificarea varianței. Varianța estimatorului PEC scalează astfel:
ceea ce implică:
Această scalare este fundamentală și nu poate fi îmbunătățită prin post-procesare clasică.
Pentru circuitele care conțin multe porți zgomotoase, fiecare poartă contribuie cu un factor , ceea ce face ca norma cvasi-probabilistică totală să crească aproximativ multiplicativ:
unde este adâncimea circuitului. Pe hardware-ul IBM Quantum, aceasta duce de obicei la o creștere exponențială a costului de eșantionare cu adâncimea circuitului, cu o sensibilitate deosebit de puternică la erorile porților cu doi qubiți. Această scalare impune limite practice aplicabilității PEC.
PEC este practică în prezent doar când sunt îndeplinite una sau toate dintre următoarele condiții:
-
Circuitele sunt foarte mici sau puțin adânci (adesea porți),
-
Modelele de zgomot sunt simple și bine validate (de exemplu, zgomot Pauli),
-
Costul statistic ridicat este acceptabil,
-
Scopul este acuratețea, nu debitul.
Din acest motiv, PEC este adesea aplicată pentru:
-
Subcircuite izolate din fluxuri de lucru mai mari,
-
Pași de evoluție pe timp scurt,
-
Rutine de pregătire a stării sau de măsurare,
-
Experimente de benchmarking și validare.
Stiva software IBM (IBM Quantum Compute și instrumentele de atenuare a erorilor) reflectă acest lucru tratând PEC ca pe o opțiune specializată, nu ca pe un strat implicit de atenuare.
Cazurile tipice de utilizare ale PEC includ:
-
Benchmarking de precizie al hardware-ului cuantic,
-
Verificarea algoritmilor cuantici mici,
-
Chimie cuantică de înaltă precizie pe sisteme reduse,
-
Verificarea încrucișată a ZNE sau a altor metode de atenuare.
Relația PEC cu alte metode de atenuare
Multe alte tehnici de atenuare sacrifică precizia în favoarea scalabilității; PEC face exact opusul, concentrându-se înainte de toate pe precizie.
Deoarece PEC poate fi folosit doar pe un subcircuit, este deosebit de important să ne întrebăm aici ce alte metode de atenuare pot fi combinate cu el. Pentru a raționa clar despre compatibilitatea cu PEC, este util să categorisim tehnicile după ce fac cu zgomotul. Luați în considerare aceste categorii generale:
-
Anularea zgomotului - încearcă să inverseze canalele de eroare
-
Scalarea zgomotului - crește deliberat zgomotul pentru a extrapola
-
Remodelarea zgomotului - schimbă structura sau spectrul zgomotului
-
Eliminarea părtinirii - corectează erorile care nu scalează cu zgomotul porților
PEC se încadrează clar în categoria (1). Orice metodă care modifică sau rescalează canalul de zgomot trebuie examinată cu atenție.
Tabel recapitulativ (la nivel înalt)
| Tehnică | Compatibilă cu PEC | Note |
|---|---|---|
| ZNE | Nu | Anulare versus scalare și uneori adaptarea erorii |
| Pauli twirling | Da (cu atenție) | Afectează comportamentul erorii, dar poate face învățarea ei mai ușoară |
| TREX | Da | Fără suprapunere în fluxul de lucru. Complet compatibile. |
| Dynamical decoupling | De obicei nu | Modifică canalul de eroare |
PEC și ZNE abordează aceleași surse de eroare (erorile porților) prin ipoteze sau fluxuri de lucru reciproc incompatibile, sau ambele. De exemplu, în ZNE presupunem că eroarea poate fi dezvoltată într-un parametru :
și că eroarea poate fi scalată eficient pentru a modela această dezvoltare. PEC ar anula chiar eroarea pe care ne bazăm pentru scalare. Parametrul ar deveni lipsit de sens. Un alt mod de a privi lucrurile este:
-
Aplicarea ZNE înainte de PEC schimbă canalul de zgomot pe care încerci să îl inversezi.
-
Aplicarea PEC înainte de ZNE elimină chiar zgomotul pe care se bazează ZNE pentru extrapolare.
PEC și ZNE ar trebui considerate paradigme alternative de atenuare a erorilor, nu straturi componibile. Compararea lor una lângă alta este instructivă, în timp ce combinarea lor nu este.
PEC și Pauli twirling sunt în general compatibile și adesea benefice. Twirling-ul poate ajuta PEC prin faptul că transformă erorile coerente în erori Pauli stocastice. Acest lucru simplifică canalul de zgomot, făcându-l mai ușor de reprezentat și de inversat. Pentru PEC, acest lucru este extrem de valoros, din următoarele motive:
-
Descompunerile cvasi-probabilistice sunt mult mai simple pentru canalele Pauli
-
Norma cvasi-probabilistică este adesea semnificativ mai mică
-
Varianța eșantionării este redusă
Multe demonstrații PEC presupun sau încorporează zgomot cu Pauli twirling. Este important de clarificat că Pauli twirling nu atenuează erorile de la sine; el remodelează zgomotul într-o formă pe care anularea probabilistică a erorilor o poate gestiona mai eficient.
PEC poate și ar trebui combinat cu TREX. Aceste abordări sunt complet compatibile și joacă roluri ortogonale. TREX acționează doar la măsurare, elimină părtinirea de citire prin twirl-uri randomizate ale canalului de măsurare și nu afectează zgomotul porților sau dinamica circuitului. PEC acționează asupra zgomotului porților. Deoarece eroarea de măsurare este aditivă, nu compozițională, ea este independentă de secvențele de porți. Este sigur și adesea de dorit să aplici TREX împreună cu PEC.
Ordinea acestor metode este cea la care te-ai putea aștepta:
- Execută circuitul randomizat PEC
- Aplică TREX pentru a atenua eroarea de citire
- Aplică ponderarea PEC și medierea
PEC și DD sunt în general incompatibile, cu excepția cazului în care caracterizarea zgomotului folosită pentru PEC este efectuată cu DD activ. PEC presupune că este staționar, repetabil și caracterizabil cu precizie. DD remodelează explicit canalul de zgomot în timp, modulând interacțiunile sistem-mediu și introducând efecte netriviale de sincronizare a impulsurilor. Ca urmare, zgomotul efectiv cu DD nu este același canal ca fără DD. Acest lucru este complicat și mai mult de faptul că canalul de zgomot poate depinde sensibil de programarea circuitului. Rezultatul final este că inversarea zgomotului devine rău definită sau invalidă.
Din punct de vedere teoretic este posibil să se caracterizeze zgomotul cu DD activ și să se construiască în consecință un model PEC, dar aceasta este o abordare foarte avansată și nu este în prezent un flux de lucru recomandat.
Aplicarea PEC manual
PEC este complex și nu se recomandă să îl implementezi manual. Totuși, vrem să parcurgem matematica unei aplicații de bază pe un singur qubit pentru a înțelege ce pași implică procesul. Alegem o stare mixtă, dar netrivială, pentru a vedea clar efectele numerice.
Luăm un qubit care ar trebui să fie în starea pură
Matricea densitate ideală este:
Am ales această matrice densitate deoarece nu este diagonală și este doar pentru un singur qubit, astfel încât să poată fi examinată „manual".
Aplicăm acum un model de zgomot foarte simplu, dar realist: un canal depolarizant pe un singur qubit, cu o intensitate mică .
Pentru a păstra calculele simple, luăm . Acest canal este complet pozitiv și păstrează urma (CPTP), așa cum trebuie să fie. Este un canal de zgomot realist pentru hardware real, sau cel puțin realist pentru a descrie o parte din zgomot. Mai mult, acest canal de zgomot este inversabil analitic, ca aplicație liniară. Cu alte cuvinte, există o matrice inversă, dar asta nu înseamnă că matricea corespunde unui canal fizic CPTP și cu siguranță nu corespunde unei unitare care ar putea fi implementată pe hardware.
Aplicăm acum canalul nostru de zgomot depolarizant matricei densitate a unui singur qubit și obținem:
Cu : și .
So:
Aplicând aceasta stării noastre:
Calculăm explicit:
Aceasta este în continuare o matrice densitate fizică și are în continuare urma egală cu unu — dar acum este mai mixtă.
Calculăm acum canalul invers ideal, fiind însă foarte pregătiți pentru posibilitatea ca acesta să nu fie fizic. Vom verifica dacă este. Matematic, aplicația liniară inversă este:
Dacă această acțiune inversă ar fi ea însăși un canal fizic valid, am fi tentați să încercăm să o implementăm exact. Desigur, ar trebui totuși să ne dăm seama cum să o implementăm folosind operații unitare și pași clasici, dar implementarea ei ar fi scopul. Totuși, se dovedește că aceasta nu este CPTP și, în general, nu există nicio garanție că astfel de aplicații inverse vor fi CPTP. Acest lucru este esențial pentru discuția noastră, deoarece este motivul pentru care există PEC.
Poți vedea că nu este CPTP chiar și numai privind-o. O verificare sigură este să o aplici unei matrice densitate și să vezi dacă returnează rezultate fizice. Aceasta este lăsată ca exercițiu pentru a-ți verifica înțelegerea.
Verifică-ți înțelegerea
Verifică dacă aplicația inversă de mai sus este CPTP aplicând-o unei noi matrice densitate:
Interpretează rezultatele ca fiind fizice sau nefizice.
Răspuns
Ca matrice densitate fizică, aceasta corespunde unei probabilități clasice mai mari decât 1 ca sistemul să se afle în starea și unei probabilități negative de a se afla în starea . Evident, această aplicație poate produce matrice densitate absurde. Mai mult, prin inspecție putem vedea că valorile proprii ale matricei densitate rezultate sunt 1.0625 și -0.0625, ceea ce înseamnă că nu toate valorile proprii sunt pozitive. Așadar, aplicația nu este „complet pozitivă", adică „CP" din CPTP.
Verifică-ți înțelegerea
Verifică prin calcul explicit că operația inversă de mai sus anulează canalul de zgomot și returnează starea fără zgomot.
Răspuns
Aplic-o stării zgomotoase:
Aceasta este exact starea inițială (până la rotunjire).
Reformulăm pentru a fi absolut clari: nu putem inversa exact canalul de zgomot; inversul nu este CPTP și nici nu este un canal fizic valid. Totuși, putem inversa eficient canalul ca o combinație liniară de canale fizice.
Pentru canalul depolarizant:
unde: etc.
Inversul poate fi scris ca:
with:
-
= canale Clifford implementabile fizic
-
= cvasi-probabilități
-
Some
Aceasta este ideea de bază din spatele PEC:
-
Eșantionează canalele conform ∣
-
Atașează semne rezultatelor măsurătorilor
-
Valorile de așteptare converg către valoarea fără zgomot
Aplicăm PEC „manual" la estimarea lui folosind matricea densitate și vedem dacă putem recupera rezultatele pentru . Pentru ne așteptăm la:
Observă, de asemenea, că pentru matricea densitate zgomotoasă obținem:
Este ordinul de mărime corect, dar semnificativ departe de cazul ideal.
Parcurgem acum pas cu pas cum, cu procesul PEC, putem reconstrui valoarea de așteptare nepărtinitoare din matricea densitate zgomotoasă. În fluxurile de lucru reale, acest proces este probabilistic și va fi automatizat. În acest flux de lucru „manual", vom alege valori probabilistice realiste, dar poate convenabile pentru prezentarea noastră. Acest lucru nu trebuie interpretat ca o afirmație că PEC este perfect. Este doar pentru a-ți arăta un scenariu plauzibil care s-ar putea întâmpla în interiorul pachetelor PEC.
Reamintește-ți că canalul nostru de zgomot are forma:
Inversul poate fi scris (exact):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Pentru această introducere este mai simplu să ne concentrăm asupra efectului canalului asupra matricei noastre densitate. Acest lucru ne permite să lucrăm cu obiecte familiare precum matricele densitate și valorile de așteptare. În acest scop, să luăm în considerare ce trebuie să fie adevărat despre efectele acestei operații inverse asupra procesului nostru de estimare: estimatorul produs de PEC trebuie să fie normalizat și nepărtinitor. Aceasta corespunde a două condiții:
-
Normalizare: Pentru a ne asigura că această operație nu schimbă scara observabilei, cerem ca . Pentru a vedea de ce este așa, putem fie să considerăm acțiunea inversului asupra unei matrice densitate, fie să considerăm acțiunea sa asupra valorii de așteptare a ceva trivial precum însuși.
-
Calibrare: Într-un flux de lucru real, folosim circuite de calibrare pentru a învăța comportamentul zgomotului la nivel de poartă. Apoi folosim cunoștințele despre comportamentul zgomotului la nivel de poartă și liniaritatea valorilor de așteptare pentru a aplica modelul de zgomot învățat circuitului mai mare. În cazul nostru, am pornit de la cunoștința artificială că valoarea de așteptare ideală este . Dar ar fi foarte ușor să găsim o stare pentru care știm teoretic că aceasta ar fi valoarea ideală, apoi să folosim măsurători reale pentru calibrare. Un punct esențial este că, pentru PEC, de obicei nu se învață un model complet de zgomot al întregului circuit. În schimb, se învață modele locale de zgomot pentru porți individuale sau straturi ale circuitului și acestea se folosesc pentru a construi descompunerea cvasi-probabilistică.
Folosim aceste condiții pentru a determina și . Luăm în considerare ansatz-ul
and apply it to an arbitrary single-qubit density matrix .
Reamintește-ți că canalele Pauli acționează prin conjugare:
Aplicând lui obținem:
Luând urma, obținem:
Fiecare operator Pauli este unitar, astfel încât conjugarea păstrează urma:
Therefore,
Pentru ca estimatorul PEC să fie normalizat, aplicația inversă efectivă trebuie să păstreze urma tuturor matricelor densitate. Adică, cerem:
Aceasta implică constrângerea de normalizare:
Dar în cazul nostru, aceasta conduce la condiția:
Acum folosim informațiile de calibrare pentru a pune în relație valoarea de așteptare observată cu cea ideală cunoscută.
Or equivalently,
Rezolvând cele două condiții ale noastre pentru și , obținem:
Acești coeficienți însumează 1, dar unul dintre ei este negativ.
Putem recupera valoarea de așteptare ideală modificând aleatoriu circuitul, măsurând, înmulțind rezultatul cu o pondere cu semn și făcând media. În special, nu se reconstruiește nicio matrice densitate și nu se implementează fizic niciun canal invers.
Pasul cheie: acesta este PEC
Pentru intensitatea noastră de zgomot , canalul invers poate fi scris ca:
Fapte importante:
-
Coeficienții însumează 1
-
Un coeficient este negativ
-
Fiecare termen este implementabil fizic
-
Negativitatea se mută în post-procesarea clasică
Formăm o distribuție de eșantionare din valorile absolute ale ponderilor:
(pentru fiecare dintre X, Y, Z)
Ponderea totală:
Pentru probabilitățile de eșantionare, împarte la W.
| Operație | Probabilitate | Semn |
|---|---|---|
| Nu face nimic () | 1.1875 / 1.375 ≈ 0.864 | + |
| Aplică X | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplică Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplică Z | 0.0625 / 1.375 ≈ 0.045 | - |
Semnul provine din coeficientul original, nu din probabilitate.
Fiecare shot constă din acești pași:
-
Pregătește starea
-
Lasă hardware-ul să aplice circuitul zgomotos
-
Alege aleatoriu o operație din tabelul de mai sus folosind probabilitățile asociate
-
Apply it
-
Măsoară , obținând
-
Înmulțește rezultatul cu
-
Înregistrează acel număr
Parcurgem acum exemple pentru mai multe shot-uri.
Shot 1 (cazul identitate)
Presupunem că operația aleasă aleatoriu este identitatea (sau echivalent: nu face nimic). Pe baza argumentelor și a tabelului de mai sus, acest lucru se va întâmpla în 86.4% din cazuri. Deoarece coeficientul lui în inversul canalului de zgomot este pozitiv, alegem semnul . Măsurarea lui Z ar putea da cu ușurință oricare dintre . Să presupunem că dă .
Contribuția corectată PEC a acestui shot ar fi:
Shot 2 (din nou identitate)
Presupunem că obținem din nou ca operație aleatorie (deci semnul termenului este inițial tot ), dar de data aceasta măsurarea lui Z dă . De data aceasta contribuția este:
Shot 3 (X ales)
De data aceasta operația aleatorie este X. Acest termen din invers este negativ, deci păstrăm semnul . Aplicăm X și apoi măsurăm Z. Din nou, am putea obține oricare dintre valorile proprii; să spunem că obținem . Contribuția acestui termen este:
Shot 4 (Z ales)
Operația aleatorie este Z. Aceasta ne dă semnul din tabel. Presupunem că măsurăm Z și obținem . Contribuția este:
Shot 5 (Y ales)
Operația aleatorie este Y. Aceasta ne dă semnul din tabel. Presupunem că măsurăm Z și obținem . Contribuția este:
Medierea rezultatelor
Imaginează-ți că colectăm multe astfel de rezultate ponderate PEC:
Prin construcție, aplicăm identitatea în 86.4% din cazuri. Aplicăm fiecare dintre celelalte porți în 4.5% din cazuri. Într-un flux de lucru real, nu cunoaștem stările subiacente precise și nici întregul canal de zgomot. Dar cunoaștem factorul de ponderare de mai sus și probabilitatea relativă cu care aplicăm fiecare operație. Într-un flux de lucru real, ne bazăm pe matricea densitate necunoscută pentru a ne oferi rezultatele măsurătorilor. Vom verifica aici că această procedură ar produce rezultatele corecte.
Vrem să calculăm media tuturor măsurătorilor ponderate și cu semn, incluzând aplicările operatorilor Pauli înainte de măsurare. Notăm numărul total al tuturor shot-urilor cu . Notăm mulțimea tuturor shot-urilor pentru care a fost aplicat Pauli cu și folosim pentru a indexa aceste shot-uri. Notăm rezultatul măsurătorii celui de-al -lea shot sub aplicarea celui de-al -lea Pauli cu . Putem scrie această medie ca:
Operatorul Pauli este aplicat probabilistic cu probabilitatea . În limita unui număr mare de shot-uri,
Putem folosi aceasta pentru a scrie:
unde este valoarea de așteptare a lui Z doar pe ansamblul de shot-uri în care a fost aplicat . Acest lucru este util deoarece știm care trebuie să fie fiecare astfel de valoare de așteptare din matricea densitate. Din nou, într-un flux de lucru real, aceasta ar rezulta din măsurare, nu dintr-o matrice densitate cunoscută.
Verifică-ți înțelegerea
Verifică valorile de așteptare de mai sus prin calcul sau raționament logic.
Răspuns
Y și Z se desfășoară exact ca mai sus.
Acum putem rescrie valoarea medie globală astfel:
Dacă cunoaștem parametrii și ai zgomotului porții noastre (sau mai mulți parametri pentru canale de zgomot mai complexe), este suficient pentru a determina (1) factorul de pondere global și (2) probabilitățile cu care ar trebui să aplicăm operatorii Pauli. Rezultatul de mai sus arată că, dacă procedăm astfel, atenuăm zgomotul și recuperăm valori medii nedeplasate. Media tuturor acestor măsurători a convergit către , chiar dacă:
-
Măsurătorile individuale dau contribuții mai mari decât ±1
-
Unele măsurători au pondere statistică negativă
-
Fiecare operație cuantică a fost fizică
Prezentare generală a fluxului de lucru PEC
În PEC, toți pașii executați pe calculatorul cuantic sunt:
-
Învățarea zgomotului
-
Pregătirea stării pentru circuitul tău țintă
-
Aplicarea probabilistică a porților Pauli, așa cum este descris mai sus
-
Measurement
Inversa efectivă a hărții de zgomot este realizată statistic în post-procesarea clasică. Aceasta permite o inversare mai generală a canalelor de zgomot, care altfel ar fi necesitat pași nefizici, precum probabilități negative.
Prețul pe care îl plătim pentru aceasta este varianța. Fiecare măsurătoare avea anterior o „magnitudine” egală cu magnitudinile posibilelor rezultate ale măsurării . După scalarea cu factorul de pondere , are magnitudinea (1.375 în exemplul nostru de mai sus).
Aceasta este originea suprasarcinii de eșantionare a PEC.
PEC încorporat
Acum vom folosi PEC așa cum este integrat în primitivele IBM Quantum. Este esențial să distingem aici între PEC complet la nivel de poartă și un model local de învățare a zgomotului pentru un PEC mai scalabil, care este folosit de primitivele IBM Quantum. Suprasarcina utilizării PEC complet ne-ar limita aplicarea la circuite mici. Asta e în regulă, dar este mai util să avem un instrument care poate scala la o dimensiune la care calculul cuantic devine valoros pentru probleme din lumea reală. Din acest motiv, primitivele IBM Quantum folosesc un PEC pe straturi, cu un model de zgomot Pauli-Lindblad învățat, cu măsuri de siguranță agresive pentru scalabilitate. În această implementare a PEC, zgomotul este învățat pentru fiecare strat de circuit repetat, nu pentru fiecare instanță de poartă, iar modelul de zgomot este Pauli-twirled, local și markovian. Porțile Clifford sunt absorbite în modelul de zgomot, în timp ce porțile non-Clifford domină costul atenuării. Suprasarcina de eșantionare este plafonată pentru a evita explozii exponențiale.
Vom aplica PEC integrat în primitivele IBM Quantum la două scări: mică (șase qubiți) și medie (30 de qubiți), pentru a vedea cum este ținut sub control costul în această versiune a PEC. În cadrul fiecărui experiment de o anumită dimensiune, vom compara explicit și rezultatele PEC cu cele fără atenuare, cu ZNE și cu valoarea ideală.
Începem prin a importa câteva pachete necesare.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Alegem o observabilă de estimat. Observabila de mai jos este hamiltonianul unui lanț de spini de tip Ising, cu cuplaj doar între vecinii cei mai apropiați în componenta a interacțiunii lor și cu un termen cu un singur qubit în , ca și cum ar fi datorat unui câmp extern în .
Nu există un motiv special pentru alegerea acestui hamiltonian. Avem nevoie doar de o combinație de observabilă și circuit care să fie netrivială, astfel încât atenuarea erorilor să-și poată face treaba. Scalăm explicit hamiltonianul (folosind coeficienții), împărțind la numărul de qubiți, astfel încât energia să rămână de același ordin de mărime pe măsură ce creștem numărul de qubiți. Începem cu doar șase.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Ca și în cazul alegerii hamiltonianului, circuitul de pregătire a stării de mai jos nu este ales din motive fizice. Mai degrabă, este ales pentru a avea o adâncime suficientă cu doi qubiți și suficient de multe porți non-Clifford pentru ca PEC să fie util. Nu există niciun motiv să credem că acest circuit este o bună aproximare a stării fundamentale a acestui lanț de spini, de exemplu.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
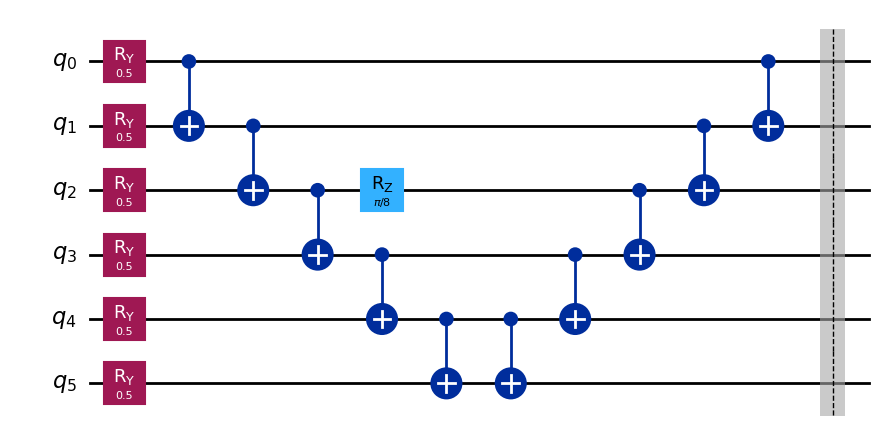
Transpilăm circuitul și aplicăm aranjamentul rezultat observabilelor noastre.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Obținem valoarea medie ideală folosind simulatorul Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Ne așteptăm ca celelalte valori ideale să aibă dimensiuni similare. Acum rulăm aceasta pe un calculator cuantic IBM real, fără atenuarea erorilor.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Acum aplicăm ZNE aceleiași probleme.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
În final, aplicăm PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Mai jos reprezentăm grafic rezultatele și le comparăm.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
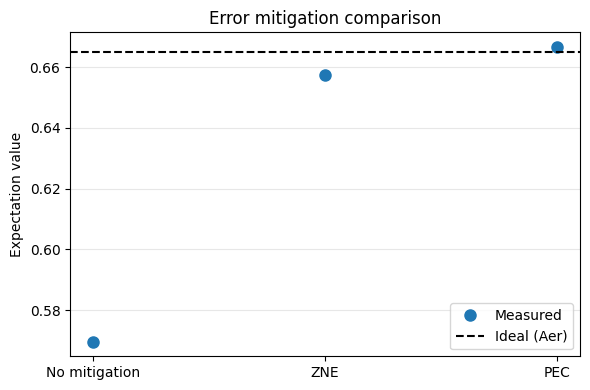
Aceasta a funcționat foarte bine. Estimarea noastră cu PEC este la doar 0.2% de valoarea ideală.
Dar amintește-ți cum crește exponențial suprasarcina cuantică. Am impus o suprasarcină maximă de max_overhead = 100. Judecând după timp și după calitatea rezultatelor, se pare că este posibil să nu fi atins acest maxim. Totuși, dacă scalăm calculul și păstrăm acest maxim, îl vom atinge, iar rezultatele noastre vor avea de suferit.
Putem vedea ce se întâmplă când scalăm circuitul la 30 de qubiți. Interesant este că, pe multe laptopuri, simulatorul Statevector va începe să expire în jurul a 24-28 de qubiți. Am putea găsi căi computaționale de a ocoli asta. Dar, în schimb, să acceptăm faptul că calculatoarele cuantice vor putea rezolva unele probleme la o scară la care calculatoarele clasice nu pot ține pasul. Acesta este scopul. Ce putem face atunci pentru a valida rezultatele calculului nostru cuantic în aceste cazuri? Există mai multe răspunsuri posibile:
- Unele probleme sunt greu de rezolvat, dar ușor de verificat (precum factorizarea în numere prime din algoritmul lui Shor).
- Unele probleme au regimuri de parametri sau variante care se simplifică și pot fi rezolvate clasic, sau chiar analitic, pentru a compara câteva puncte. În acest caz, am ales un hamiltonian intrinsec (am împărțit la numărul de qubiți). Valoarea medie ideală ar trebui să fie destul de stabilă. Să vedem cum variază valoarea medie ideală cu numărul de qubiți și dacă putem face predicții clasice despre valoarea la 30 de qubiți.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Într-adevăr, vedem că am ales un hamiltonian și o stare care nu se schimbă odată cu numărul de qubiți. Aceasta este o utilizare foarte slabă pentru o aplicație de cercetare a calculului cuantic, dar una excelentă pentru evaluarea comparativă a tehnicilor de atenuare a erorilor. Putem folosi cu încredere această valoare medie fixă ca rezultat ideal, chiar și pe măsură ce creștem numărul de qubiți pentru testarea atenuării erorilor.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Acum rulăm acest circuit mai mare cu ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
În final, rulăm exemplul cu 30 de qubiți cu PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
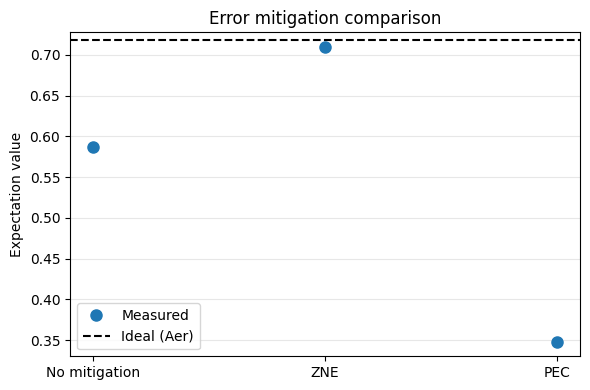
PEC nu a durat doar mult mai mult decât celelalte opțiuni, ci am atins clar pragul nostru maxim de suprasarcină. Rezultatele PEC au plătit prețul suprasarcinii, dar plafonul suprasarcinii a împiedicat anularea suficient de precisă a modelului de zgomot învățat. Acest lucru este esențial. La șase qubiți, am putut folosi PEC și am obținut rezultate mai bune cu o creștere modestă a suprasarcinii cuantice (aproximativ un factor de 5). La 30 de qubiți, am plătit un preț mult mai mare (de aproximativ 60 de ori mai mare), iar rezultatele au fost chiar mai slabe decât estimarea neatenuată. Aceasta nu înseamnă că PEC nu poate funcționa niciodată cu 30 de qubiți; poate depinde de circuit. Mesajul este pur și simplu că creșterea exponențială a suprasarcinii cuantice face dificilă rularea pentru circuite mari.
Concluzii principale:
-
Atenuarea măsurării ajută adesea și de obicei are o suprasarcină mică: elimină o deplasare care nu scalează cu adâncimea circuitului și se combină curat cu aproape orice.
-
Unele tehnici nu pot fi combinate. Chiar și atunci când pot, asigură-te că le combini într-un mod consecvent, astfel încât una să nu o anuleze pe cealaltă. Un bun exemplu este să te asiguri că twirling-ul este activat în timpul calibrării pentru M3, dacă aceste metode urmează să fie combinate.
-
PEC și ZNE ar trebui privite ca alternative una pentru cealaltă. Ele rezolvă aceeași problemă cu compromisuri opuse:
-
PEC: produce valori medii nedeplasate, cu prețul unei varianțe exponențiale.
-
ZNE produce în general o deplasare reziduală care depinde de modelul de extrapolare, dar la un cost moderat.
-
-
DD poate ajuta la perioade lungi de inactivitate, dar remodelează modelul de zgomot și poate invalida ipotezele de extrapolare sau de inversare.
-
Pauli twirling nu reduce zgomotul. Îl remodelează și adesea permite altor tehnici să funcționeze mai bine (ZNE și PEC).