Suprimarea și modelarea erorilor
Suprimarea erorilor se poate referi la orice tehnică ce anticipează și încearcă să evite anumite tipuri de zgomot și erori. Acest lucru este cel mai ușor de explicat prin exemple concrete, dar ține minte că aceste metode nu se limitează la exemplele prezentate aici, și metode noi sunt explorate continuu. Uneori nu este posibil să suprimi erorile, dar este posibil să influențezi modul în care se acumulează. Dacă putem face ca erorile să se acumuleze mai lent, am putea descrie acest lucru ca suprimare a erorii globale, dar este mai corect privit ca modelare a zgomotului. În această lecție acoperim exemple canonice de suprimare a erorilor (decuplare dinamică) și de modelare/formare a zgomotului (Pauli twirling).
Un videoclip care va însoți această lecție va fi lansat în următoarele zile și va fi încorporat aici.
Decuplare dinamică
Să începem cu o stare foarte simplă pe un singur qubit și să introducem un model simplu de zgomot. Acest lucru nu este suficient pentru a explica complet decuplarea dinamică, dar ne oferă un exemplu clar. Să presupunem că avem un qubit pregătit într-o stare de suprapunere folosind o poartă Hadamard:
Această stare este vizualizată pe sfera Bloch, așa cum se arată mai jos, în stânga. În cazul ideal, fără zgomot, acest qubit ar rămâne în această stare până la efectuarea următoarei operații. Totuși, știm din lecția anterioară că nu aceasta este ceea ce observăm. Zgomotul face ca informația cuantică să se degradeze.
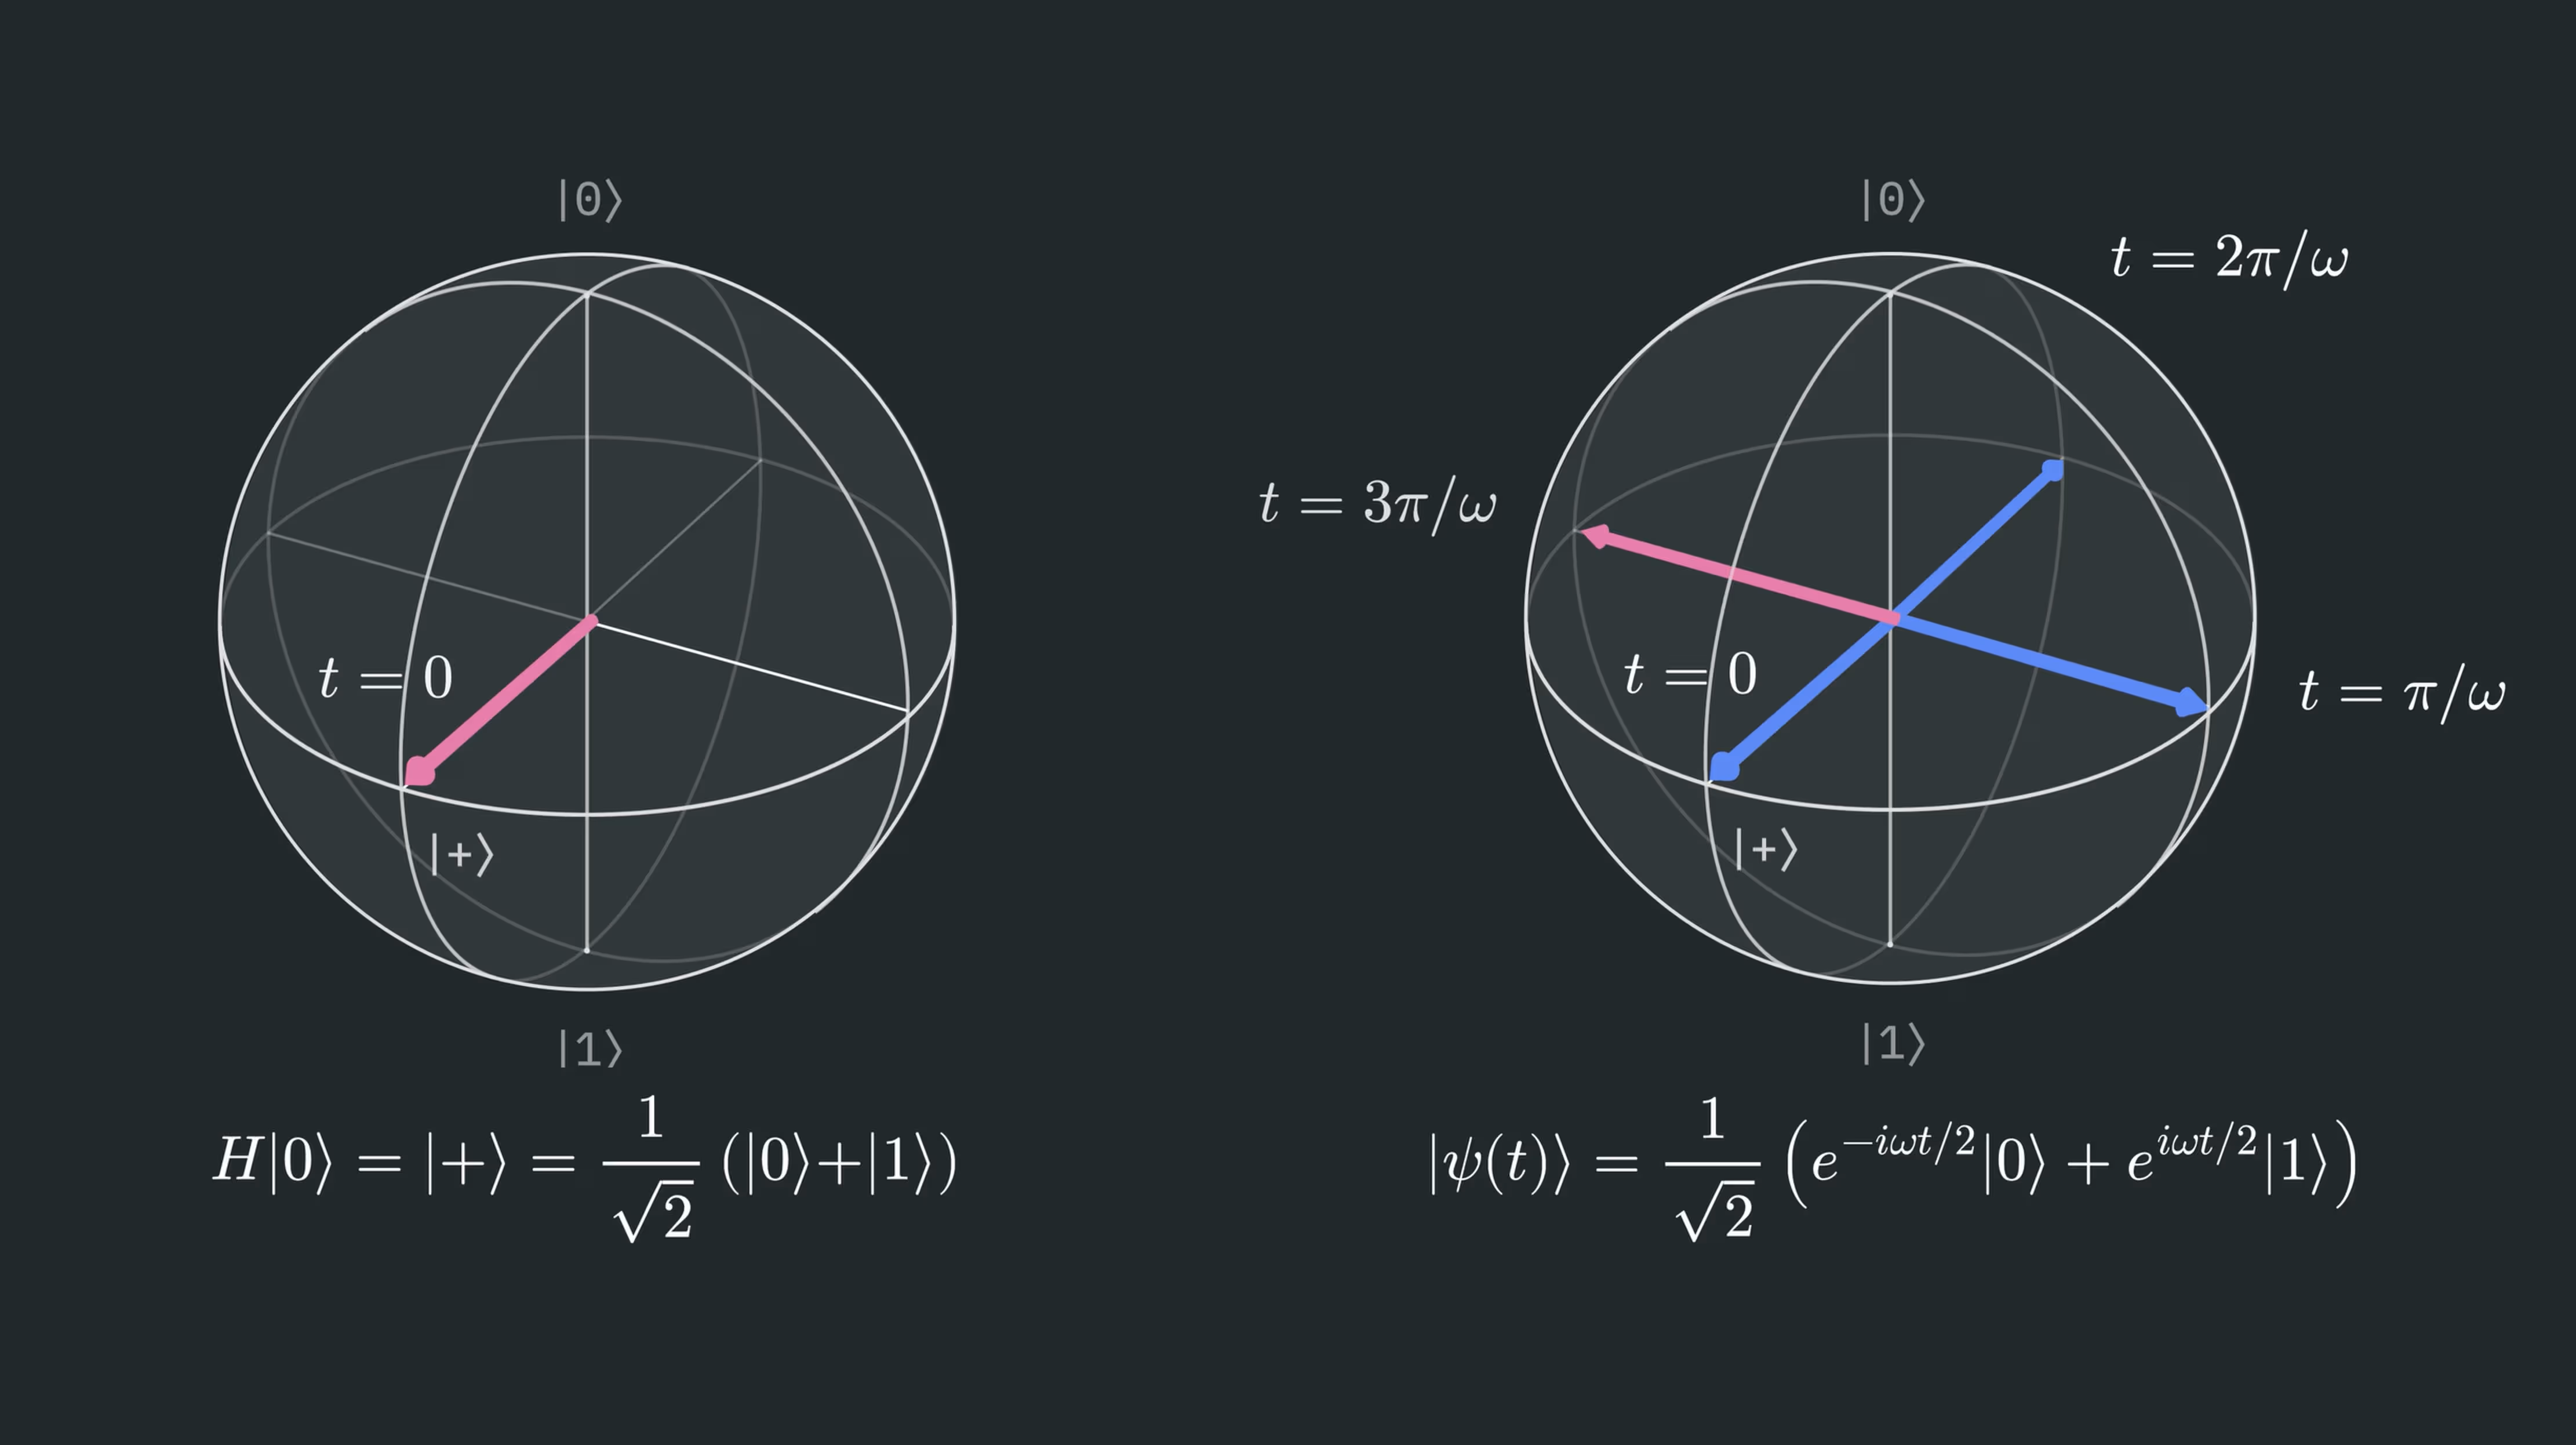
Zgomotul sau cuplarea cu mediul pot face ca faza relativă dintre stările de bază să se schimbe. Adică, probabilitățile lui și nu se schimbă, deoarece valorile absolute ale coeficienților lor nu se schimbă. În schimb, fazele amplitudinilor se schimbă, modificându-le componentele reale și imaginare. Pentru a face această discuție mai concretă, să considerăm un tip de interacțiune care poate cauza acest lucru: cuplarea cu un câmp magnetic orientat în direcția Z: .
Să considerăm ce se întâmplă cu starea pe măsură ce trece timpul:
Aici am folosit faptul că un câmp magnetic în direcția Z provoacă o precesie în jurul axei Z cu o frecvență care depinde de momentul magnetic efectiv și de intensitatea câmpului magnetic. Detaliile sunt mai puțin importante decât faptul că această interacțiune determină o evoluție în jurul axei Z, rezultând într-o acumulare de fază opusă pentru cele două stări de bază computaționale. Aplicând acest operator fiecărui termen din , obținem următoarele:
Această fază dependentă de timp corespunde precesiei în jurul axei Z în reprezentarea sferei Bloch. Acest lucru este arătat în jumătatea dreaptă a figurii de mai sus.
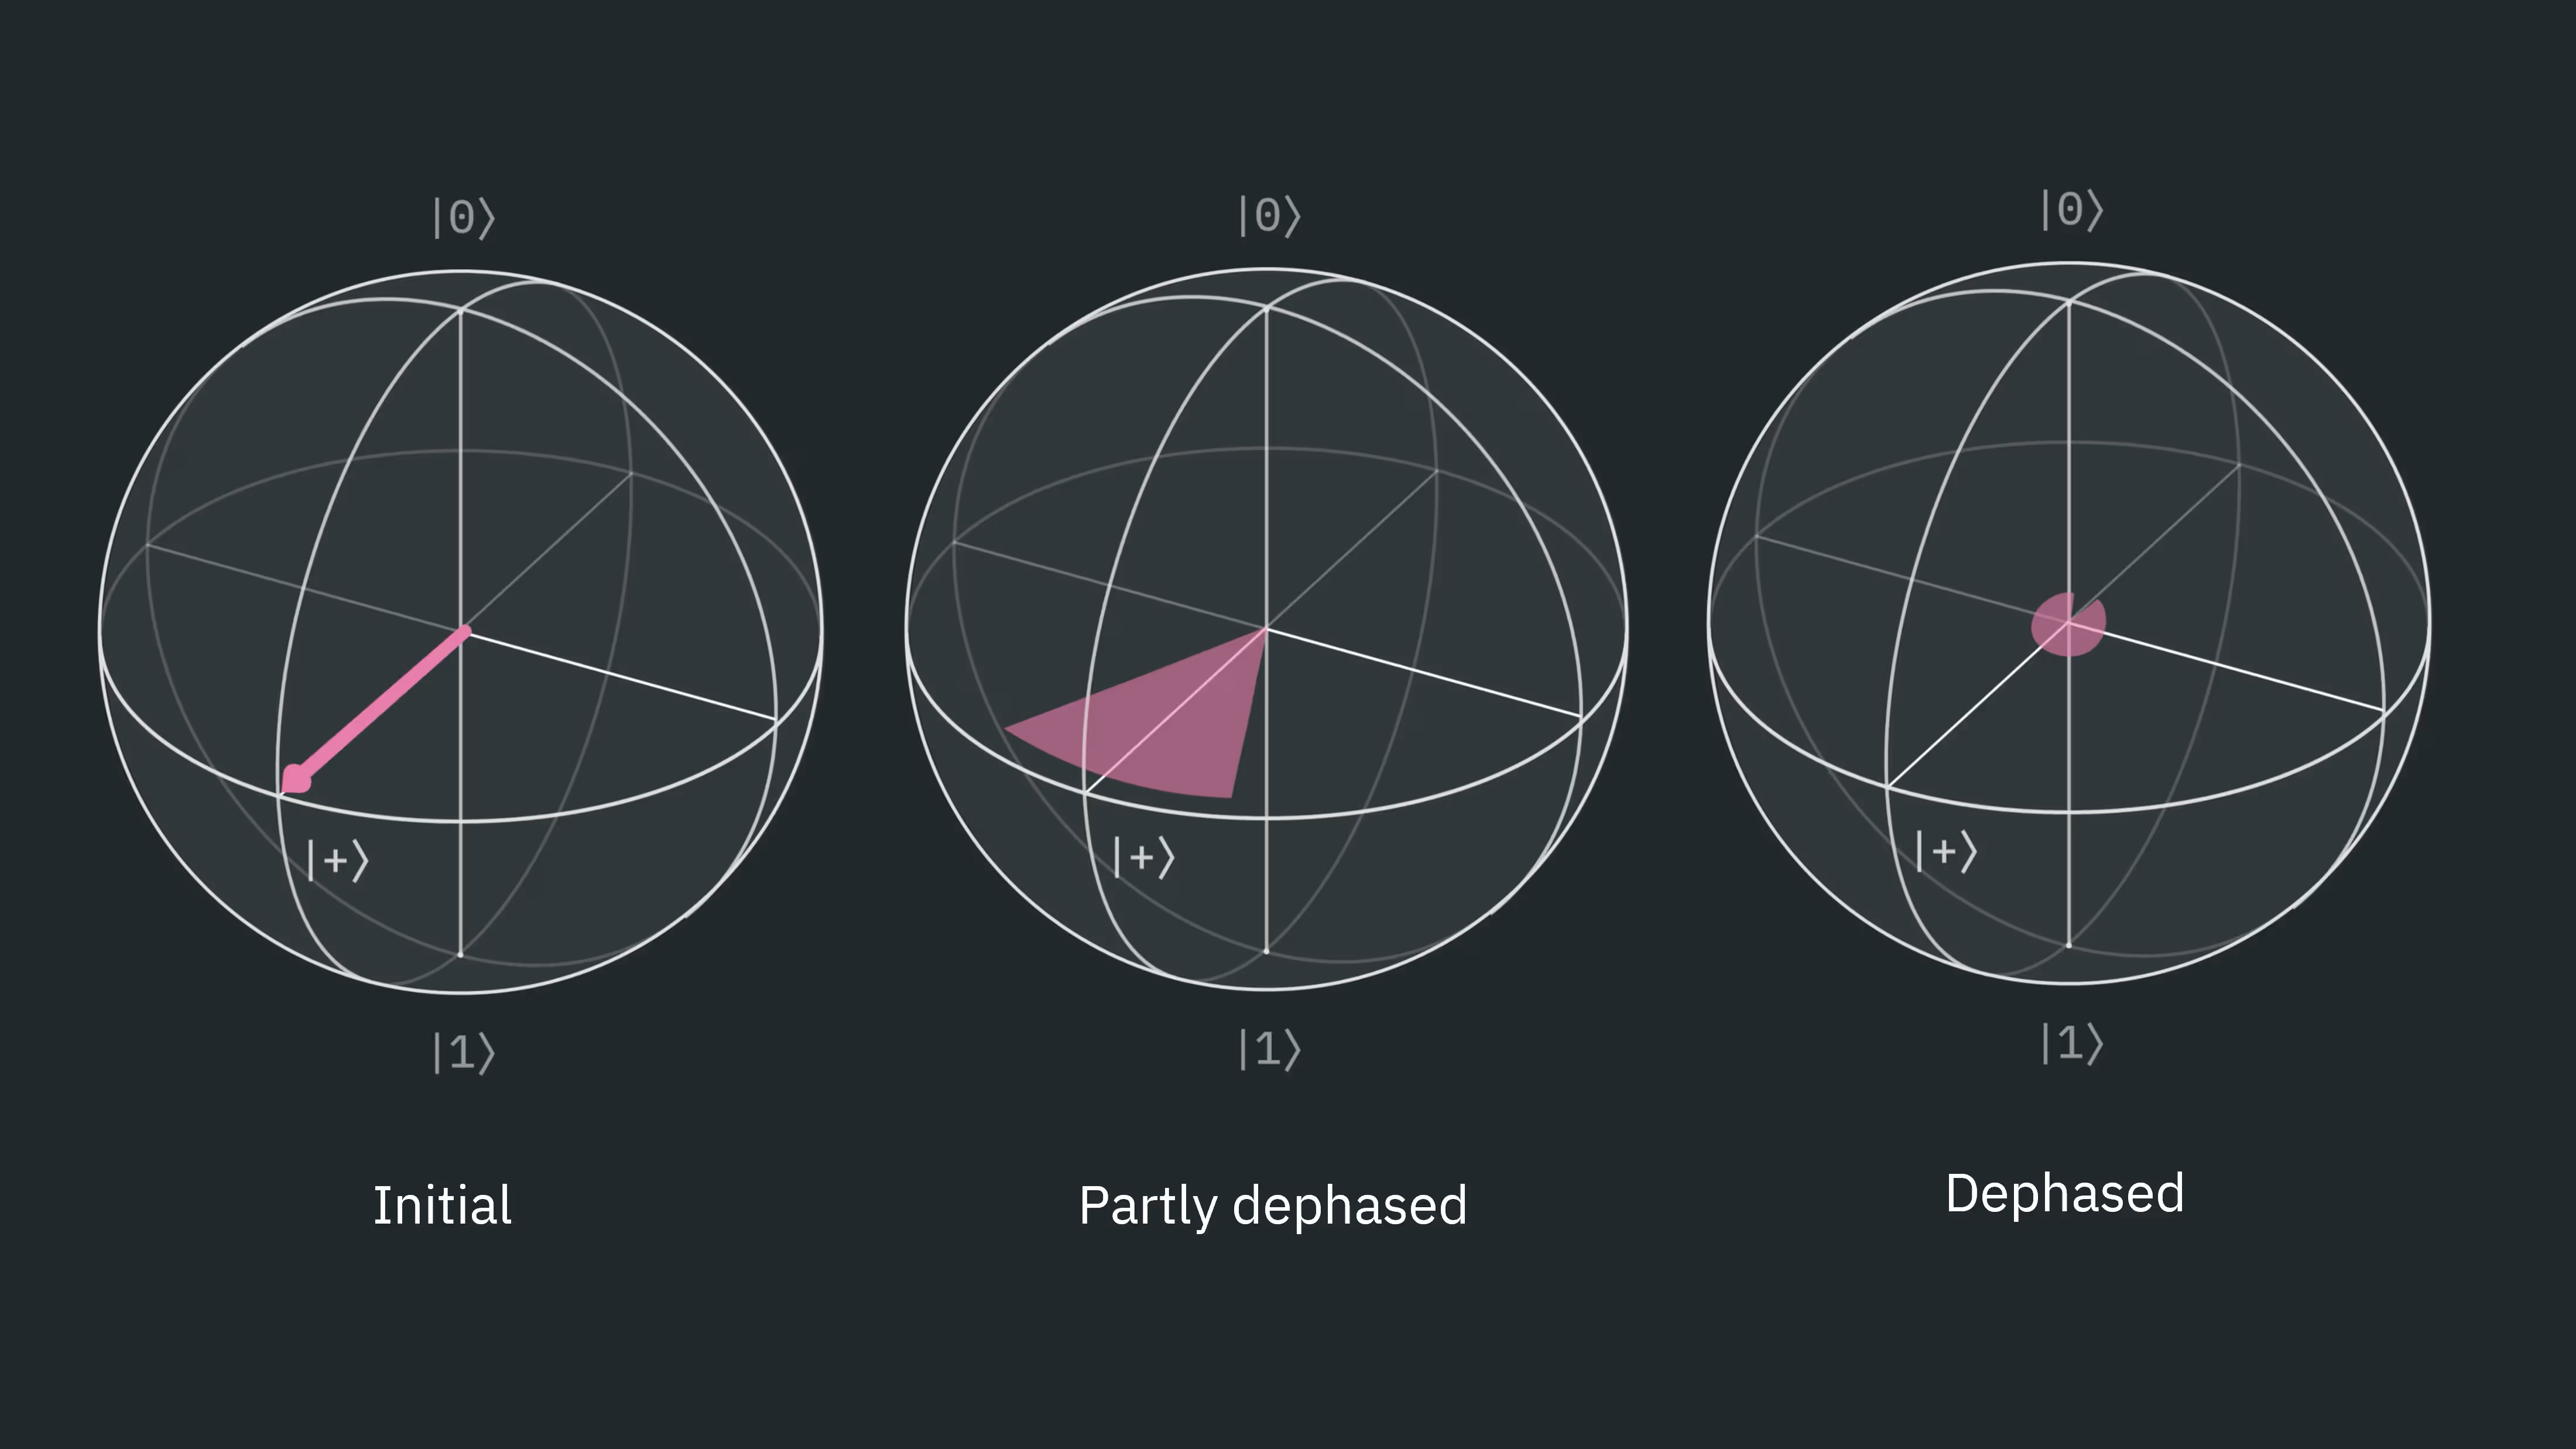
Dacă am ști că această interacțiune are loc într-un mod controlat, am putea-o prezice. Pentru a modela acest tip de zgomot, considerăm în schimb o distribuție de posibile intensități ale câmpului magnetic, fiecare apărând cu o anumită probabilitate clasică (alte surse de zgomot ar trebui modelate diferit). Trebuie să luăm în considerare ce se întâmplă atunci când există o probabilitate clasică nenulă ca starea să nu se fi rotit deloc, și de asemenea o anumită probabilitate ca ea să se fi rotit cu o cantitate mică, sau chiar cu o cantitate mare. Această distribuție a rotațiilor posibile este motivul pentru care starea se extinde în reprezentarea sferei Bloch de mai jos. Dacă există mai mult zgomot de defazare de acest tip, faza va fi mai puțin bine definită. În limita unei defazări puternice, qubitul devine complet defazat, ceea ce corespunde pierderii coerenței cuantice stocate în stare.
Desigur, într-un experiment nu avem nicio idee ce cuplare aleatorie va avea loc. Ce putem face în privința asta?
Să presupunem că cuplarea cu mediul rămâne aproximativ constantă pe un interval de timp . Să considerăm ce s-ar întâmpla dacă am urma această prescripție:
-
Lasă faza să se schimbe pentru un timp
-
Aplică o poartă X qubitului
-
Lasă aceeași cuplare cu mediul să aibă loc pentru un timp suplimentar
-
Aplică o a doua poartă X
După evoluția inițială în timp, am avea exact starea de mai sus. Aplicând prima poartă X avem:
Acum, când trece al doilea interval de , are loc aceeași interacțiune. Dar acum amplitudinile sunt asociate cu stările proprii Z opuse, ceea ce înseamnă că semnul rotației în jurul axei Z s-a schimbat. După ce lăsăm sistemul să evolueze în timp pentru încă un , avem starea:
Și înlocuind avem:
Aplicarea porții X finale nu face nimic în acest caz, dar este în general necesară:
Am recuperat starea cuantică originală, inclusiv faza sa relativă. Acest proces este un exemplu deosebit de simplu de decuplare dinamică.
Mai general, decuplarea dinamică (DD) presupune inserarea unor porți pe un singur qubit pentru a reduce efectul interacțiunilor cu sisteme din afara qubitului (decuplându-l de mediu). Refocalizarea completă a tuturor istoriilor posibile de fază înapoi la starea originală, așa cum s-a arătat mai sus, este oarecum idealizată, dar rămâne un scenariu posibil. Să discutăm când este util DD și ce precauții există.
Verifică-ți înțelegerea
În textul de mai sus, am parcurs efectul unei secvențe DD XX asupra stării inițiale . Verifică dacă aceiași pași de mai sus readuc și starea la starea sa inițială, în aceleași ipoteze ale unui câmp magnetic care variază lent de-a lungul direcției z.
Răspuns
După evoluția inițială în timp, am avea exact starea de mai sus. Aplicând prima poartă X avem:
Acum, când trece al doilea interval de , are loc aceeași interacțiune. Dar acum amplitudinile sunt asociate cu stările proprii Z opuse, ceea ce înseamnă că semnul rotației în jurul axei Z s-a schimbat. După ce lăsăm sistemul să evolueze în timp pentru încă un , avem starea:
Și înlocuind avem
Aplicând poarta X finală, avem:
Când să folosești DD
Prima și cea mai evidentă precauție este că am presupus un canal de defazare pură în tratamentul nostru. Interacțiunile din lumea reală produc de obicei un amestec de defazare și alte mecanisme de eroare. În tratamentul de mai sus, am ales să aplicăm porți X în mod specific. Aceasta este numită o secvență XX în decuplarea dinamică. Această secvență particulară este potrivită pentru erori de defazare pură. Dar există alte secvențe care ar putea fi mai larg aplicabile, precum XY4 (arătată în diagrama de circuit de mai jos) și XY8, mai complexă.

O altă precauție este că decuplarea dinamică adaugă porți pe un singur qubit, care pot adăuga erori de un singur qubit din cauza imperfecțiunilor porții sau chiar a crosstalk-ului. Aceste rate de eroare pe un singur qubit sunt de obicei mult mai mici decât erorile porților multi-qubit, deci de obicei nu reprezintă o preocupare majoră, dar este ceva de ținut minte dacă mulți qubiți folosesc DD de multe ori de-a lungul circuitului tău.
DD este util atunci când cuplarea externă are timp să afecteze starea qubitului. Deoarece qubiții sunt izolați cu multă grijă, iar cuplările externe ar trebui să fie slabe, acest tip de zgomot este cel mai vizibil atunci când un qubit rămâne inactiv perioade lungi de timp. Pentru timpi de inactivitate scurți, efectul DD ar putea fi acela de a adăuga erori de porți pe un singur qubit, suprimând foarte puțin zgomot; fidelitatea circuitului tău ar putea fi de fapt redusă.
Concluzie cheie: Folosește decuplarea dinamică atunci când qubiții rămân inactivi perioade suficient de lungi și acordă atenție tipului de secvență DD folosită.
Decuplare dinamică folosind Qiskit
Să explorăm utilizarea DD examinând cazul mai multor qubiți pregătiți în starea , care apoi rămân inactivi mult timp. În absența erorilor, pregătirea stării multi-qubit și apoi aplicarea unei porți Hadamard înainte de măsurare (măsurând astfel în baza X) ar trebui să dea întotdeauna 0. Cu zgomot, rezultatul măsurătorii va fi 0 doar o fracțiune din timp, nu cu o probabilitate de 100%. Calculăm valoarea medie de așteptare X pentru mai mulți qubiți. Adică, suntem interesați de următoarele:
unde cu operatorul X în poziția din dreapta, iar este starea întregului sistem.
Acest circuit conține întârzieri intenționate, ceea ce este oarecum artificial pentru un benchmark. Totuși, este foarte obișnuit ca circuitele reale să conțină qubiți care rămân inactivi în timpul unei părți a execuției. Poți considera acest lucru un model simplificat al unui circuit mai complex în care unii qubiți rămân inactivi pentru o parte a calculului. Acest tip de testare bazat pe evoluția stărilor este adesea numit testare Ramsey.
Începem prin a încărca pachetele necesare și a configura serviciul.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Acum definim câteva funcții ajutătoare. Mai întâi, vrem să abordăm ideea despre timpii lungi de inactivitate. Ce înseamnă exact "lung" în acest context? Am putea pur și simplu raporta timpul de inactivitate în microsecunde. Totuși, este util să știm câte porți pe doi qubiți ar putea fi executate în același interval. Acest lucru face ca timpii de inactivitate să fie mai direct indicativi ai adâncimii de circuit care ar fi putut fi executată în aceeași perioadă. Prima funcție ajutătoare obține poarta nativă pe doi qubiți a backend-ului și determină durata acelei porți.
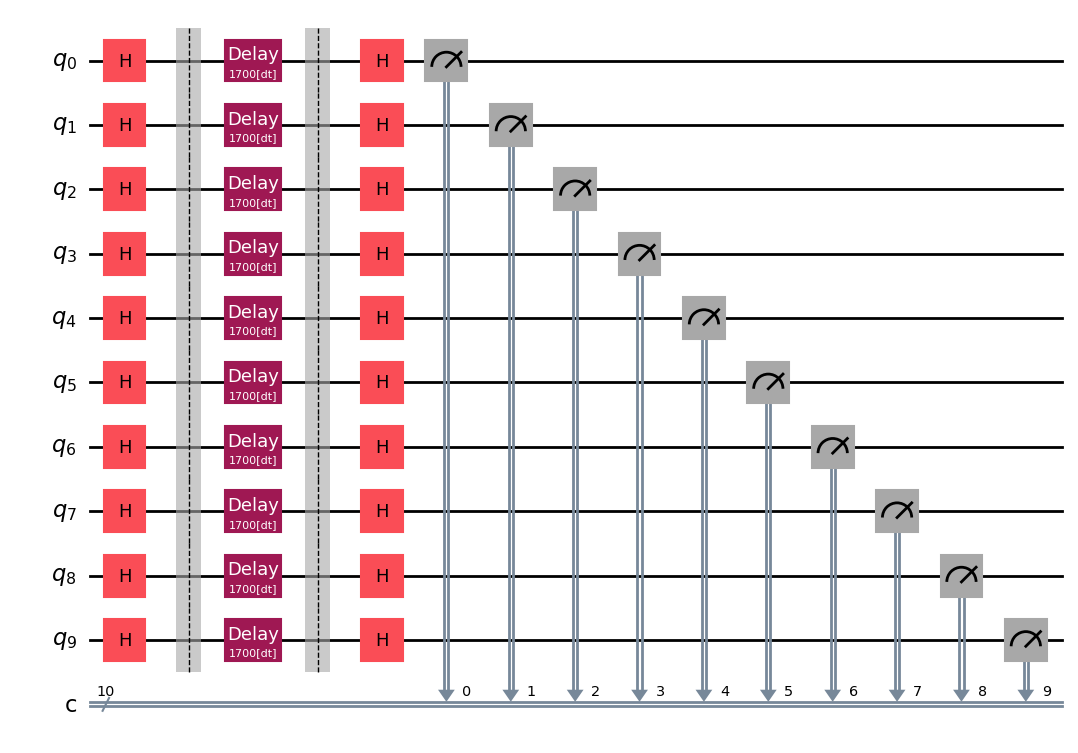
A doua funcție creează pur și simplu un circuit Ramsey (unul cu qubiții în starea ), implementează o întârziere, rotește folosind o poartă H, și apoi măsoară. Amintește-ți că o poartă Hadamard (H) mapează la , astfel încât măsurarea lui în baza Z după Hadamard corespunde faptului că qubitul a fost în chiar înainte de Hadamard.
Funcția noastră finală convertește numărătorile brute ale rezultatelor măsurătorilor de 0 și 1 într-o valoare de așteptare a lui X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Acum specificăm detaliile testului nostru, inclusiv numărul de qubiți și secvența de porți folosită în DD (în acest caz XX). Observă în special că setăm nivelul de optimizare la zero. În practică, adesea ai alege un nivel de optimizare mai ridicat; aici folosim nivelul 0 pentru a ne asigura că efectele erorilor vizate de DD rămân vizibile. În final, determinăm timpul caracteristic pentru porțile pe doi qubiți ale acestui backend și afișăm câteva timpi relevanți.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Acum construim circuitele noastre și le transpilăm pentru backend-ul ales.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
Ar trebui să vizualizăm cel puțin un circuit pentru a ne asigura că am codat circuitul cu stările și întârzierile dorite. Ar putea fi mai ușor să vizualizezi circuitul netranspilat qc, sau ai putea verifica cel transpilat qc_isa.
qc.draw("mpl")
Execuție
În sfârșit suntem gata să executăm pe hardware. Folosim Sampler pentru a obține multe măsurători ale fiecărui qubit și îl vom folosi de două ori: o dată cu DD dezactivat explicit, și o dată cu DD activat, folosind secvența de porți XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Putem extrage numărătorile din diferitele circuite.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Post-procesare
Acum avem numărătorile din măsurătoare, dar vrem să le transformăm în valoarea de așteptare a lui X și apoi să mediem acele valori de așteptare pentru toți qubiții folosiți, pentru a afla despre păstrarea informației de fază. Pentru asta folosim funcția noastră counts_to_x_expectations definită anterior.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
În final, să reprezentăm grafic rezultatele noastre.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
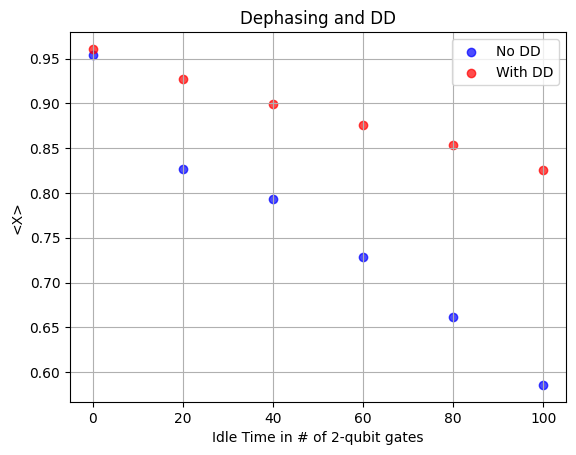
După cum poți vedea, fără întârziere explicită, valorile de așteptare sunt într-adevăr aproape de 1, ceea ce ne-am aștepta dacă toată informația de fază ar fi păstrată. Dacă toată informația de fază ar fi pierdută, nu ar exista nicio preferință ca rotația finală să producă mai degrabă decât , iar valoarea medie de așteptare s-ar apropia de zero. În date, vedem că, pe măsură ce timpii de întârziere cresc, valoarea medie de așteptare a lui X scade, apropiindu-se de zero. Observă că DD a fost foarte eficient aici; valorile de așteptare cu DD sunt de obicei cu peste 20% mai bune (mai aproape de 1) decât valorile fără DD. Dar observă și că primul punct de date întârziat corespunde unei întârzieri aproximativ echivalente cu 100 de operații de porți pe doi qubiți. Acest lucru întărește ideea că DD este cel mai util atunci când qubiții rămân inactivi perioade relativ lungi.
Verifică-ți înțelegerea
Dacă aplicăm DD folosind XY4 la același circuit ca înainte, te aștepți ca acesta să producă rezultate mult mai bune, mult mai proaste, sau aproximativ la fel, ca DD folosind XX? Explică.
Răspuns
Aproximativ la fel, poate puțin mai rău. Circuitul pe care l-am folosit avea stări rotite în planul XY. Această stare stochează informația în principal în faza sa, ceea ce o face deosebit de sensibilă la erorile de defazare mai degrabă decât la relaxarea T1. XY4 ar putea ajuta cu o varietate mai largă de erori, dar XX este deja optimizat pentru a ajuta circuitul pe care îl folosim. XY4 ar putea fi la fel de bun, dar nu ar adăuga nimic substanțial, sau faptul că XY4 conține mai multe porți ar putea permite erori suplimentare de porți care să facă rezultatele puțin mai proaste.
Ultimul rezultat a folosit cea mai simplă secvență de porți DD, XX. Să vedem cum să implementăm o secvență mai complexă, XY4. Definim un Sampler în secțiunea următoare.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
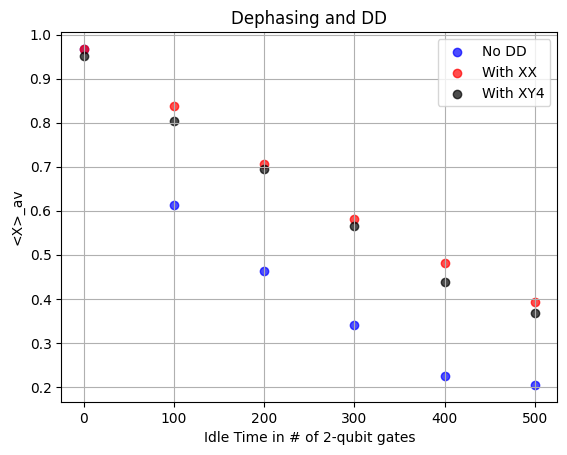
Aici vedem că XY4 nu este apreciabil diferit de XX. Ar putea fi puțin mai rău din cauza porților suplimentare din secvența XY4, dar mai important, am explicat deja de ce XX ar avea efectul dorit în păstrarea fazei, specific pentru o stare precum . Nu există niciun motiv să credem că, pentru o astfel de stare inițială, o secvență diferită ar îmbunătăți rezultatele.
Verifică-ți înțelegerea
Verifică faptul că secvența XY4 lasă starea neschimbată, până la o fază globală.
Răspuns
Pauli twirling
Ar trebui să începem prin a observa că Pauli twirling este adesea folosit nu ca tehnică de suprimare a erorilor, ci ca tehnică de modelare a erorilor: face ca zgomotul/erorile să se comporte diferit, uneori mai previzibil, pentru a permite alte metode. Deși Pauli twirling nu previne erorile, ar putea preveni acumularea lor coerentă.
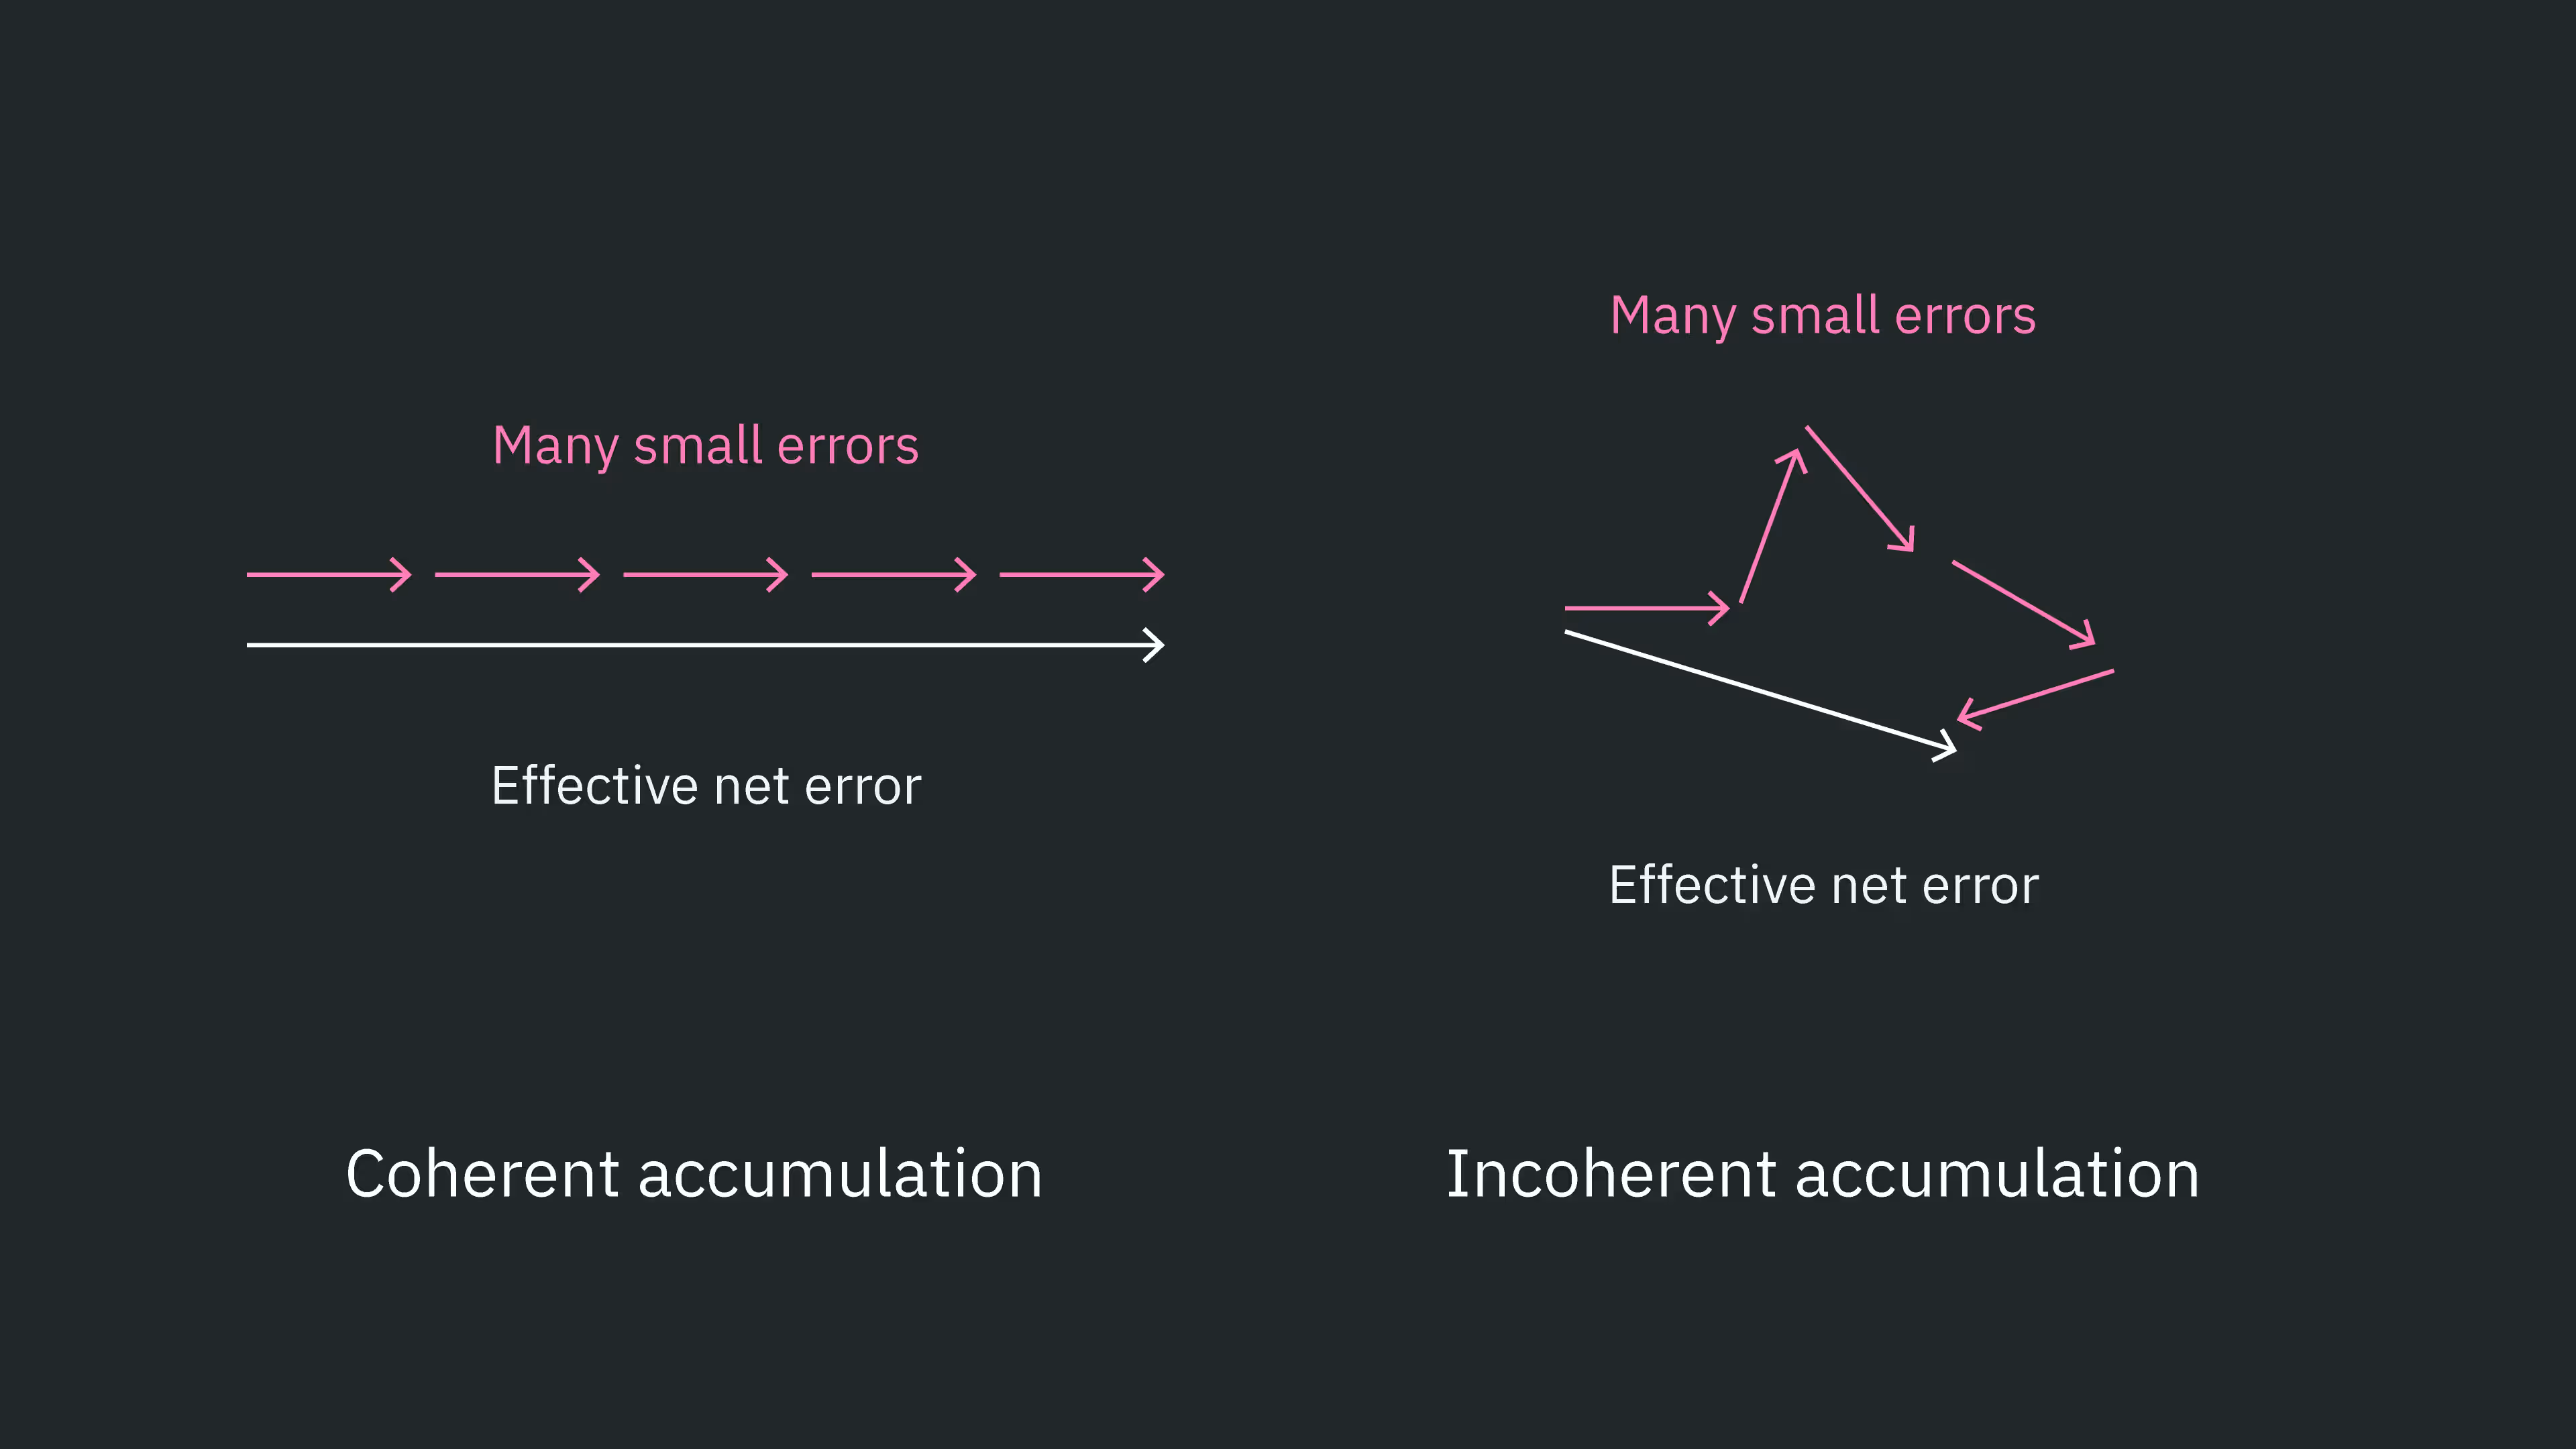
Într-un circuit cuantic, mai multe surse diferite de eroare se adună împreună. Erorile se pot aduna în moduri diferite, în special coerent și incoerent. Acumularea coerentă a erorilor înseamnă că zgomotul sau implementările imperfecte tind toate să conducă erorile în aceeași direcție, de-a lungul mai multor straturi și porți. Un exemplu ar fi supra-rotația coerentă atunci când se aplică o poartă de rotație.
Să considerăm o poartă de rotație ideală, precum , care rotește în jurul axei X cu exact . Desigur, implementarea porții nu este perfectă, iar rotația reală ar putea fi pentru o anumită implementare, și ar putea fi chiar cazul ca să aibă întotdeauna același semn și, posibil, o magnitudine similară în multe aplicări ale . Astfel, aplicarea repetată a porților de rotație poate rezulta în acumularea coerentă a acestor multe supra-rotații (sau sub-rotații), .
Acumularea incoerentă a erorilor este exact opusul: erori în direcții aleatorii cu semne aleatorii, astfel încât erorile din straturi diferite nu interferă întotdeauna aditiv, ci uneori se anulează sau se adună în cvadratură. În mod clar, erorile incoerente se acumulează mai lent în ceea ce privește efectul global asupra stării qubitului. O diagramă simplificată a acestui lucru este arătată în figura de mai jos. Aceasta este o simplificare. Erorile cuantice reale nu sunt restricționate la un spațiu cartezian bidimensional; nu toate contribuțiile de eroare vor avea aceeași magnitudine, și există mai multă complexitate. Dar intuiția unei astfel de imagini este utilă: erorile coerente tind să se acumuleze mai rapid decât cele incoerente.
Adesea se pot obține rezultate cu fidelitate mai mare transformând acumularea coerentă a erorilor în acumulare incoerentă a erorilor. O modalitate principală de a realiza acest lucru se numește Pauli twirling.
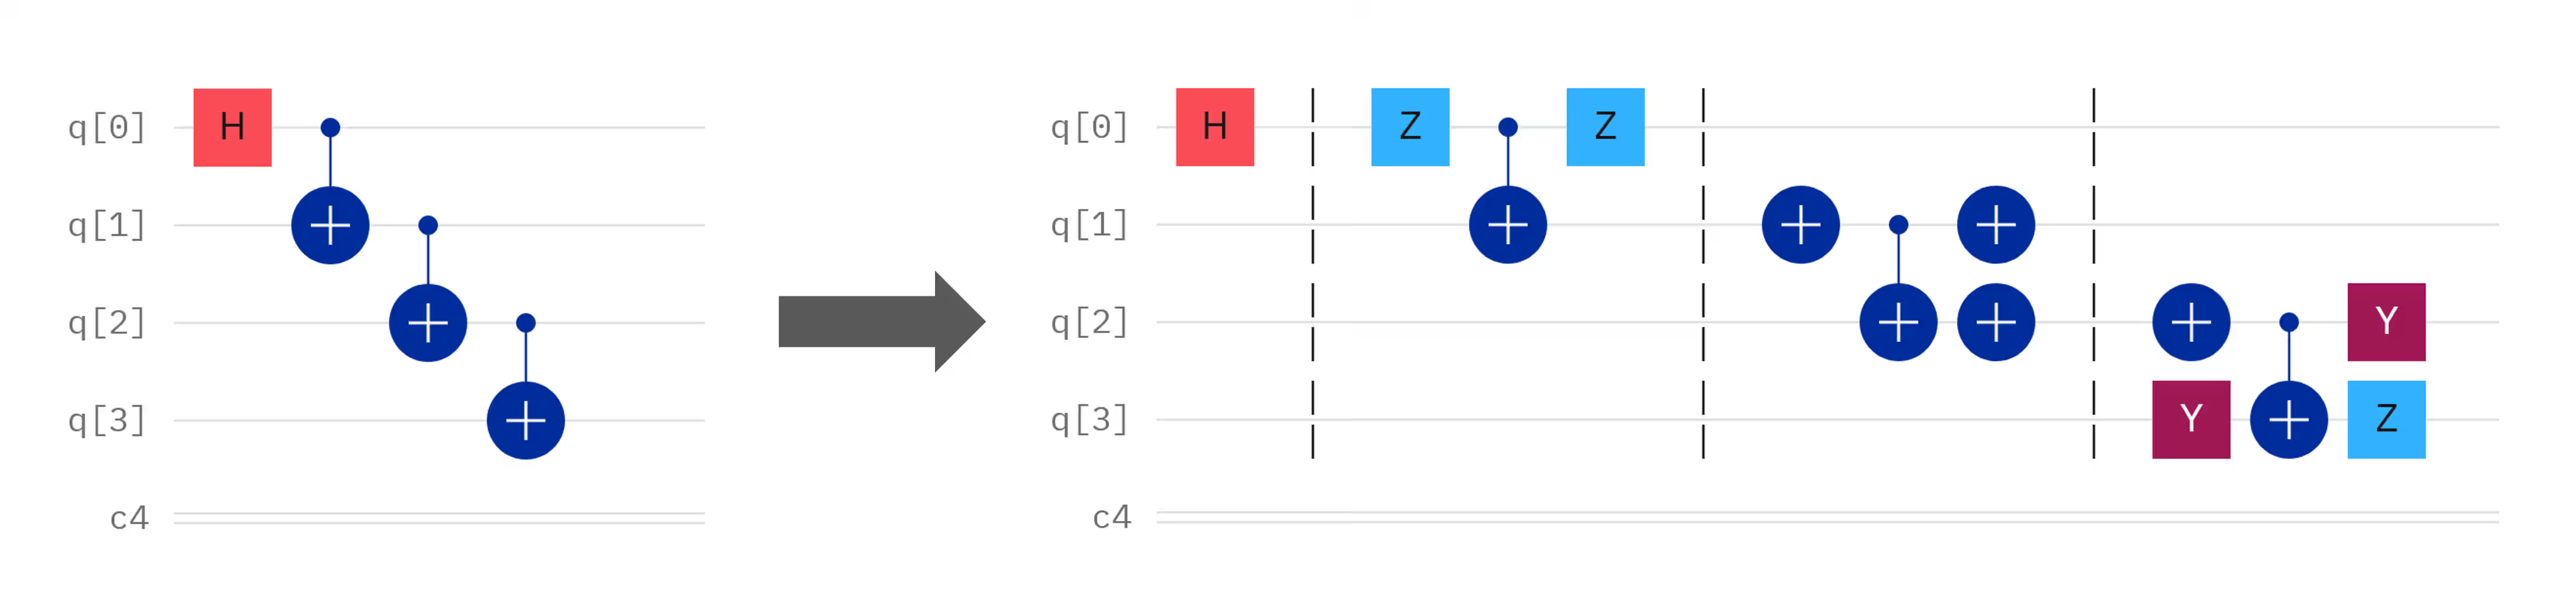
Pauli twirling se referă la adăugarea de combinații de porți Pauli înainte și după o operație de poartă dorită , astfel încât . Aici, și nu sunt Pauli individuale, ci colecții de operatori Pauli care acționează adesea pe mai mulți qubiți. Uneori poți vedea afirmația că acțiunea porților Pauli suplimentare este "echivalentă cu identitatea". Dar acest lucru este imprecis și potențial derutant. Porțile Pauli sunt separate de , iar scopul este de a lăsa acțiunea logică a tuturor porților egală cu . Uneori este numit "sarcina utilă" pentru a distinge această operație intenționată de porțile adăugate pentru suprimare. Câteva exemple de Pauli twirling în jurul unei porți CNOT sunt arătate mai jos.

Să parcurgem doar un exemplu pentru a verifica faptul că twirling lasă efectul logic al sarcinii utile neschimbat. Fără pierderea generalității, fie stările pe doi qubiți implicând și :
Ca întotdeauna, folosim convenția de ordonare a qubiților . Aplicarea unei porți CX cu ca țintă produce
Acum să considerăm al treilea circuit arătat, folosind porți X pentru Pauli twirling. Am putea pur și simplu să înmulțim matricele împreună și să verificăm dacă produc o matrice CNOT. Alternativ, putem urmări operația pe o stare cuantică arbitrară de-a lungul circuitului, așa cum facem mai jos. Stările din diferite puncte ale circuitului au fost etichetate a-d.

Aceasta este exact pe care am obținut-o înainte, fără twirling. Într-adevăr, această secvență de porți twirled lasă acțiunea logică a sarcinii utile neschimbată. Totuși, dacă diferite secvențe de twirling valide sunt selectate aleatoriu de la un strat la altul, acumularea coerentă a erorilor poate fi convertită în acumulare de erori efectiv stocastică (incoerentă). Pentru claritate, nu se alege un singur model de twirling care să fie folosit pe tot circuitul. În schimb, diferite secvențe de twirling valide sunt selectate pentru straturi diferite. Un exemplu cu multe straturi de întrepătrundere ar putea arăta astfel.
Verifică-ți înțelegerea
Verifică faptul că Pauli twirling din al patrulea panou din figura de mai sus lasă de asemenea neschimbat efectul logic al CNOT.
Răspuns
Urmăm exemplul de mai sus și arătăm că acțiunea asupra oricărei stări arbitrare pe doi qubiți este echivalentă cu o operație CNOT. Ne vom referi la punctele etichetate din această diagramă.

Acest lucru este echivalent cu acțiunea unui CNOT cu qubitul 0 ca și control și qubitul 1 ca țintă.
Poți veni cu o secvență de Pauli twirling pentru poarta CNOT care nu este arătată mai sus?
Răspuns
Da, există multe altele. Un exemplu este înainte de CNOT, și un și după CNOT.
Când să folosești Pauli twirling
Așa cum este prezentat aici, Pauli twirling este aplicat doar porților multi-qubit. Aplicarea unui protocol similar porților pe un singur qubit ar necesita o logică diferită și, în general, nu este util în practică. Pauli twirling în sine folosește mai multe porți pe un singur qubit (porțile Pauli). Porțile Pauli suplimentare ar introduce probabil mai multă eroare decât s-ar câștiga prin randomizarea oricărei acumulări coerente de erori. Ratele de eroare asociate porților pe doi qubiți sunt mult mai mari decât cele asociate porților pe un singur qubit. Mai mult, unele porți pe un singur qubit sunt non-Clifford, care nu pot fi complet twirled. De aceea Qiskit include opțiuni de Pauli twirling care aplică automat twirling în jurul porților pe doi qubiți, și nu în jurul porților pe un singur qubit.
Acest lucru a fost implicit în figura de mai sus: Pauli twirling a fost implementat în jurul porților CX, dar nu în jurul porții Hadamard.
Să vedem două exemple de Pauli twirling în acțiune.
Pauli twirling pentru suprimarea acumulării coerente
Pentru a observa cum poate Pauli twirling transforma acumularea coerentă a erorilor într-o acumulare incoerentă mai lentă, avem nevoie de un circuit și un observabil care funcționează ca un test de stres pentru erori coerente. Singurul scop este de a face vizibile erorile pe doi qubiți care se acumulează coerent, și apoi de a arăta cum Pauli twirling convertește acea acumulare coerentă într-o descreștere stocastică.
Porțile CNOT (sau CZ) sunt o sursă comună de erori coerente. Cel mai simplu experiment pe care îl putem face în acest caz este să inițializăm o stare (să zicem ), să aplicăm straturi de porți CNOT pereche (folosind faptul că două CNOT-uri produc o identitate), și să verificăm cum se acumulează erorile pe măsură ce numărul de straturi crește, atât cu cât și fără Pauli twirling.
Observabilul de interes este pe un singur qubit, pe care îl reprezentăm grafic în funcție de numărul de repetiții ale perechilor CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Deoarece am rotit baza înainte de măsurători, o măsurătoare a lui corespunde faptului că starea a fost în chiar înainte de poarta Hadamard finală, și similar pentru și . Prin urmare, valoarea noastră de așteptare poate fi calculată simplu din numărătorile lui minus numărătorile lui .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Selectăm un număr rezonabil de straturi CNOT pe care să permitem erorii să se acumuleze, construim circuitele noastre, apoi le transpilăm.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Ține minte că fiecare strat constă din mai mult de o poartă pe doi qubiți. Monitorizează adâncimea transpilată pe doi qubiți folosind funcția de mai jos.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Acum rulăm job-urile.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
În final, vizualizăm aceste rezultate.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
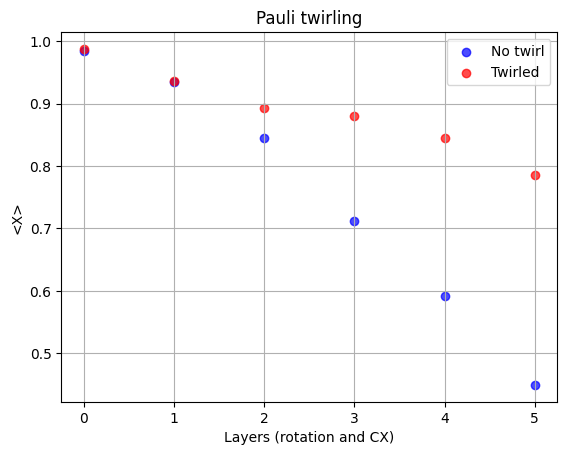
Putem vedea clar că circuitul twirled produce o valoare de așteptare mai apropiată de idealul . Acest exemplu și-a servit scopul, dar să trecem la ceva mai util: twirling în producerea stărilor puternic întrepătrunse.
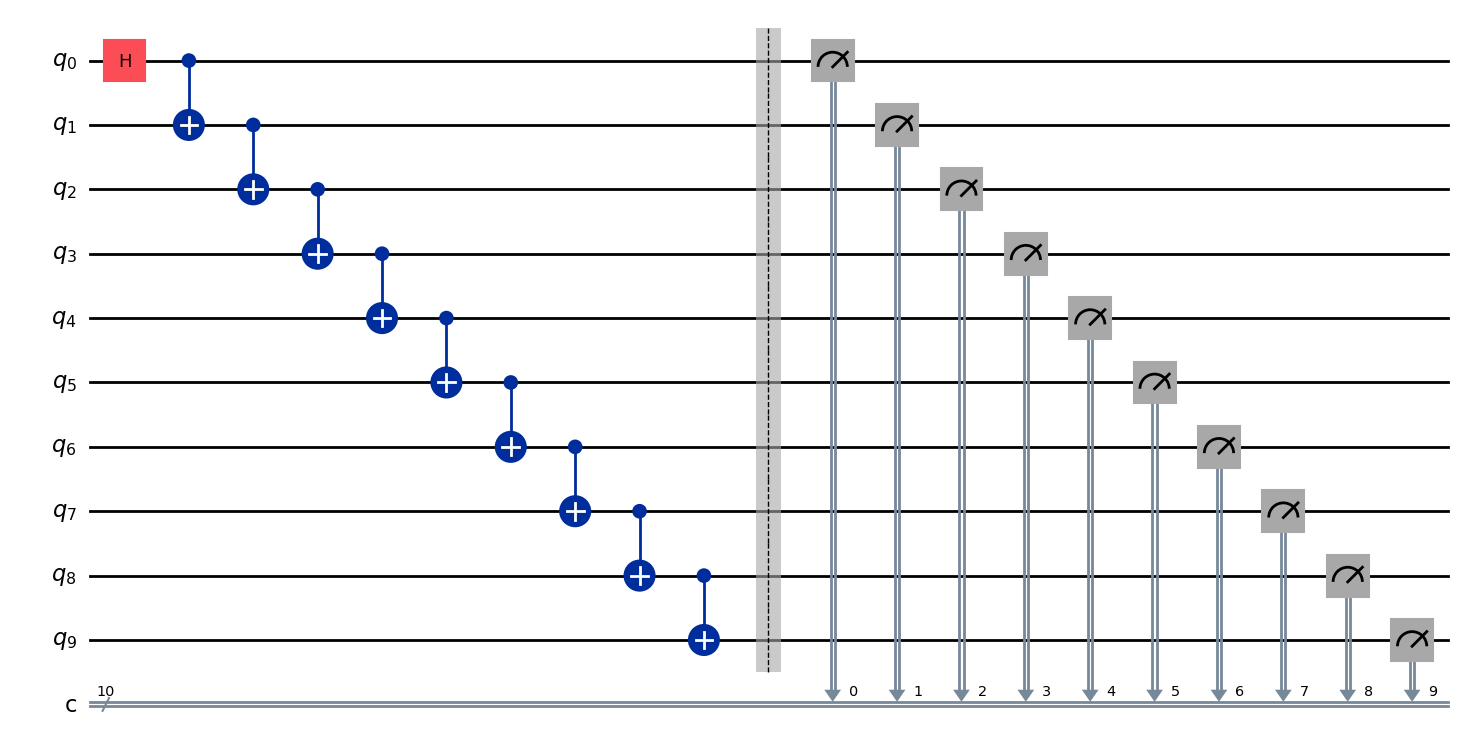
Pauli twirling în pregătirea stării GHZ
Exemplul anterior a arătat un caz convingător pentru Pauli twirling în distrugerea acumulării coerente a erorilor asociate porților CNOT. Producerea stării GHZ folosește multe porți CNOT pentru a produce stări puternic întrepătrunse, utile pentru multe aplicații de calcul cuantic. Să explorăm cum ajută Pauli twirling în acest context, cu stări GHZ de dimensiuni crescânde.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
Acum construim circuitele noastre și le transpilăm. În acest caz, nu avem porți repetate artificial care se reduc la identitate. Deci putem permite pass manager-ului să facă puțin mai multă optimizare pentru noi. O vom seta la nivelul trei.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Putem vedea că optimizatorul a mapat circuitul nostru abstract la qubiții 123, 124, 136, 142 și 143.
circuits[0].draw("mpl")
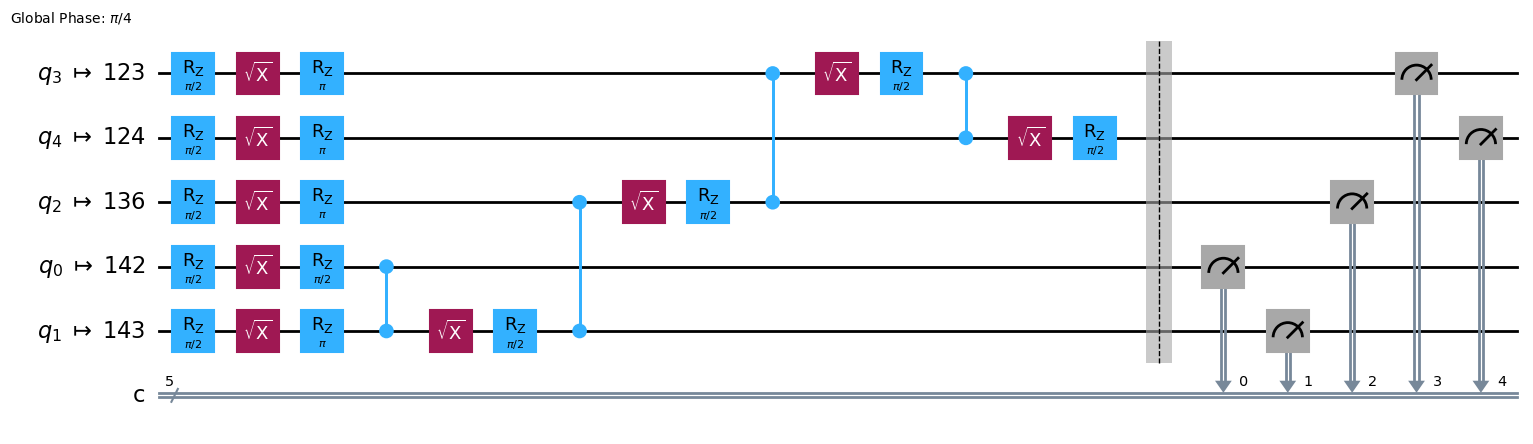
Pentru a înțelege de ce, să ne uităm la o hartă a dispunerii backend-ului nostru (în această imagine, ibm_fez, dar poți face analize echivalente pe orice backend).
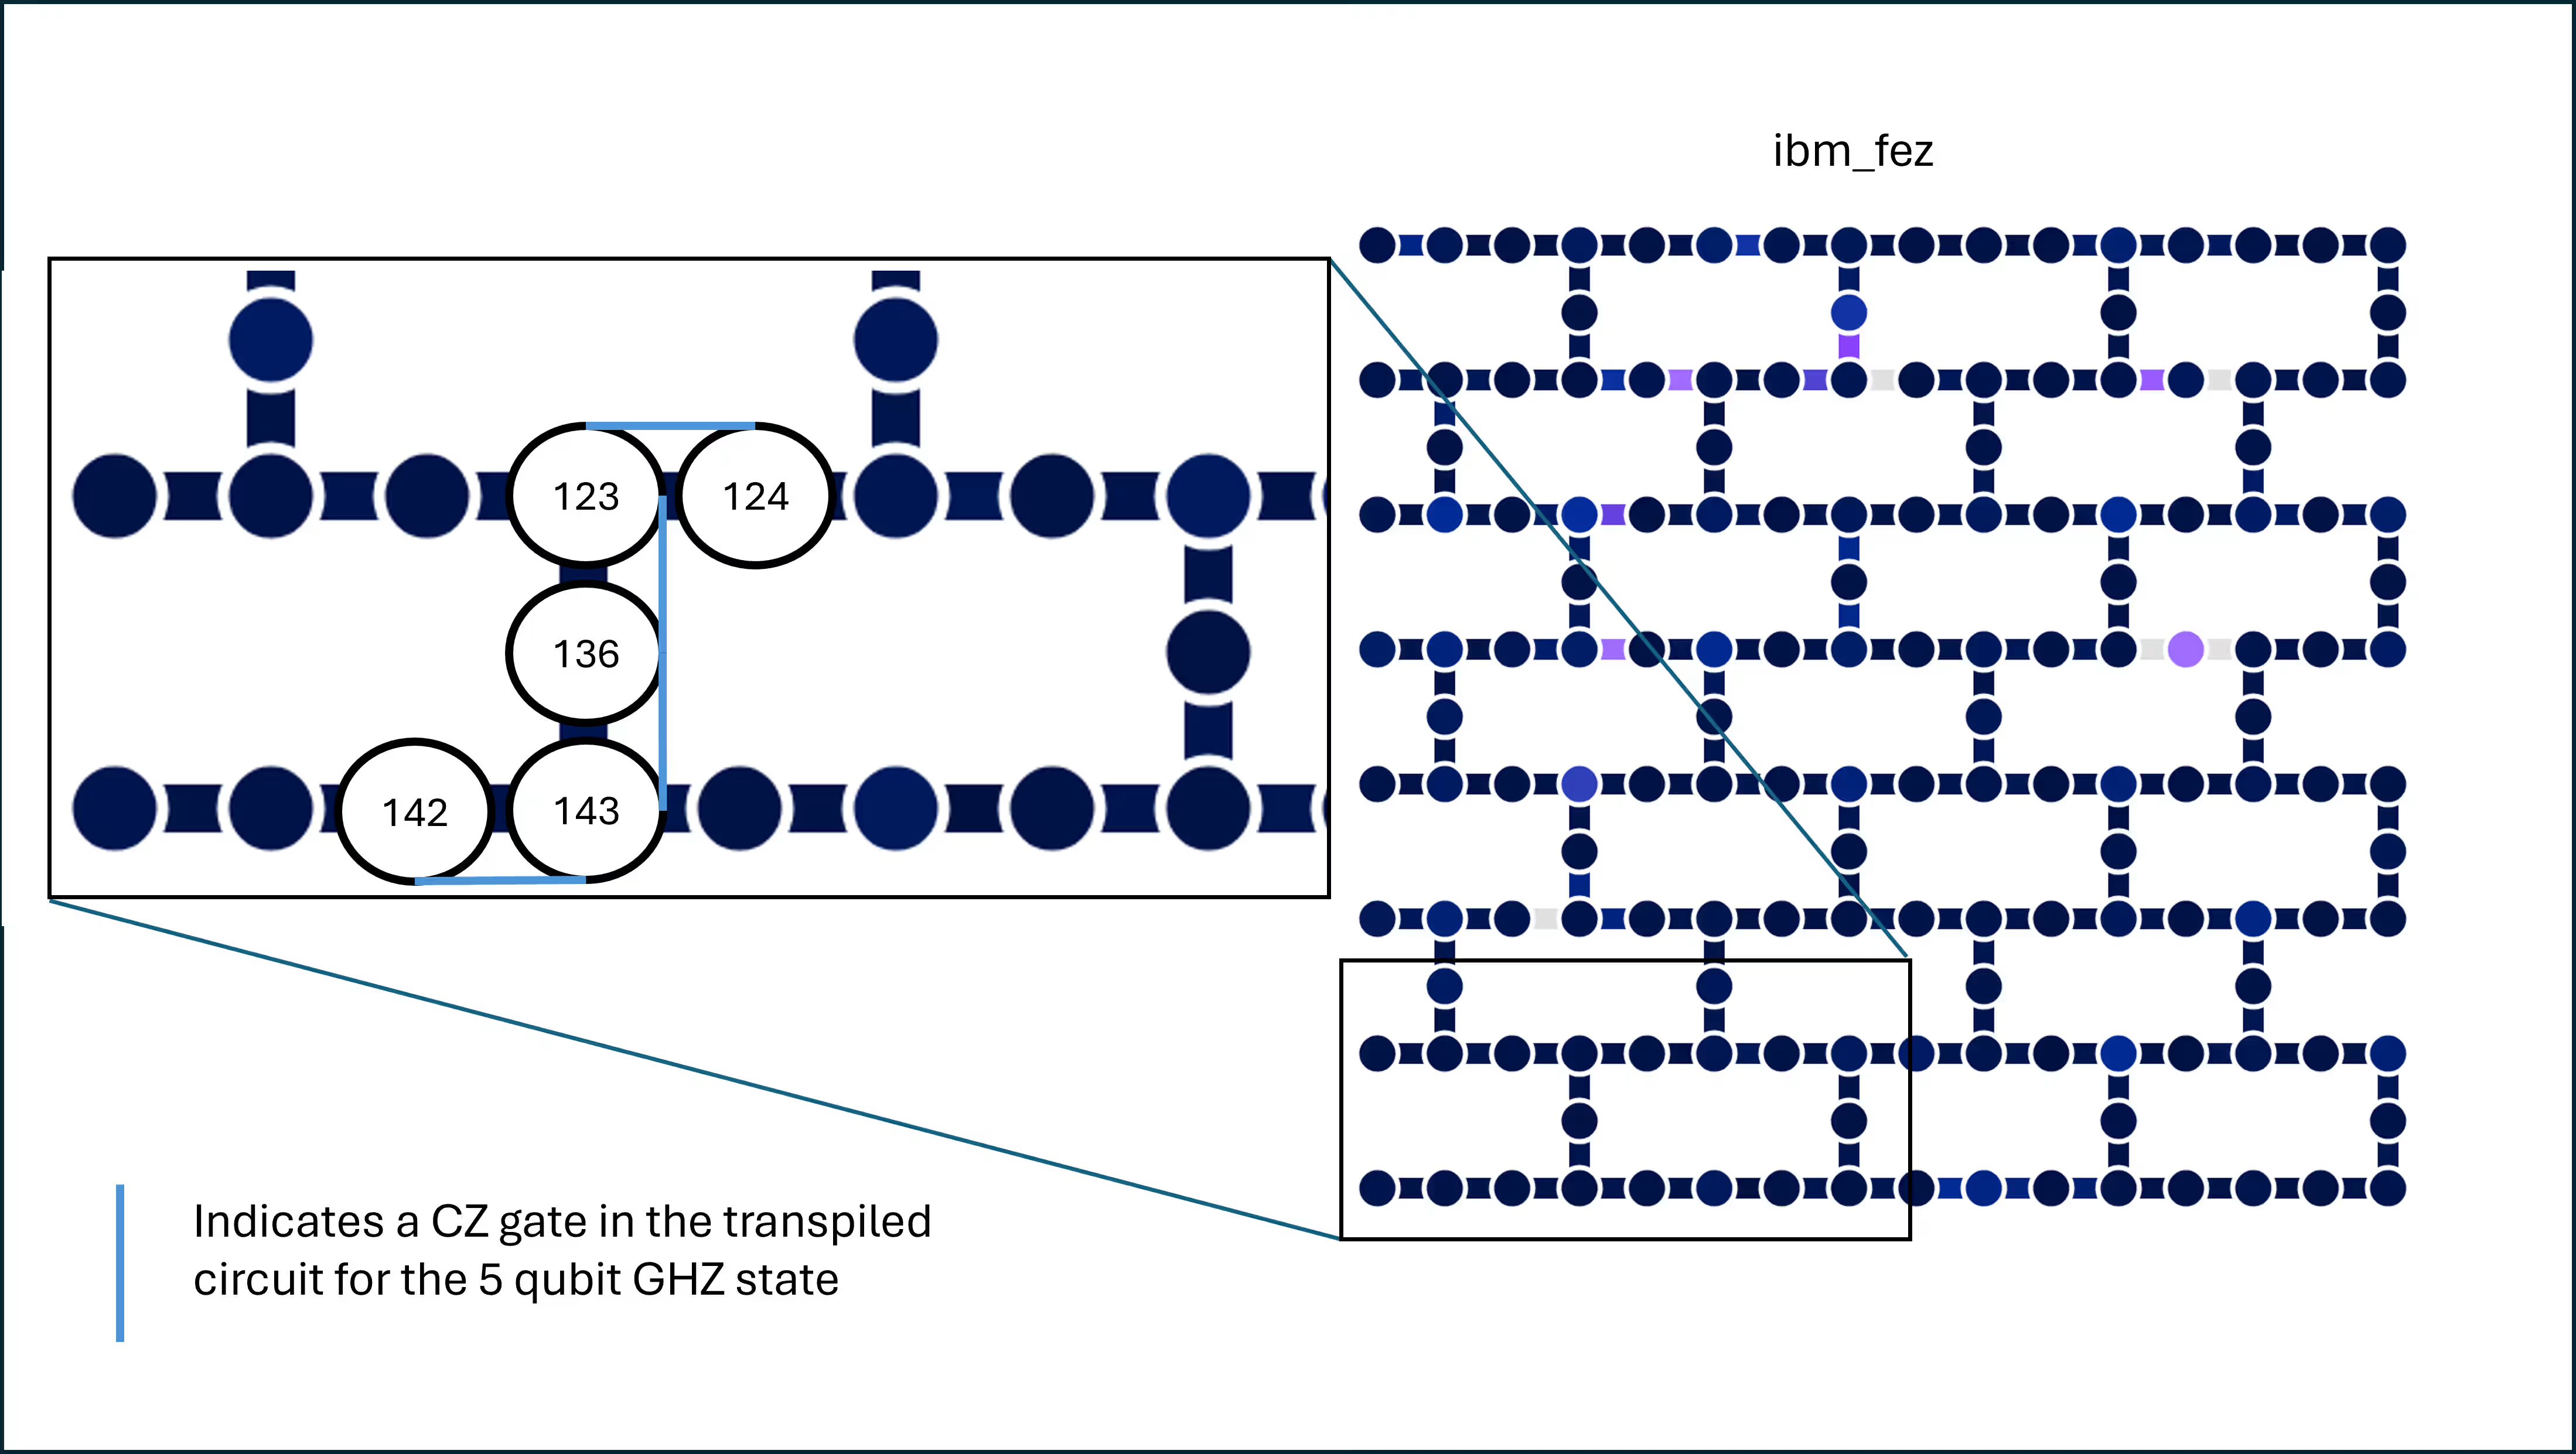
Vedem că qubiții au fost selectați într-un lanț pentru a minimiza porțile swap și astfel adâncimea circuitului. Mai mult, fiecare poartă CZ implementată în circuit este între qubiți adiacenți. În final, toți cei cinci qubiți au rate de eroare relativ scăzute, inclusiv ratele de eroare de atribuire la citire. Poți verifica aceste rate de eroare pentru orice backend pe pagina Resurse de calcul. Găsirea unei astfel de dispuneri nu este dificilă pentru un lanț liniar simplu, dar pe măsură ce problemele devin mai complexe, optimizarea dispunerii circuitului devine mai dificilă și mai valoroasă.
Acum configurăm primitiva noastră Sampler. Dezactivăm alte instrumente de suprimare/atenuare pentru a ne concentra pe Pauli twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
În final, rulăm job-urile noastre. Poți opțional afișa numerele ID ale job-urilor pentru recuperare ulterioară.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Extragem numărătorile fiecărei stări de bază computaționale măsurate pentru toate circuitele, atât cu cât și fără twirling.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Știm că distribuția ideală a unei stări GHZ este cea în care jumătate din shot-uri returnează , iar cealaltă jumătate returnează . Construiește-o pentru comparație.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Acum folosim fidelitatea Hellinger ca măsură a calității stării noastre finale.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
În final reprezentăm grafic rezultatele noastre.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
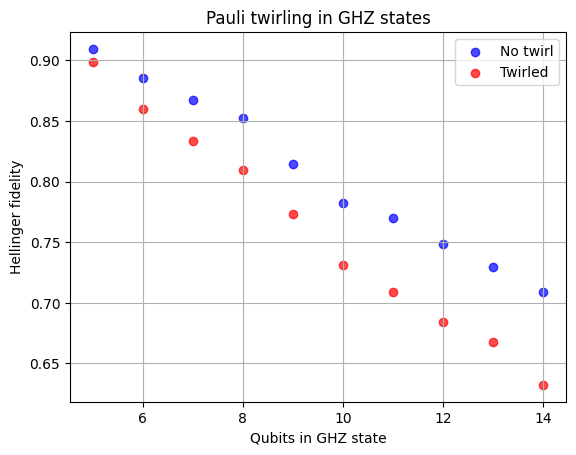
Rezultatele folosind Pauli twirling nu sunt mai bune (și chiar puțin mai proaste) decât fără twirling. Ce s-a întâmplat?
Două lucruri s-au întâmplat. În primul rând, Pauli twirling nu reduce cantitatea totală de zgomot — ci, mai degrabă, remodelează erorile coerente, sistematice, în erori stocastice de tip Pauli, astfel încât creșterea erorii devine previzibilă și modelabilă. Nu a existat niciodată vreo promisiune de reducere a erorii, cu excepția cazurilor speciale.
În al doilea rând, în circuitele GHZ, unele erori coerente se pot anula parțial sau pot acționa ca deplasări de fază benigne datorită simetriei construcției GHZ; twirling elimină această protecție accidentală și o înlocuiește cu zgomot Pauli stocastic necorelat, astfel încât fidelitatea GHZ devine puțin mai proastă sub twirling.
Această a doua afirmație necesită ceva explicație. Afirmația nu este că circuitele GHZ sunt protejate de toate tipurile de acumulare coerentă a erorilor, ci doar de unele tipuri — și că în acele cazuri protecția este distrusă de twirling. Mai precis, să considerăm supra-rotația coerentă asociată porților CX. Să numim poarta CX reală cu supra-rotație :
unde este orice produs de operatori Pauli, precum , , , , etc. Pentru stări generale, oricare dintre aceste supra-rotații ar putea afecta statisticile de măsurare (și deci măsurile fidelității stării). Un subset dintre acestea, totuși, lasă multe observabile GHZ standard neschimbate, inclusiv operatori precum și . În contextul preparării unei stări GHZ, erorile de supra-rotație relevante de acest tip ar fi:
Prepararea întregii stări GHZ cu qubiți ar arăta astfel:
După prepararea stării GHZ, starea este ideal:
Această stare este o stare proprie simultană a unui set larg de operatori Pauli, inclusiv următorii:
cu valoarea proprie . Ca rezultat, un operator de forma acționează asupra stării GHZ prin înmulțire cu factorul de fază , ceea ce nu afectează observabilele GHZ standard precum paritatea, colectiv, sau populațiile în baza computațională. Astfel, deși erorile de supra-rotație sunt coerente și sistematice, ele sunt practic invizibile pentru măsurătorile folosite pentru a evalua fidelitatea GHZ. În acest sens, circuitul GHZ beneficiază de o protecție de coerență accidentală: anumite erori CX coerente comută cu structura stării care este preparată și, prin urmare, nu degradează performanța măsurată.
Twirling-ul Pauli schimbă fundamental această situație. Twirling-ul nu păstrează eroarea de supra-rotație coerentă ca proces determinist . În schimb, el convertește canalul de eroare coerentă într-un canal Pauli stocastic efectiv. Ca rezultat, canalul de eroare include acum termeni precum , , și , care nu comută cu stabilizatorii GHZ.
Când apar aceste erori Pauli stocastice, ele creează defecte reale de bit-flip și phase-flip pe qubiți individuali sau perechi de qubiți. Aceste erori scot starea din subspațiul stabilizator GHZ, reduc interferența dintre și , și scad direct fidelitatea GHZ și semnalele de paritate multi-qubit. Cu alte cuvinte, twirling-ul Pauli elimină structura coerentă a erorii, dar elimină și anularea bazată pe simetrie care anterior făcea acele erori benigne. Rezultatul este o stare GHZ ușor mai slabă — nu pentru că twirling-ul adaugă zgomot, ci pentru că el convertește o eroare coerentă în mare parte inofensivă în erori stocastice cu adevărat dăunătoare.
Acest exemplu evidențiază o lecție importantă: twirling-ul Pauli nu este o strategie de îmbunătățire universală. Este cel mai benefic atunci când erorile coerente se acumulează într-un circuit într-un mod distructiv pentru fidelitatea necesară. În circuite foarte simetrice precum prepararea stării GHZ, unele erori coerente sunt aliniate în mod natural cu stabilizatorii stării, iar randomizarea lor deliberată poate elimina această protecție accidentală.
Combină metodele
În principiu, se poate combina twirling-ul Pauli cu decuplarea dinamică. Nu am folosit DD în acest caz din două motive: în primul rând, nu ar trebui să existe perioade de inactivitate extrem de lungi în acest circuit. În al doilea rând, stările GHZ nu stochează majoritatea informației lor în coerența de fază pe un singur qubit, în special dacă observăm fidelitatea doar în termeni de numărători de șiruri de biți, și nu în termeni de faza dintre șirurile de biți dorite și .
Dacă am extinde prepararea GHZ la 100+ qubiți, atunci întârzierile în măsurarea qubiților primi/timpurii ar putea fi într-adevăr suficient de lungi încât DD ar putea fi util. Acest lucru este valabil mai ales atunci când luăm în considerare adâncimea transpilată a circuitului.
Twirling Pauli în structura de ecou RTZ
Ultimul nostru exemplu de twirling Pauli în contextul reducerii acumulării erorilor coerente folosește un circuit cu straturi de combinații X-CZ-X-CZ. Aceasta este o secvență de porți bine cunoscută, folosită adesea pentru a anula termenii de eroare ZZ coerentă în porțile pe doi qubiți, chiar și fără twirling. Dar cu twirling, putem reduce sau randomiza alte forme de acumulare a erorii coerente.
Vom începe prin a defini o funcție pentru a construi circuite de tip RTZ cu un număr variabil de straturi.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Acum construim circuite cu straturi crescânde, până la o adâncime totală rezonabilă pe doi qubiți transpilată.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
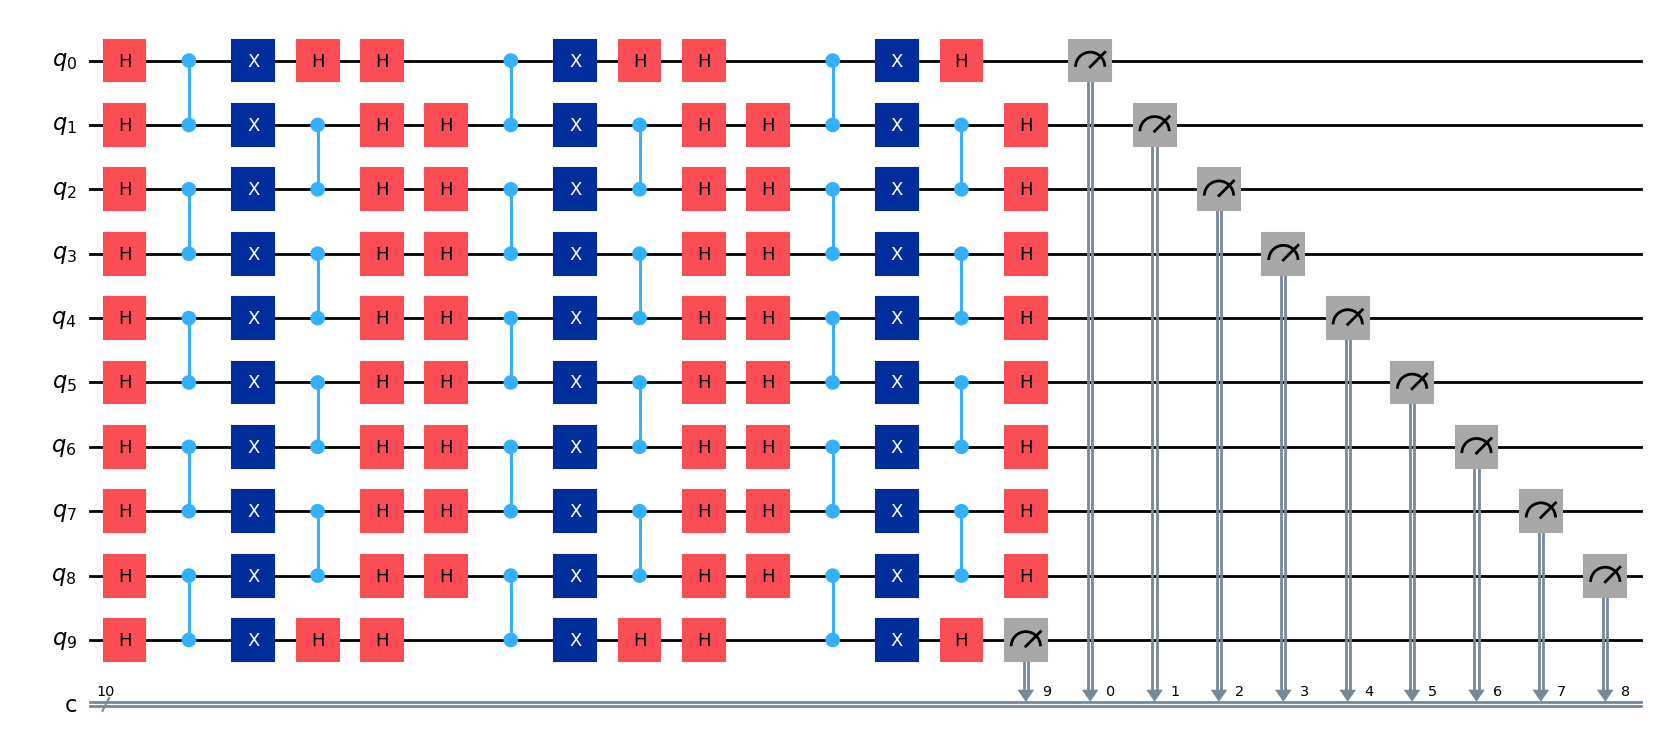
La capătul superior, unele dintre acestea sunt destul de adânci. Să folosim AerSimulator fără model de zgomot pentru a obține stările ideale la sfârșitul fiecăruia dintre aceste circuite. Putem apoi să comparăm rezultatele noastre de pe calculatoare cuantice reale folosind fidelitatea Hellinger.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Acum definim un SamplerV2 cu twirling, și unul fără twirling.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Acum rulăm job-urile noastre.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Obținem numărătorile din fiecare dintre rulările pe un calculator cuantic real.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Acum găsim fidelitatea Hellinger comparând fiecare dintre aceste rulări cu rezultatele AerSimulator fără zgomot.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Acum vizualizăm rezultatele noastre.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
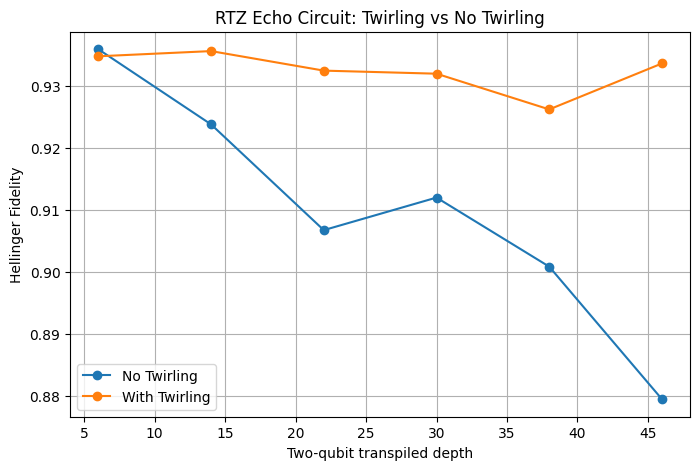
De-a lungul acestei lecții, am examinat cazuri în care twirling-ul Pauli este folosit pentru a limita acumularea erorii coerente, un context în care ar putea fi descris ca suprimare a erorii. Totuși, twirling-ul Pauli este adesea mai util ca instrument pentru remodelarea comportamentului erorii, convertind erorile coerente într-o formă mai predictibilă și mai ușor de modelat. Utilitatea acestui lucru va deveni mai evidentă în contextul tehnicilor de atenuare a erorilor precum extrapolarea la zgomot zero (ZNE), care se bazează pe o scalare a zgomotului rezonabil de predictibilă. Acest lucru este discutat în lecția următoare.