Simulează dinamica Bose-Hubbard cu o alegere a codificării
Acest ghid construiește un circuit pentru dinamica temporală a modelului Bose-Hubbard unidimensional, de la scrierea hamiltonianului până la verificarea densităților evoluate ale siturilor față de o referință exactă. Ceea ce face această abordare interesantă este o singură idee:
Nu alege o codificare boson-qubit atunci când construiești circuitul. Construiește circuitul pe moduri bosonice și lasă transpiler-ul să decidă cum devin aceste moduri qubiți.
Pentru bosoni, aproape întotdeauna trebuie să amâni codificarea. Un mod bosonic poate conține un număr arbitrar de particule, deci spațiul său Fock are dimensiune infinită și nu există nicio codificare până când nu alegi mai întâi o trunchiere (numărul de niveluri de ocupare pe care le păstrezi). În cod, trunchierea se dă ca ocuparea maximă pe care o poate avea un mod, max_occupation , astfel că un mod care păstrează nivelurile are max_occupation = 2 și .
Asta face din trunchiere un parametru al codificării, nu al fizicii, și este un parametru pe care vrei să îl variezi: prea mic și răspunsul este greșit, prea mare și circuitul este inutil de lat. Dacă amâni codificarea până la momentul transpilării, poți parcurge mai multe trunchieri fără a schimba circuitul, hamiltonianul sau gruparea.
Ghidul operatorilor pentru structura de date a operatorului, ghidul mapperelor pentru codificări și rețeta de scriere a unui mapper personalizat, și ghidul de transpilare pentru etapele transpiler-ului la care se face referire pe tot parcursul.
Trunchierea și ce costă
Când trunchiezi un mod la niveluri, rupi comutatorul canonic pe cel mai înalt nivel păstrat [1], deci nicio codificare nu este un izomorfism de algebre: o codificare bosonică mapează stări și operatori care acționează în interiorul subspațiului trunchiat. Două consecințe contează pentru tot ce urmează:
-
trebuie să limiteze ocuparea atinsă de dinamică, nu doar pe cea a stării inițiale.
-
Maparea nu comută cu ordonarea normală, așa că decide o dată dacă hamiltonianul tău este definit în formă normal ordonată și rămâi consecvent.
Ghidul mapperelor deduce defectul și arată ambele consecințe pe cod care rulează.
1. Hamiltonianul
Modelul Bose-Hubbard pe o rețea cu legături este
cu . Interacțiunea numără perechi de bosoni pe un sit, deci cere ca un sit să conțină două particule simultan. În formă normal ordonată, , care este forma folosită în continuare.
Geometria intervine doar prin lista de muchii, deci nimic nu este specific unui lanț:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Merită verificate mai întâi două proprietăți. Hamiltonianul trebuie să fie hermitian pentru ca să fie unitar și conservă numărul total de bosoni:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Acum întrebarea bosonică: câte niveluri cere acest operator?
>>> hamiltonian.max_occupation()
2
Termenul de interacțiune aplică doi operatori de creare pe un singur mod, deci un mod trebuie să poată conține doi bosoni pentru ca termenul să acționeze. Aceasta este o ocupare maximă de 2, numărul pe care LevelSpec îl primește ca max_occupation. Un mod care păstrează ocupările are niveluri, deci max_occupation >= 2 este aceeași cerință ca .
Aceasta este doar o limită inferioară: provine dintr-o singură aplicare a operatorului, iar aplicarea repetată pe parcursul unei evoluții în timp poate ajunge mai departe. Exclude tăieturile care sunt cu siguranță prea mici, iar pasul 6 stabilește, pentru acest model și această stare, cât de mare trebuie să fie tăietura. mode_occupations() raportează limita pentru fiecare mod separat, cu care se compară o tăietură per mod.
2. Grupează înainte de mapare
Evoluția este trotterizată, iar modul în care este partiționat hamiltonianul decide ce primește sinteza. Două considerente merg în aceeași direcție.
Primul, unul fizic: termenul individual de hopping nu este hermitian. Doar perechea este. Dacă evoluezi sub un singur termen nehermitian, operația nu este unitară, iar operatorul mapat ar avea coeficienți complecși pe care PauliEvolutionGate îi respinge. Cei doi termeni de hopping ai fiecărei legături trebuie deci să rămână împreună.
Al doilea, unul de eficiență: toți termenii de interacțiune on-site sunt diagonali în baza de ocupare și comută între ei, deci pot împărți un singur grup și pot fi sintetizați împreună. Același lucru este valabil pentru legăturile care nu ating niciun sit comun. Pe un lanț, fiecare a doua legătură formează o astfel de mulțime: legăturile 0 și 2 acționează pe perechi disjuncte de moduri, deci termenii lor de hopping comută și pot împărți un grup, iar legătura 1 formează un grup propriu. Dacă grupezi legăturile pare și impare, ai nevoie deci de trei grupuri, în timp ce un grup per legătură cere patru. Mai puține grupuri înseamnă mai puțini factori și, de asemenea, un circuit mai puțin adânc: cu codul Gray la max_occupation = 2, adâncimea cu două qubiți este 95 față de 139. Rețeaua decide care legături pot împărți un grup, motiv pentru care partiția este aleasă aici.
Atributul groups poartă această decizie în circuit: o poartă Evolution peste un operator grupat se descompune într-o sub-evoluție pentru fiecare grup. Partiția este aleasă la nivel bosonic, cât timp structura rețelei este încă vizibilă, și supraviețuiește neschimbată prin mapare. Ghidul de grupare tratează verificările pe care ar trebui să le treacă o grupare.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Fiecare grup trebuie să fie el însuși hermitian, lucru pe care îl asigură împerecherea anterioară. groups_are_hermitian() verifică toate grupurile într-un singur apel:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Pentru a vedea ce conține fiecare grup, separă grupurile:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
Gruparea pe legături pare și impare este o alegere, iar alternativa este ușor de măsurat. Dacă dai fiecărei legături un grup propriu, ai nevoie de patru grupuri, iar același circuit costă atunci mai multă adâncime cu două qubiți. Adâncimea este numărată după ce circuitul este coborât cu codul Gray la max_occupation = 2, ceea ce explică pasul 4:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. Circuitul bosonic
Observă ce lipsește din circuit. Nu există trunchiere, nu există codificare și nu există număr de qubiți. Acționează pe patru moduri bosonice:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Firele sunt moduri bosonice, nu qubiți. Observă că InitializeModes primește numere întregi, nu indicatori: un mod poate conține orice număr de bosoni, deci o stare Fock este o listă de numere de ocupare.
Un singur decompose() transformă gruparea din pasul 2 într-o poartă pentru fiecare grup:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
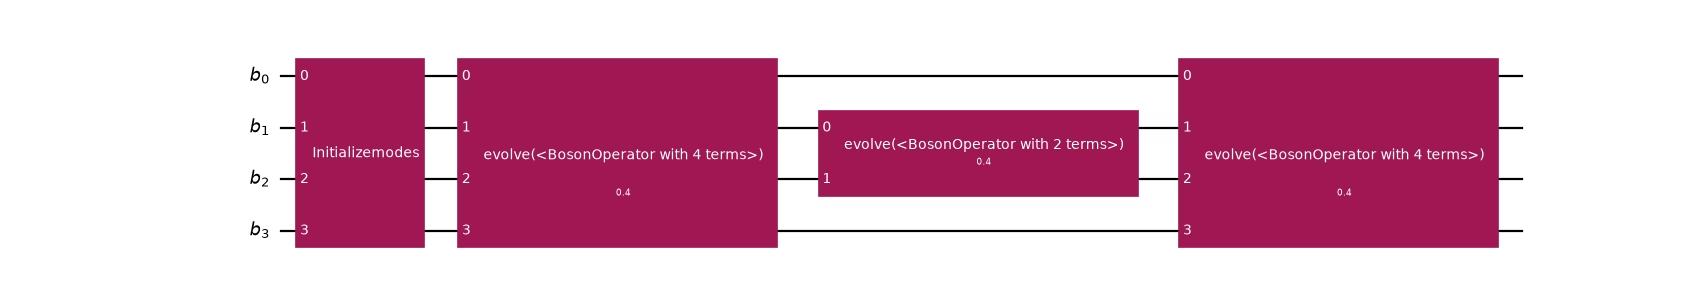
Primul grup conține legăturile pe modurile 0 și 1 și pe modurile 2 și 3, deci poarta sa acoperă toate cele patru moduri, la fel ca grupul on-site. Legătura din mijloc are o poartă proprie pe modurile 1 și 2.
Dacă omiți această descompunere, gruparea este pur și simplu ignorată. Metoda care face împărțirea este synthesis a porții, cu BosonicLieTrotter ca valoare implicită; Sintetizează o poartă Evolution în spațiu bosonic arată alternativele.
4. Alege codificarea la momentul transpilării
Iată câștigul. Același circuit este coborât de patru ori, sub patru valori diferite LevelEncoding, schimbând un singur argument. Un LevelSpec asociază codificarea cu trunchierea fiecărui mod, iar presetul următor derivă aranjamentul, pregătirea stării și maparea operatorului din acea unică specificație (vezi Descrie trunchierea cu un LevelSpec). Un șir precum "gray" este acceptat oriunde este acceptat un LevelEncoding.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Aceste numere contrazic o presupunere naturală. Codificările unare folosesc qubiți per mod față de pentru codurile compacte, iar la codurile compacte câștigă simultan pe ambele axe: mai puțini qubiți și mult mai puține porți de încâlcire. Cele două variante unare diferă prin operatorul pe care îl emit, nu prin aranjament: LevelEncoding.UNARY_PROJECTED poartă un proiector pe fiecare al doilea qubit al unui mod, ceea ce îl face cel mai costisitor dintre cele patru de evoluat, iar LevelEncoding.UNARY_UNPROJECTED omite proiectorii și este de acord cu el pe subspațiul one-hot. Ghidul mapperelor arată cei doi operatori alături și explică de ce codul Gray bate binarul standard (SB) la termenii de hopping.
Sawaya et al. raportează aceeași ordine [2]:
deși codul unar tinde să necesite mai mulți qubiți, dar mai puține operații, adesea codul SB sau Gray este mai eficient atât ca număr de qubiți, cât și ca număr de operații
Concluzia lor este că cel mai bun cod depinde de hamiltonian și de , ceea ce este cel mai puternic argument pentru a nu fixa alegerea în circuit.
Sub o codificare pe niveluri, un mod acoperă mai mulți qubiți, deci registrul de qubiți este mai lat decât registrul de moduri. Presetul folosește OccupationB2QLayout, care derivă lățimea registrului din LevelSpec. Ghidul de transpilare parcurge etapele pe care le rulează presetul.
5. Verifică față de dinamica exactă
Niciunul dintre pașii anteriori nu stabilește că circuitul este corect. Pentru aceasta, compară densitățile siturilor după evoluție cu o referință exactă calculată pe hamiltonianul codificat.
Referința trebuie calculată în același spațiu trunchiat în care lucrează circuitul, deoarece compararea cu un calcul netrunchiat ar amesteca eroarea Trotter cu eroarea de trunchiere, care sunt lucruri diferite și merită separate (vezi Trunchiază spațiul Fock).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Cu acestea pregătite, evoluția exactă în spațiul trunchiat:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Bosonii se răspândesc de la capătul ocupat al lanțului spre cel gol, iar cei doi bosoni se conservă:
>>> bool(np.isclose(sum(reference), 2.0))
True
Acum circuitul. Observă că referința anterioară a fost construită direct din initial, deci circuitul comparat cu ea trebuie să conțină doar evoluția, deoarece poarta InitializeModes ar pregăti din nou o stare deja pregătită.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
Eroarea se înjumătățește când numărul de pași se dublează, ceea ce este semnătura a unei formule de produs de ordinul întâi. Aceasta este dovada că discrepanța este eroare Trotter și că codificarea este fidelă.
Repetările provin din synthesis a porții, care trotterizează în spațiul bosonic, unde gruparea încă există: fiecare pas aplică fiecare grup o dată, iar pașii se succed. Acest lucru este diferit de a da un LieTrotter cu reps > 1 pluginului de sinteză la nivel de qubit. Acolo, fiecare grup este deja propriul său PauliEvolutionGate, deci formula doar subdivide termenii dintr-un grup și nu intercalează niciodată grupurile. Grupurile nu comută între ele, deci rămâne un singur pas Trotter exterior a cărui eroare nu scade oricât de mare ar fi reps. Sintetizează o poartă Evolution în spațiu bosonic le compară pe cele două și tratează ordinele superioare.
Apelul anterior decompose() este esențial. evolve() folosește definiția exactă a unui PauliEvolutionGate și ocolește complet formula de produs. Dacă verifici pe un circuit nedescompus, vezi o concordanță aproape perfectă chiar și pentru o sinteză greșită în mod deliberat. Circuitul nedescompus forțează, de asemenea, construirea unui operator dens , în timp ce un circuit descompus aplică porțile pe rând. Alte simulatoare pot trata poarta diferit, deci această verificare depinde de simulator, în timp ce hardware-ul necesită întotdeauna forma descompusă.
În sfârșit, verificarea centrală: fizica nu trebuie să depindă de codificarea aleasă.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Numerele de qubiți, structurile Pauli și adâncimile circuitelor diferă toate, iar fizica concordă până la zece zecimale. Codificarea este o alegere de implementare, motiv pentru care aparține transpiler-ului. Cele două variante unare concordă aici deoarece starea simulată rămâne pe subspațiul one-hot; în afara lui ar diferi.
6. Trunchierea este un parametru de convergență
Ultimul pas este specific bosonilor. Până acum totul a fixat max_occupation = 2, adică . Totuși, trunchierea nu este o alegere liberă: este un parametru de convergență, iar un răspuns este de încredere doar după ce încetează să se mai miște (vezi Trunchiază spațiul Fock).
Circuitul nu poartă nicio trunchiere, deci circuitul în sine nu se schimbă când se schimbă tăietura: se repetă doar transpilarea. Ceea ce se schimbă este dimensiunea rezultatului, iar o parcurgere este atât de ieftină aici doar pentru că sistemul este minuscul. Referința următoare este o simulare clasică exactă a dinamicii trunchiate, ceea ce este posibil pentru patru situri și crește exponențial cu numărul de qubiți. Pentru o problemă dincolo de această limită nu există referință exactă cu care să compari, iar convergența trebuie judecată prin alte mijloace.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
La max_occupation = 1 () fiecare sit conține cel mult un boson, deci termenul de interacțiune, care cere doi pe un sit, nu poate acționa deloc, iar densitățile sunt greșite cu aproximativ . Când adaugi al treilea nivel, rezultatul surprinde interacțiunea, iar de la max_occupation = 3 în sus rezultatul este staționar până la precizia mașinii: a convergit.
Motivul pentru care se oprește la max_occupation = 2 este numărul de particule. Hamiltonianul conservă numărul de bosoni, iar această stare conține doi, deci niciun sit nu poate conține vreodată mai mult de doi, indiferent de timpul de evoluție și de faptul că interacțiunea este repulsivă sau atractivă. Dacă evoluezi până la în loc de sau inversezi semnul lui , densitățile la max_occupation = 2 și mai sus rămân neschimbate până la .
Ceea ce ridică într-adevăr cerința este numărul de bosoni. Trei bosoni pe același lanț se schimbă cu aproximativ între max_occupation = 2 și 3 după aceeași evoluție scurtă și cu aproximativ după . Aceasta este o afirmație despre acest model și o mărime conservată și este o limită doar pentru operatorii care conservă numărul de particule; nu este o regulă generală, deci tăietura trebuie parcursă sistematic, nu ghicită.
Parcurgerea are un preț și pe partea circuitului, pe care referința exactă nu îl arată. Același circuit bosonic, coborât cu codul Gray la fiecare tăietură:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Fiecare nivel suplimentar costă adâncime, iar numărul de qubiți crește brusc ori de câte ori trece de o putere a lui doi. Când convergi în , schimbi deci acuratețe pe dimensiunea circuitului, așa că parcurgerea este mai mult decât o verificare numerică.
Observă, de asemenea, că faptul că este aproape corect este o coincidență a observabilei: densitățile siturilor abia se mișcă, în timp ce starea de bază este calitativ greșită (nu are componentă dublu ocupată). Dacă o observabilă converge, asta nu arată că alta a convergit.
Ce să reții
-
Codificarea este o chestiune a transpilatorului. Circuitul bosonic din pasul 3 nu menționează nicio trunchiere, nicio codificare și niciun număr de qubiți. Patru codificări l-au coborât apoi în patru circuite diferite, toate reproducând aceeași fizică. Nimic în amonte de transpilator nu a trebuit schimbat.
-
Pentru bosoni, asta nu este doar comod. Trunchierea este un parametru de convergență care trebuie variat sistematic, iar el se află în interiorul codificării. Un circuit construit pentru o codificare fixă ar trebui reconstruit pentru fiecare valoare a lui .
-
Grupează înainte de mapare și grupează pentru hermiticitate. Un singur termen de salt nu este hermitian și nu poate fi exponențiat; perechea de legătură din mână este hermitiană și deci poate fi exponențiată. Decide partiția la nivel bosonic, unde rețeaua este încă vizibilă. Acest lucru este fizic necesar, iar atributul
groupsexistă pentru a transmite decizia mai departe. -
Nu presupune că și codificarea cu pondere mică este cea ieftină. Pentru , codurile compacte le întrec pe ambele variante unare simultan în privința qubiților și a porților, iar varianta proiectată este cea mai costisitoare dintre toate. Măsoară; punctul de încrucișare depinde de .
-
Trunchierea strică algebra, într-un mod cuantificabil. Doar pe cel mai de sus nivel păstrat, cu . Tocmai de aceea maparea nu comută cu ordonarea normală.
Pașii următori
Două direcții extind acest exemplu. Dacă înlocuiești lista de muchii a lanțului cu legăturile unei rețele pătrate, nu ai nevoie de nicio altă modificare, deoarece funcția bose_hubbard definită mai devreme este deja independentă de geometrie. O codificare personalizată proprie (de exemplu un cod unar pe blocuri, care interpolează între unar și compact) se conectează de asemenea prin același punct de extensie MapperFnEvolutionSynthesis pe care îl folosește presetul.
-
Principiile de proiectare ale reprezentărilor operatorilor explică structura de date a operatorului din spatele Hamiltonianului.
-
Maparea reprezentărilor operatorilor tratează codificările și scrierea propriului mapper.
-
Transpilarea circuitelor bosonice parcurge etapele pe care le execută presetul.
-
Sinteza unei porți Evolution în spațiul bosonic arată cum se reduce eroarea Trotter în spațiul bosonic.
Fiecare adâncime raportată este pe un registru abstract, complet conectat. Maparea pe conectivitatea hardware reală este o etapă separată, iar blocurile de qubiți per mod ale unei codificări de ocupare oferă unui router o structură destul de diferită față de un qubit per mod.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.